
Hadoop概括——学习笔记<一>转
前言
第一章主要讲的是hadoop基础知识。老师讲的还是比较全面简单的,起码作为一个非专业码农以及数据库管理人员,也能狗大致了解其特点
首先是概括图(以hadoop2.0为例) 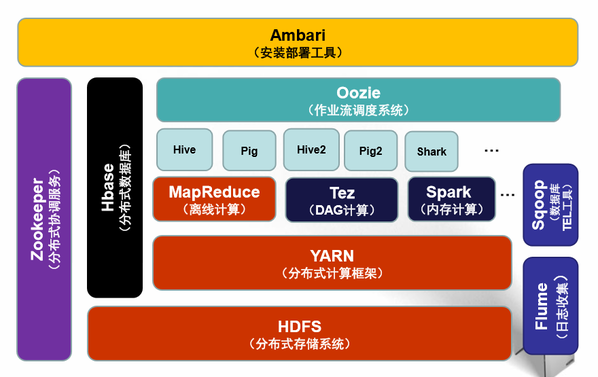
一、Hadoop基础架构:
HDFS(分布式存储层,主要储存数据)
YARN(集群资源管理层)
MapReduce 分布式数据处理,java
HDFS为最基本的,分布式文件系统
Redundant, Reliable Storage
它可扩展性好,资源不够时再买服务器就可以直接集成了。另外数据重分布也很方便,对服务器崩溃等等处理也及时。
其会把如1G等大文件,会冗余均等储存在多个服务器上(即使一个服务器崩溃了也无所谓),其过程均在后台处理而用户体验不到。
YARN负责集群管理调度
Cluster Resource Management
它兼容多个计算框架(spark/mapreduce等等),可以统一管理调度多个应用程序
另外,对多用户管理方便(可以方便分配用户资源等等)
基本是数据库管理者调度资源等用的
MapReduce是计算框架的一种
依然方便扩展,适合数据离线处理
里面涉及几个框架图,有空看看这些框架图可以更了解他们的架构与应用原理。
二、Hadoop具体模块解析(应用层)
Hadoop1.0
Hive 数据仓库 与sql整合
Pig 流行引擎
Mahout 数据挖掘库
–>Oozie 可以调度上述三种作业,先后处理什么作业,设定执行作业
–>Hbase 构建了hdfs之上的分布式数据库
–>数据引用 flume sqoop
协调服务zookeeper
Hadoop2.0
增加了YARN(计算框架)
预装了新一代软件 hive2 pig2等等
Hive: 日志数据处理,数据仓库
可以把sql语句转化为MapReduce语句
与数据库进行接口,作为一个类似于SQL的查询语言,使我们不用直接编写程序调用HDFS数据
它一般用于离线数据处理,而不是交互性数据处理。
一般用于:
1)日志分析(如pv uv):百度、淘宝
2)多维度数据分析
3)海量结构化数据李贤分析
4)低成本进行海量数据分析,不用专门学习MapReduce(简称MR)
Pig: 数据流语言,也是基于MapReduce
sql表达能力过于有限,不够直观。因此对于adhoc的数据分析不够。定义了新的pig Latin语言
也是用于离线数据分析
(PPT里对比了单词分组的MapReduce/hive/pig的案例)
感觉pig更像一个对象式编程,还可以自编写函数。而hive结构型数据处理转换成本更低(sql),大公司还是在用它居多
Mahout: 提供数据挖掘库
包括推荐、聚类、分类三大算法。
反正常用的数据挖掘算法都有了。
HBase:分布式数据库
有表的概念
但是Hbase会有版本、时间戳概念,就是如果新数据进来插入,不会覆盖原来的cell,而是储存在时间戳里(每一行数据)通过版本号数量限制可限定储存的版本数
另外有column family,可以由任意column组成(适合变量)
Zookeeper:用于解决分布式环境下数据管理问题
用户不会直接使用这个系统,而是底层系统用zookeeper解决资源配置问题,包括HDFS/HBase/YARN等
阿里巴巴也开发了使用Zookeeper,Dubbo/Metaq
Sqoop:数据同步工具
就是把Hadoop跟传统mysql,db2等数据库结合
属于基于MapReduce的一个程序
Flume:日志收集系统
与Sqoop类似,用于把日志导入hadoop里面
可以把网站使用的数据统一加载到HDFS里(加载基于Flume的客户端)agent-collector-HDFS
涉及客户端内容。(ATM采集信息等集群)
Oozie:用于调度不同的作业之间的管理与调度
对于有前后关系的、需要周期性定期性执行的工具进行调度甚至监控报警(邮件、短信报警)
转自 http://www.flybi.net/blog/weibaar/2969
Hadoop概括——学习笔记<一>转的更多相关文章
- Hadoop概括——学习笔记<一>
之前有幸在MOOC学院抽中小象学院hadoop体验课. 这是小象学院hadoop2.X概述第一章的笔记 第一章主要讲的是hadoop基础知识.老师讲的还是比较全面简单的,起码作为一个非专业码农以及数据 ...
- Hadoop入门学习笔记---part4
紧接着<Hadoop入门学习笔记---part3>中的继续了解如何用java在程序中操作HDFS. 众所周知,对文件的操作无非是创建,查看,下载,删除.下面我们就开始应用java程序进行操 ...
- Hadoop入门学习笔记---part3
2015年元旦,好好学习,天天向上.良好的开端是成功的一半,任何学习都不能中断,只有坚持才会出结果.继续学习Hadoop.冰冻三尺,非一日之寒! 经过Hadoop的伪分布集群环境的搭建,基本对Hado ...
- Hadoop入门学习笔记---part2
在<Hadoop入门学习笔记---part1>中感觉自己虽然总结的比较详细,但是始终感觉有点凌乱.不够系统化,不够简洁.经过自己的推敲和总结,现在在此处概括性的总结一下,认为在准备搭建ha ...
- Hadoop入门学习笔记---part1
随着毕业设计的进行,大学四年正式进入尾声.任你玩四年的大学的最后一次作业最后在激烈的选题中尘埃落定.无论选择了怎样的选题,无论最后的结果是怎样的,对于大学里面的这最后一份作业,也希望自己能够尽心尽力, ...
- Hadoop入门学习笔记(一)
Week2 学习笔记 Hadoop核心组件 Hadoop HDFS(分布式文件存储系统):解决海量数据存储 Hadoop YARN(集群资源管理和任务调度框架):解决资源任务调度 Hadoop Map ...
- Hadoop入门学习笔记总结系列文章导航
一.为何要学习Hadoop? 这是一个信息爆炸的时代.经过数十年的积累,很多企业都聚集了大量的数据.这些数据也是企业的核心财富之一,怎样从累积的数据里寻找价值,变废为宝炼数成金成为当务之急.但数据增长 ...
- hadoop spark学习笔记
http://www.csdn.net/article/2015-06-08/2824889 hive:是基于Hadoop的一个数据仓库工具,可以将结构化的数据文件映射为一张数据库表,并提供简单的sq ...
- 智传播客hadoop视频学习笔记(共2天)
第一天:1.答疑解惑• 就业前景• 学习hadoop要有什么基础• hadoop会像塞班一样,热一阵子吗• hadoop学习起来容易还是困难• 课堂上的学习方法(所有实验必须按照要求做,重原 ...
随机推荐
- EasyUI--初学
首先的是配置: 在WebContent下导入jQuery-EasyUI包 其次在HTML或jsp页面的<head></head>标签中,导入或引用js包 <head> ...
- MS16-016 提权EXP
测试环境 win7 32 位未打任何补丁 1.使用net user 指令 测试得到结果没有权限新建用户 2.查看系统用户 3.复制EXP到win7 下 使用命令打开 添加新用户再查看用户列表
- SQL疑难杂症【3】链接服务器提示"无法启动分布式事物"
今天接到用户反馈,应用系统出现异常,无法正常使用,于是用Profiler跟踪了一下语句,发现执行的存储过程中调用了链接服务器,做了一些跨服务器操作数据的动作,刚好就是这个链接服务器出错了,错误截图如下 ...
- Codeforces Round #375 (Div. 2) D. Lakes in Berland dfs
D. Lakes in Berland time limit per test 2 seconds memory limit per test 256 megabytes input standard ...
- js的事件处理程序
js事件处理程序一般有三种: 1.HTML事件处理程序 <body> <input type="button" value="点击" oncl ...
- 自学EF一些小笔记
一直在用DHhelper做MVC,感觉好山寨,也不怎么好用.决定开始学EF. 废话不多说开始记笔记..... EF就是把数据库表,存储过程,视图实例化,通过继承DbContext的一个类来操作数据实例 ...
- GFS Google File System(中文翻译)
Google文件系统 GFS是一个可扩展的分布式文件系统,用于大型的.分布式的.对大量数据进行访问的应用.它运行于廉价的普通硬件上,但可以提供容错功能.它可以给大量的用户提供总体性能较高的服务. 1. ...
- strcpy, memcpy, memset函数
一. strcpy函数 原型声明:char *strcpy(char* dest, const char *src); 头文件:#include <string.h> 和 #inclu ...
- Volley框架的流程图分析
接着上一篇Volley框架的使用,这一篇主要主要讲Volley框架运作的原理.主要使用流程图来叙述,简单的分析了整个流程的过程,具体的请参考源代码或者查看我上一篇在文章末尾添上的链接. 一 ...
- 搭建一个简单的Struts2框架
1 创建一个web项目. 2 导入必要的JAR文件. 放在WEB-INF下lib包里. 3 添加web.xml配置,添加启动配置. <?xml version="1.0" ...