
Apache Hadoop 2.9.2 的Federation架构设计
Apache Hadoop 2.9.2 的Federation架构设计
作者:尹正杰
版权声明:原创作品,谢绝转载!否则将追究法律责任。
能看到这篇文件,说明你对NameNode的工作原理想必已经了如指掌了。也知道他将来会面料的一些弊端,我们知道NameNode在启动时会将镜像文件(fsimage)和编辑日志(edits)从磁盘加载到内存,生成最初的元数据信息后,从而退出安全模式。但是随着数据量越来也多,逐步形成了大数据。根据有关技术报告知道,国内有几家优秀的互联网公司,如百度,腾讯和阿里巴巴等公司数据规模如下:
- 2013年百度相关技术报告称,百度数据总量接近1000PB,网页的数量大是几千亿个,每年更新几十亿个,每天查询次数几十亿次。
- 2013年腾讯相关技术报告称,腾讯约有8亿用户,4亿移动用户,总存储数据量经压缩处理以后在100PB左右,日新增200TB到300TB,月增加10%的数据量。
- 2013年阿里巴巴相关技术报告称,总体数据量为100PB,每天的活跃数据量已经超过50TB,共有4亿条产品信息和2亿多名注册用户,每天访问超过4000万人次。
综上所述,单台NameNode需要记录如上所属的公司数据,那定是相当吃力,而且还是6年前的数据信息,尽管你单台NameNode的内存是256G,依旧是不够用的,我们知道HA模式只是增加了集群的可用性,但是并没有负载均衡的作用,因为HA只能有一台机器可以对外提供写操作。那如何解决这个问题呢?其实官方已经想到了这个问题,相比大家也知道,就是联邦模式(Federation),本文将详细介绍如何部署联邦模式。
一.NameNode架构的局限性
1>.Namespace(名称空间)的限制
就像我们上面提到过的,由于NameNode在内存中存储所有的元数据(metadata),因此单个NameNode所能够存储的对象(文件+块)数据受到NameNode所在JVM的heap size的限制。
2>.隔离问题
由于HDFS仅有一个NameNode,无法隔离各个程序,因此HDFS上的一个实验程序就很可能影响整个HDFS上运行的程序。
3>.性能的瓶颈
由于是单个NameNode的HDFS架构,因此整个HDFS文件系统的吞吐量受限于单个NameNode的吞吐量。
二.HDFS Federation架构设计
关于HDFS的联邦模式,官方文档是这样说的:(http://hadoop.apache.org/docs/r2.9.2/hadoop-project-dist/hadoop-hdfs/Federation.html)
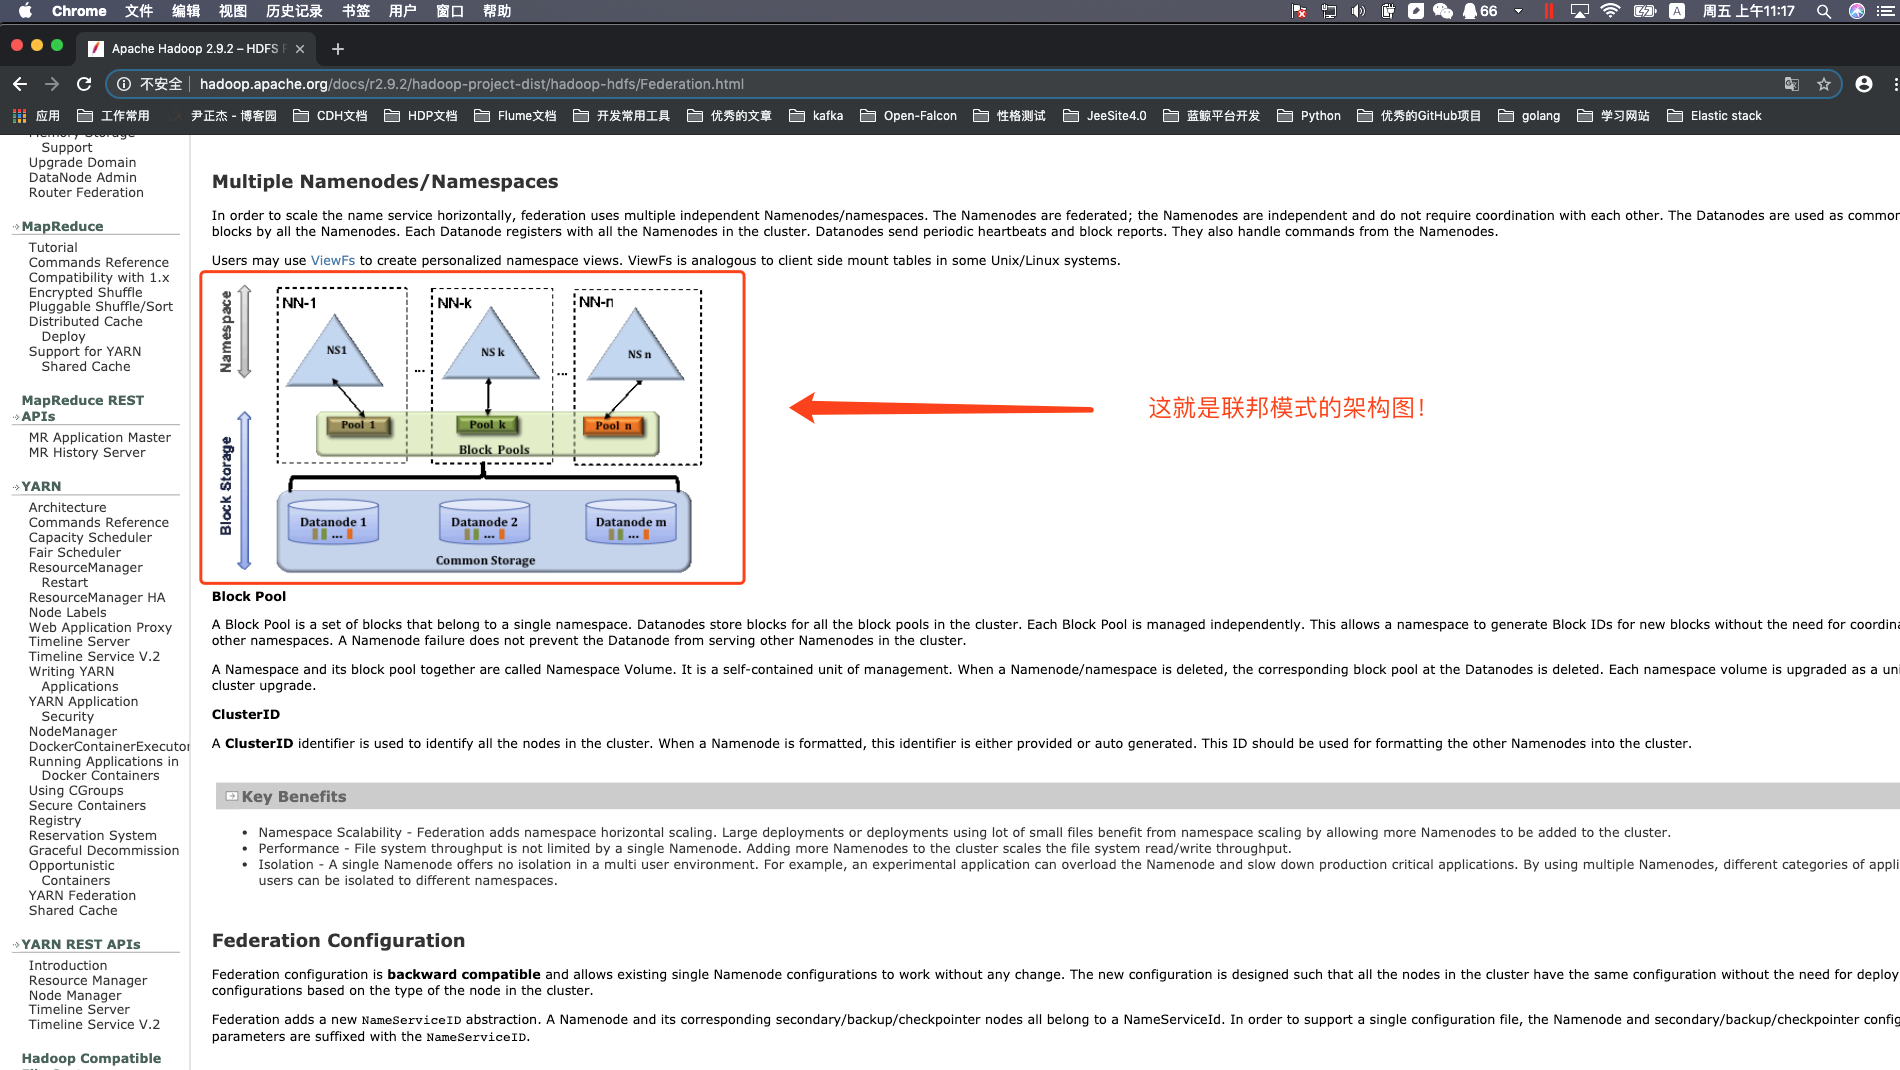
In order to scale the name service horizontally, federation uses multiple independent Namenodes/namespaces. The Namenodes are federated; the Namenodes are independent and do not require coordination with each other. The Datanodes are used as common storage for blocks by all the Namenodes. Each Datanode registers with all the Namenodes in the cluster. Datanodes send periodic heartbeats and block reports. They also handle commands from the Namenodes.
这段话并不难理解,作为运维的小伙伴应该很容易明白这其实就是负载均衡,把之前只有一个NameNode进行元数据处理的事情现在交给了多个NameNode来处理,每个NameNode的处理的数据并不重复,当然Federation和HA模式并不冲突,为了解决多个联邦模式出现单点故障,因此,建议大家把联邦模式和HA一起部署,让多个NameNode的处理的元数据都不存在单点故障!
三.HDFS Federation特点总结
1>.通过多个namenode/namespace(Fsimage)把元数据的存储和管理分散到多个节点中,使到namenode/namespace可以通过增加机器来进行水平扩展。
2>.能把单个namenode的负载分散到多个节点中,在HDFS数据规模较大的时候不会也降低HDFS的性能。
3>.可以通过多个namespace来隔离不同类型的应用,把不同类型(如图片业务,爬虫业务,日志审计业务)应用的HDFS元数据的存储和管理分派到不同的namenode中(这样隔离行较强)。
4>.不同namenode的namespace(Fsimage)数据他们是无法相互访问的。
四.HDFS Federation部署实战
五.验证 HDFS Federation的可用性
(未完待续........)
Apache Hadoop 2.9.2 的Federation架构设计的更多相关文章
- 安装部署Apache Hadoop (本地模式和伪分布式)
本节内容: Hadoop版本 安装部署Hadoop 一.Hadoop版本 1. Hadoop版本种类 目前Hadoop发行版非常多,有华为发行版.Intel发行版.Cloudera发行版(CDH)等, ...
- Apache hadoop namenode ha和yarn ha ---HDFS高可用性
HDFS高可用性Hadoop HDFS 的两大问题:NameNode单点:虽然有StandbyNameNode,但是冷备方案,达不到高可用--阶段性的合并edits和fsimage,以缩短集群启动的时 ...
- Ubuntu14.04用apt在线/离线安装CDH5.1.2[Apache Hadoop 2.3.0]
目录 [TOC] 1.CDH介绍 1.1.什么是CDH和CM? CDH一个对Apache Hadoop的集成环境的封装,可以使用Cloudera Manager进行自动化安装. Cloudera-Ma ...
- Hadoop学习笔记1---简介 优点 架构分析
一.Hadoop简介 Hadoop最早起源于Nutch.Nutch是一个开源的网络搜索引擎,由Doug Cutting于2002年创建.Nutch的设计目标是构建一个大型的全网搜索引擎,包括网页抓取. ...
- 【Hadoop学习】Apache Hadoop ResourceManager HA
简介 本向导简述了YARN资源管理器的HA,并详述了如何配置并使用该特性.RM负责追踪集群中的资源,并调度应用程序(如MapReduce作业).Hadoop2.4以前,RM是YARN集群中的单点故障. ...
- Apache Hadoop RPC Authentication 安全绕过漏洞
漏洞名称: Apache Hadoop RPC Authentication 安全绕过漏洞 CNNVD编号: CNNVD-201308-425 发布时间: 2013-08-28 更新时间: 2013- ...
- Apache Hadoop学习笔记一
官网:http://hadoop.apache.org/ 1 什么是Hadoop? Apache™Hadoop®项目开发了用于可靠,可扩展的分布式计算的开源软件. Apache Hadoop软件库是一 ...
- What Is Apache Hadoop
What Is Apache Hadoop? The Apache™ Hadoop® project develops open-source software for reliable, scala ...
- Apache Hadoop YARN: 背景及概述
从2012年8月开始Apache Hadoop YARN(YARN = Yet Another Resource Negotiator)成了Apache Hadoop的一项子工程.自此Apache H ...
随机推荐
- 亿级流量场景下,大型架构设计实现【全文检索高级搜索---ElasticSearch篇】-- 中
1.Elasticsearch的基础分布式架构: 1.Elasticsearch对复杂分布式机制的透明隐藏特性2.Elasticsearch的垂直扩容与水平扩容3.增减或减少节点时的数据rebalan ...
- Unity 2D 效应器与来回移动的实现
1.效应器 Point Effector 2D: 点效应器.进入区域,吸引或排斥物体 Area Effector 2D: 区域效应器,可以用来做马里奥的管道移动效果 Surface Effector ...
- MySQL数据库在IO性能优化方面的设置选择(硬件)
提起MySQL数据库在硬件方面的优化无非是CPU.内存和IO.下面我们着重梳理一下关于磁盘I/O方面的优化. 1.磁盘冗余阵列RAID RAID(Redundant Array of Inexpens ...
- SpringMVC的相关知识
前几天学习了SpringMVC 感觉比Servlet好用得多具体如下: 首先SpringMVC的概念: SpringMVC是一个前端控制框架,主要用来负责与页面的交互.SpringMVC是Spring ...
- easyui实现分页
主要参考官方的文档,欢迎评论 1.集成easyui,下面是我的引入方式,我引入到了head.html 每次只要引入该页面就可以了. <!-- easyui样式支持 --><link ...
- Redis和MongoDB的区别(面试受用)
项目中用的是MongoDB,但是为什么用其实当时选型的时候也没有太多考虑,只是认为数据量比较大,所以采用MongoDB. 最近又想起为什么用MongoDB,就查阅一下,汇总汇总: 之前也用过redis ...
- 百度地图引用时 报出A Parser-blocking, cross site (i.e. different eTLD+1) script
页面引入百度地图api时 chrome控制台报出警示问题 A Parser-blocking, cross site (i.e. different eTLD+1) script, http://ap ...
- 从Linux 与 Unix 异同,看开源世界的发展!
从Linux 与 Unix 异同,看开源世界的发展! 如果你是一名20多岁或30多岁的软件开发人员,那么你已成长在一个由Linux主导的世界中.数十年来,它一直是数据中心的重要参与者,尽管很难找到明确 ...
- git 本地代码冲突解决,强制更新
git reset soft,hard,mixed之区别深解 git reset --hard 强制更新覆盖本地 GIT reset命令,似乎让人很迷惑,以至于误解,误用.但是事实上不应该如此难 ...
- TypeError: argument 1 must be an integer, not _subprocess_handle/OSError: [WinError 87]
Error Msg: Traceback (most recent call last): File "c:\python27\lib\site-packages\celery\worker ...