
sklearn学习7-----决策树(tree)
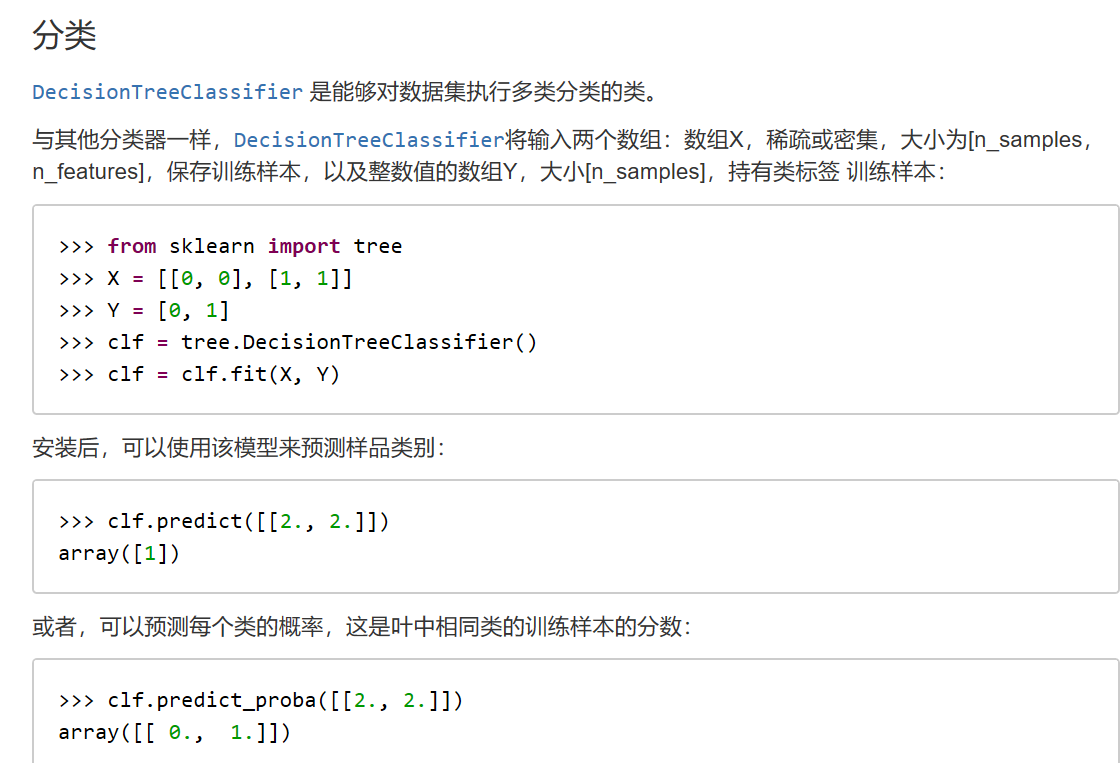
1、使用示例
2、树模型参数:【很多参数都是用来限制树过于庞大,即担心其过拟合】
# 1.criterion gini or entropy:用什么作为衡量标准 ( 熵值或者Gini系数 )。
# 2.splitter best or random 前者是在所有特征中找最好的切分点 后者是在部分特征中(数据量大的时候)【当特征过大时,从头开始遍历会过慢,一般选默认值best)】
# 3.max_features int or None(所有),optional(default=None) , log2,sqrt,N 特征小于50的时候一般使用所有的 【通常使用默认值None】
# 4.max_depth int or None:默认值为None。数据少或者特征少的时候可以不管这个值,如果模型样本量多,特征也多的情况下,可以尝试限制下树的深度
# 5.min_samples_split 如果某节点的样本数少于min_samples_split,则不会继续再尝试选择最优特征来进行划分,如果样本量不大,不需要管这个值。如果样本量数量级非常大,则推荐增大这个值。
# 6.min_samples_leaf 这个值限制了叶子节点最少的样本数,如果某叶子节点数目小于样本数,则会和兄弟节点一起被剪枝,如果样本量不大,不需要管这个值,大些如10W可是尝试下5
# 7.min_weight_fraction_leaf 这个值限制了叶子节点所有样本权重和的最小值,如果小于这个值,则会和兄弟节点一起被剪枝默认是0,就是不考虑权重问题。一般来说,如果我们有较多样本有缺失值,或者分类树样本的分布类别偏差很大,就会引入样本权重,这时我们就要注意这个值了。
# 8.max_leaf_nodes 通过限制最大叶子节点数,可以防止过拟合,默认是"None”,即不限制最大的叶子节点数。 如果加了限制,算法会建立在最大叶子节点数内最优的决策树。如果特征不多,可以不考虑这个值,但是如果特征分成多的话,可以加以限制,具体的值可以通过交叉验证得到。
# 9.class_weight 指定样本各类别的的权重,主要是为了防止训练集某些类别的样本过多, 导致训练的决策树过于偏向这些类别。这里可以自己指定各个样本的权重。如果使用“balanced”,则算法会自己计算权重,样本量少的类别所对应的样本权重会高。
# 10.min_impurity_split 这个值限制了决策树的增长,如果某节点的不纯度,(基尼系数,信息增益,均方差,绝对差)小于这个阈值。则该节点不再生成子节点。即为叶子节点 。
sklearn学习7-----决策树(tree)的更多相关文章
- [ML学习笔记] 决策树与随机森林(Decision Tree&Random Forest)
[ML学习笔记] 决策树与随机森林(Decision Tree&Random Forest) 决策树 决策树算法以树状结构表示数据分类的结果.每个决策点实现一个具有离散输出的测试函数,记为分支 ...
- Sklearn库例子——决策树分类
Sklearn上关于决策树算法使用的介绍:http://scikit-learn.org/stable/modules/tree.html 1.关于决策树:决策树是一个非参数的监督式学习方法,主要用于 ...
- sklearn学习总结(超全面)
https://blog.csdn.net/fuqiuai/article/details/79495865 前言sklearn想必不用我多介绍了,一句话,她是机器学习领域中最知名的python模块之 ...
- SKlearn中分类决策树的重要参数详解
学习机器学习童鞋们应该都知道决策树是一个非常好用的算法,因为它的运算速度快,准确性高,方便理解,可以处理连续或种类的字段,并且适合高维的数据而被人们喜爱,而Sklearn也是学习Python实现机器学 ...
- sklearn 学习之分类树
概要 基于 sklearn 包自带的 iris 数据集,了解一下分类树的各种参数设置以及代表的意义. iris 数据集介绍 iris 数据集包含 150 个样本,对应数据集的每行数据,每行数据包含 ...
- sklearn 学习 第一篇:分类
分类属于监督学习算法,是指根据已有的数据和标签(分类)进行学习,预测未知数据的标签.分类问题的目标是预测数据的类别标签(class label),可以把分类问题划分为二分类和多分类问题.二分类是指在两 ...
- sklearn笔记:决策树
概述 sklearn中决策树的类都在 tree 这个模块下.这个模块总共包含五个类: tree.DecisionTreeClassifier:分类树 tree.DecisionTreeRegresso ...
- 浅谈树模型与集成学习-从决策树到GBDT
引言 神经网络模型,特别是深度神经网络模型,自AlexNet在Imagenet Challenge 2012上的一鸣惊人,无疑是Machine Learning Research上最靓的仔,各种进 ...
- sklearn学习笔记3
Explaining Titanic hypothesis with decision trees decision trees are very simple yet powerful superv ...
随机推荐
- 如何添加删除子网卡eth0:1(linux案例)
这种方法实现了单网卡多IP,我的系统是centos7的,如何添加删除子网卡IP详细请看下面操作例子 添加子网卡IP:ifconfig ens3:1 192.168.0.100/24 ...
- 【JavaScript框架封装】使用Prototype给Array,String,Function对象的方法扩充
/* * @Author: 我爱科技论坛* @Time: 20180705 * @Desc: 实现一个类似于JQuery功能的框架* V 1.0: 实现了基础框架.事件框架.CSS框架.属性框架.内容 ...
- 园区IP地址规划(非常详细)
转:https://mp.weixin.qq.com/s/Zlm7x5eunIYLAG7Sp0yVCQ 经过这些年工作,接触从几万.几十万到上亿的项目都有: 我简单总结了接触的大部分的项目,将园区网核 ...
- 慎用PHP的unset、array_unique方法
背景 在日常工作中,可能会经常遇到一些PHP的代码场景,需要我们去除数组中的某个项,通常会直接调用unset方法,但是如果用得不妥,会给自己挖坑 1.实操 以下使用具体例子进行证明假设有数组如下值: ...
- knockout.validation.js 异步校验
self.forDealPwd.extend({ required:{ params:true, message:'请输入验证码!' }, minLength:{ params:4, message: ...
- Qt Quick 之 QML 与 C++ 混合编程具体解释
Qt Quick 技术的引入.使得你能够高速构建 UI ,具有动画.各种绚丽效果的 UI 都不在话下.但它不是万能的.也有非常多局限性,原来 Qt 的一些技术,比方低阶的网络编程如 QTcpSocke ...
- 上机题目(中级)- 两个超级大的整数相加相减 (Java)
代码例如以下: public class AddSub { public static void main(String[] args) { String a="46328648326846 ...
- 《Java虚拟机原理图解》 1.2.3、Class文件里的常量池具体解释(下)
NO9.类中引用到的field字段在常量池中是如何描写叙述的?(CONSTANT_Fieldref_info, CONSTANT_Name_Type_info) 一般而言.我们在定义类的过程中会定义一 ...
- c语言实现皇帝翻牌游戏
一个综合的游戏,对所学的知识进行整合!融会贯通! #include <stdio.h> #include <stdlib.h> #include <string.h> ...
- 使用神经网络-垃圾邮件检测-LSTM或者CNN(一维卷积)效果都不错【代码有问题,pass】
from sklearn.feature_extraction.text import CountVectorizer import os from sklearn.naive_bayes impor ...