
Python网络爬虫——BeautifulSoup4库的使用
使用requests库获取html页面并将其转换成字符串之后,需要进一步解析html页面格式,提取有用信息。
BeautifulSoup4库,也被成为bs4库(后皆采用简写)用于解析和处理html和xml。
1.调用
bs4库中最主要的便是bs类了,每个实例化的对象都相当于一个html页面
需要采用from-import导入bs类,同时通过BeautifulSoup()创建一个bs对象
代码如下:
import requests

from bs4 import BeautifulSoup

r=requests.get("https://www.baidu.com/")

r.encoding="utf-8"

soup=BeautifulSoup(r.text)

print(type(soup))
运行结果:
2.常用属性
创建的BeautifulSoup对象是一个树形结构,它包含html页面中的每一个Tag(标签)元素,可以通过<a>.<b>的形式获得
常见的属性如下:
head:
html页面<head>内容
title:
html页面标题,在<head>之中,由<title>标记
body:
html页面<body>内容
p:
html页面第一个<p>内容
strings:
html页面所有呈现在web上的字符串,即标签的内容
stripped_string:
html页面所有呈现在web上的非空字符串

接下来尝试爬取百度的标语“百度一下,你就知道”
首先我们通过requests来建立请求,可以通过查看源代码找到对应部分
如下所示:
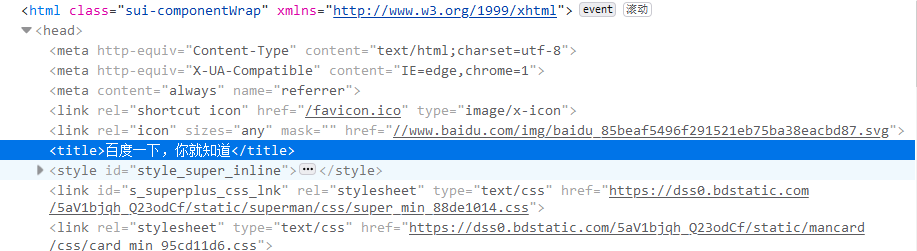
所以直接通过调用<title>标签即可
代码如下:
import requests

from bs4 import BeautifulSoup

r=requests.get("https://www.baidu.com/")

r.encoding="utf-8"

soup=BeautifulSoup(r.text)

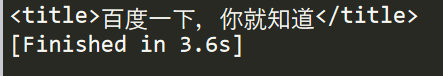
title=soup.title

print(title)
结果如图所示:
3.标签常用属性
每一个标签在bs4中也是一个对象,被称为tag对象,以糯米为例,常见结构如下:
<a class=“mnav” href="http://www.nuomi.com">糯米</a>
其中尖括号(<>)中标签的名字为 name,其他项为attrs,尖括号之间的内容为string
所以常见的标签属性分为4种
name:
字符串、标签的名字
attrs:
字典、包含了原来页面tag的所有属性,比如href
contrnts:
列表、tag下所有子tag的内容
string:
字符串、tag所包含的文本,网页中的真实文字
由于html可以在标签中嵌套其他的标签,所以string返回遵循以下原则
①如果标签内没有其他标签,string属性返回其中的内容
②如果标签内部还有标签,但只有一个标签,string返回最里面的标签内容
③如果内部超过1层嵌套标签,则返回为none
依然以百度为例,我们需要找到第一个<a>标签的string代码应当如下:
import requests

from bs4 import BeautifulSoup

r=requests.get("https://www.baidu.com/")

r.encoding="utf-8"

soup=BeautifulSoup(r.text)

print(soup.a.string)
结果如图所示:

4.调用find()与find_all()
html中,同一个特标签会有很多内容,比如百度首页<a>一共有13处,但值返回第一处
所以这时候需要通过find与find_all来寻找,这两个方法都会遍历html文档按照条件返回内容
使用方法如下:
BeautifulSoup.find_all(name,attrs,recursive,string,limit)
name:以标签名字进行搜索,名字用字符串类型表示
attrs:按照标签的属性来搜索,需要列出属性的名字和值,用json方法表示
recursive:设置查找层次,只查找当前标签的西一层时使用recursiv=false
string:按照关键字查找string属性内容,采用string=开始
limit:返回结果个数,默认全部
至于find()使用方法如find_all()相同,
BeautifulSoup.find_all(name,attrs,recursive,string)
区别在于find()只搜索第一个结果,find_all()返回所有结果。
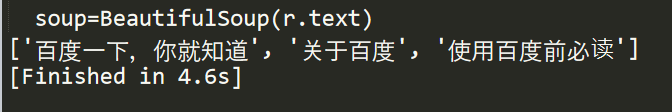
我们尝试来通过find_all()来获取所有含有“百度”这一关键词的标签
首先需要调用re库,re是python的标准库可以采用compile()对字符串的检索
所以代码如下:
import requests

import re

from bs4 import BeautifulSoup

r=requests.get("https://www.baidu.com/")

r.encoding="utf-8"

soup=BeautifulSoup(r.text)

w=soup.find_all(string=re.compile("百度"))

print(w)
结果如下:
Python网络爬虫——BeautifulSoup4库的使用的更多相关文章
- Python网络爬虫:空姐网、糗百、xxx结果图与源码
如前面所述,我们上手写了空姐网爬虫,糗百爬虫,先放一下传送门: Python网络爬虫requests.bs4爬取空姐网图片Python爬虫框架Scrapy之爬取糗事百科大量段子数据Python爬虫框架 ...
- Python网络爬虫学习总结
1.检查robots.txt 让爬虫了解爬取该网站时存在哪些限制. 最小化爬虫被封禁的可能,而且还能发现和网站结构相关的线索. 2.检查网站地图(robots.txt文件中发现的Sitemap文件) ...
- Python网络爬虫与信息提取
1.Requests库入门 Requests安装 用管理员身份打开命令提示符: pip install requests 测试:打开IDLE: >>> import requests ...
- Python网络爬虫与信息提取笔记
直接复制粘贴笔记发现有问题 文档下载地址//download.csdn.net/download/hide_on_rush/12266493 掌握定向网络数据爬取和网页解析的基本能力常用的 Pytho ...
- python 网络爬虫全流程教学,从入门到实战(requests+bs4+存储文件)
python 网络爬虫全流程教学,从入门到实战(requests+bs4+存储文件) requests是一个Python第三方库,用于向URL地址发起请求 bs4 全名 BeautifulSoup4, ...
- 关于Python网络爬虫实战笔记①
python网络爬虫项目实战笔记①如何下载韩寒的博客文章 python网络爬虫项目实战笔记①如何下载韩寒的博客文章 1. 打开韩寒博客列表页面 http://blog.sina.com.cn/s/ar ...
- python网络爬虫学习笔记
python网络爬虫学习笔记 By 钟桓 9月 4 2014 更新日期:9月 4 2014 文章文件夹 1. 介绍: 2. 从简单语句中開始: 3. 传送数据给server 4. HTTP头-描写叙述 ...
- Python网络爬虫
http://blog.csdn.net/pi9nc/article/details/9734437 一.网络爬虫的定义 网络爬虫,即Web Spider,是一个很形象的名字. 把互联网比喻成一个蜘蛛 ...
- 【python网络爬虫】之requests相关模块
python网络爬虫的学习第一步 [python网络爬虫]之0 爬虫与反扒 [python网络爬虫]之一 简单介绍 [python网络爬虫]之二 python uillib库 [python网络爬虫] ...
随机推荐
- m113
今天的比赛很有感触,所以来写一下题解: T1可以发现一些规律是:面积扩大的速度显然比周长扩大的速度快,然后就可以枚举周长来看能为成的面积,其实最优的情况一定是六边型的情况,通过手膜我们可以发现对于边长 ...
- 安装Windows和Ubuntu双系统--Ubuntu安装过程识别不了硬盘
Linux识别不了固态硬盘 安装过程: 自己本身的是Windows 10,一块125g 固态 ,一块1T的机械硬盘. 通过rufus 制作ubuntu的启动盘 在BIOS中关闭电脑的安全启动选项,并且 ...
- 怎样判断有没有SQL注入漏洞及原理?
来源:实验楼 最为经典的单引号判断法: 在参数后面加上单引号,比如: http://xxx/abc.php?id=1' 如果页面返回错误,则存在 Sql 注入. 原因是无论字符型还是整型都会因为单引号 ...
- 解决mybatis中 数据库column 和 类的属性名property 不一致的两种方式
解决方式way1:resultMap (1)studentMapper.xml <!-- 当数据库的字段名 和 类的属性名 不一致的时候的解决方式:2种 way1--> <selec ...
- 初识web API接口及Restful接口规范
一.web API接口 什么是web API接口?: 明确了请求方式,提供对应后台所需参数,请求url链接可以得到后台的响应数据 url : 返回数据的url https://api.map.baid ...
- java笔试面试第二天
没想到第二次面试到了第二周,也是我在上海找工作的第二周,说实话,没有真本事找工作是真的难,虽然正在召开的十九大上,大大们纷纷表态国力正盛,经济稳步增长,就业压力逐渐缓解,但是社会终究是社会,要么靠实力 ...
- 网站搭建-IIS Windows系统搭建网站 (不小心看到自己的密码 - 怎么找回网站记住的密码)
上一期说到IIS可以用自己喜欢的网站来直接玩,然后得得瑟瑟将自己的博客园账号首页拿过去玩(今天第一天水博客园). 然后自己访问啊,访问啊,然后就一直点啊点的,当然,其实后面的链接都是跳转到博客园里面去 ...
- 架构设计:"4+1"视图
概念 "4+1"视图,是指从5个不同视角来描述软件体系结构. "4+1"分别指: 逻辑视图 过程视图 物理视图 开发视图 场景/用例 视图 逻辑架构的描述可以围 ...
- SqlServer2005 查询 第六讲 null
今天们来讲sql命令中的这个null参数 null null: 可以理解成[没有值,空值]的意思 注意以下几点 --1.零和null是不一样的,null表示空值,而零表示的一个确定的值 --2.nul ...
- nyoj 115-城市平乱 (BFS)
115-城市平乱 内存限制:64MB 时间限制:1000ms 特判: No 通过数:5 提交数:8 难度:4 题目描述: 南将军统领着N个部队,这N个部队分别驻扎在N个不同的城市. 他在用这N个部队维 ...