
【Machine Learning·机器学习】决策树之ID3算法(Iterative Dichotomiser 3)
@
1、什么是决策树
决策树,就是一种把决策节点画成树的辅助决策工具,一种寻找最优方案的画图法。
如下图所示,从左图到右图就是一个简单的,利用决策树,辅助决策的过程。

2、如何构造一棵决策树?
2.1、基本方法
通过对不同特征的优先级区分判断后,优先选择优先级高的特征作为划分的特征。(如上图所示,假设优先级:学历>院校>工作经验。因此我们优先选择了学历作为分类依据,次而选择了院校作为分类依据,最后才选择了项目经验作为分类依据)。
那么,下一个问题来了,我们是怎样判断一个特征的优先级的?具体来说,就是我们在评价一个特征优先级时候的评价标准是什么。这个评价标准,在决策树中非常重要,一个合适评价标准,可以将不同的特征按照非常合理的方式进行优先级排序,从而能够构建出一颗比较完美的决策树。而一个不合适的评价标准则会导致最终构造的决策树出现种种问题。
2.2、评价标准是什么/如何量化评价一个特征的好坏?
在不同的决策树算法中,这个特征好坏的评价标准略有不同。比如,在问哦们今天讲的ID3算法中,评价标准是一个叫做 信息增益(Information Gain) 的东西。而在另一个决策树算法C4.5中,评判标准则进一步变为信息增益比(Information Gain Ration或Gain Ratio)。另外一个比较主流的决策树算法CART算法则是采用 基尼系数(Gini Index) 作为评判标准。这些东西,我们会在后面的几篇文章中一一涉及到,在本文中,我们将关注的重点放在信息增益上。
在进入正题之前,我们需要先了解一些简单的概念。第一个需要我们了解的概念叫做熵/entropy。学过中学物理的朋友们可能会有一些印象:熵,热力学中表征物质状态的参量之一,用符号S表示,其物理意义是体系混乱程度的度量。
熵这个概念最初源自于热力学中,1948年,香农引入了信息熵,将其定义为离散随机事件出现的概率。在信息学里面,熵是对不确定性的度量。 一个系统越是有序,信息熵就越低,反之一个系统越是混乱,它的信息熵就越高。 所以信息熵可以被认为是系统有序化程度的一个度量。其本质与热力学中的熵的概念是相同的。
可这又和我们今天要讲的信息增益这个评判标准有什么关系呢?我们不妨这样想,当我们得到一组信息,一组类似于上图左半部分的信息。该组信息有多个特征(如学历、学校等),同时有一组综合每一个特征得到的结论。上图展示的这组信息只有A、B、C、D四个实例,倘若我们有成千上万个实例,但看这成千上万实例构成的表格,我们的第一感受可能是混乱。没错,如此多的实例,粗鲁地被凭借在同一个表格中,实在是太混乱了。将混乱换成我们刚刚提到过的说法:这组信息的信息熵太高了。 这样的场景,尤其是当我们想要通过这张表去查询某些东西,更是非常不便。我们希望可以有某种方法,在降低系统混乱程度/降低系统熵值的同时,不损害信息的完整性。那么有没有这么一种方法呢?当然有的,就是我们今天讲到的决策树算法。
从上图的左边,到上图右边的转变,我们可以非常直观感受到,这组信息不仅变得不那么混乱,而且这种树形的表示方式,比较符合我们人类的思维习惯。为什么会出现这样感受上的差异呢?其实很简单,因为我们从右图的根节点开始,每做一次特征的划分,整个系统的熵值就得到了一次降低。 这个信息系统给我们的感受也就越来越规范。进而,我们很容易地引出信息增益地概念:信息增益就是我们以某一个特征划分某个信息系统后,这个系统整体信息熵降的数值。
接下来,我们很容易可以回答如何去判断一个特征的好坏:如果一个特征,相较于其他所有特征,在将一个信息系统按照该特征划分前后,可以将整个数据系统的信息熵降到最低(信息增益最大),这个特征就是一个好的特征。我们应该优先使用该特征进行系统的划分。
2.3、信息熵、信息增益的计算
在此,我们先给出信息熵的计算公式:

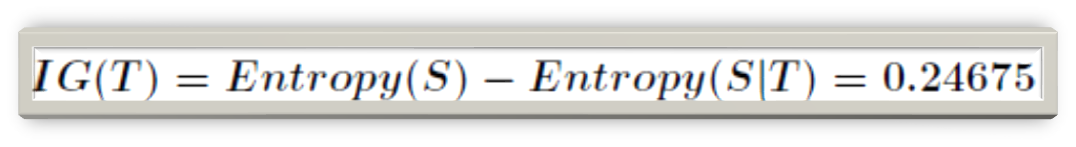
知道了信息熵的计算公式后,信息增益的计算公式也很容易理解,就是当前系统的信息熵S,减去按照某个特征划分整个系统后,每个子系统的信息熵乘以每个子系统在整个系统所占比例(Si X Pi),最后相加得到的值。也即:信息增益 InfoGain = S-Σ(SixPi)。
举个例子,我们得到如下图所示的一个信息系统(该系统前四列为不同的四个特征,最后一列为结果。),那么要如何计算整个系统的信息熵,以及该系统对应某个特征的信息增益呢?

首先,可以看出,结果列中一共有14个样例,其中包括9个正例和5个负例。那么当前信息的熵计算

上面,我们计算出了整个系统的信息熵,也就是未对数据进行划分时的信息熵。那么下面我们计算使用某个特征对系统进行划分后,整个系统的信息熵,以及划分前后系统信息熵的差值(信息增益)比如,我们根据第一个特征Outlook进行划分:

划分后,数据被分为三部分了,那么各个分支的信息熵(子系统信息熵)计算如下:

我们将每个子系统的信息熵,乘以该子系统在整个系统中所占比例,依次相加后,得到划分后系统的整体信息熵。如下图所示:

最后,终于来到我们最激动人心的一步了,计算信息增益,如下图所示:
2.4、决策树构建方法
在上一步中,我们计算出每个特征所对应地信息增益,选取信息增益最大的特征优先划分整个系统(将系统划分为一个个子数据集/子树/子系统)。
在每个子系统中,我们再 重新计算 未被使用过的特征的优先级,并选择优先级最大的特征继续划分数据集构造子树。知道,该递归构造子树的过程因为某些原因终止为止。
2.4、构造终止的条件/何时停止构造子树?
1、当我们发现一个子树中,结果完全相同,如结果全部为YES的时候,就没有在该子树中继续构造下去的必要了(其他子树中的构造过程未必终止)。此时我们得到该子树最终的结果为YES。
2、当我们发现一个子树中,虽然其结果没有完全相同,但已经没有可以支撑我们继续构造子树的特征了(简而言之就是所有特征都已经用过了),这个时候就可以停止在该子树中继续构造了。此时,该子树的最终结果为该子树集合的结果列中,出现次数最多的哪个属性值。
3、算法总结
1、判断每一个子树中的每个例子结果是否一致或是否特征已用尽
是:该子树构造完成,返回该子树对应的最终结果。
否:继续递归构造子树
若1中结果为否,则:
1.1、计算当前子系统信息熵
1.2、计算未被使用过的特征的信息增益
1.3、选取最大的信息增益的特征进行划分,并从特征集合中删除该特征
1.4、根据3中划分构造子树,并转向步骤1。
【Machine Learning·机器学习】决策树之ID3算法(Iterative Dichotomiser 3)的更多相关文章
- 【Machine Learning】决策树之ID3算法 (2)
决策树之ID3算法 Content 1.ID3概念 2.信息熵 3.信息增益 Information Gain 4. ID3 bias 5. Python算法实现(待定) 一.ID3概念 ID3算法最 ...
- 机器学习-决策树之ID3算法
概述 决策树(Decision Tree)是一种非参数的有监督学习方法,它是一种树形结构,所以叫决策树.它能够从一系列有特征和标签的数据中总结出决策规则,并用树状图的结构来呈现这些规则,以解决分类和回 ...
- 【Machine Learning】决策树案例:基于python的商品购买能力预测系统
决策树在商品购买能力预测案例中的算法实现 作者:白宁超 2016年12月24日22:05:42 摘要:随着机器学习和深度学习的热潮,各种图书层出不穷.然而多数是基础理论知识介绍,缺乏实现的深入理解.本 ...
- Portal:Machine learning机器学习:门户
Machine learning Machine learning is a scientific discipline that explores the construction and stud ...
- 决策树之ID3算法
一.决策树之ID3算法简述 1976年-1986年,J.R.Quinlan给出ID3算法原型并进行了总结,确定了决策树学习的理论.这可以看做是决策树算法的起点.1993,Quinlan将ID3算法改进 ...
- [原创]Machine Learning/机器学习 文章合集
转载请注明出处:https://www.codelast.com/ ➤ 用人话解释机器学习中的Logistic Regression(逻辑回归) ➤ 如何防止softmax函数上溢出(overflow ...
- [Machine Learning] 机器学习常见算法分类汇总
声明:本篇博文根据http://www.ctocio.com/hotnews/15919.html整理,原作者张萌,尊重原创. 机器学习无疑是当前数据分析领域的一个热点内容.很多人在平时的工作中都或多 ...
- Machine Learning:机器学习算法
原文链接:https://riboseyim.github.io/2018/02/10/Machine-Learning-Algorithms/ 摘要 机器学习算法分类:监督学习.半监督学习.无监督学 ...
- 简单易学的机器学习算法——决策树之ID3算法
一.决策树分类算法概述 决策树算法是从数据的属性(或者特征)出发,以属性作为基础,划分不同的类.例如对于如下数据集 (数据集) 其中,第一列和第二列为属性(特征),最后一列为类别标签,1表示是 ...
随机推荐
- 记一次基于Cloudflare服务的爬虫
前言 前几天有个朋友托我帮忙爬一个网站,第一次打开那个网站时,我去,它竟然就要验证码,不过当时是想加几个header应该就能解决,不过事实证明我还是错了.接下来将记录下爬虫中遇到的一些坑以及解决办法. ...
- 搭建minima主题的github博客网站
layout: post title: "搭建minima主题的github博客网站" date: 2019-04-20 19:20:20 +0800 --- 作者:吴甜甜 个人博 ...
- IT需求过程管理
IT部门就是为其他业务.内勤部门提供信息化手段的,所以在实施信息化系统的时候首先要做的就是需求调研,但是针对于绝大多数业务部门的人员而言,信息系统是很不熟悉的,我们会经常听到这样的回复“这个应该很快就 ...
- Linux查看进程具体开启时间
ps -p 2417 -o lstart -- 2417为进程号
- 分组在re模块中的使用
import re #search s = "<a>wahaha</a>" #标签语言 html 和 web相关 ret= re.search(" ...
- springboot2.x纯注解整合dubbo
springboot1.x和springboot2.x整合差距挺大的,基于最新的2.x进行整合,使用纯注解的方式 依赖选取 首先pom文件的依赖引入,maven仓库有Apache和alibaba两个 ...
- .NET项目迁移到.NET Core操作指南
为什么要从.NET迁移到.NET Core? .NET Core提供的特性 .NET Core性能提升 .NET如何迁移到.NET Core? 迁移工作量评估(API兼容性分析) 迁移方案制定 通过类 ...
- EnjoyingSoft之Mule ESB开发教程第四篇:Mule Expression Language - MEL表达式
目录 1. MEL的优势 2. MEL的使用场景 3. MEL的示例 4. MEL的上下文对象 5. MEL的Variable 6. MEL访问属性 7. MEL操作符 本篇主要介绍Mule表达式语言 ...
- 「玩转Python」突破封锁继续爬取百万妹子图
前言 从零学 Python 案例,自从提交第一个妹子图版本引来了不少小伙伴的兴趣.最近,很多小伙伴发来私信说,妹子图不能爬了!? 趁着周末试了一把,果然爬不动了,爬下来的都是些 0kb 的假图片,然后 ...
- MyBatis bind标签的用法
From<MyBatis从入门到精通> <!-- 4.5 bind用法 bind标签可以使用OGNL表达式创建一个变量并将其绑定到上下文中. 需求: concat函数连接字符串,在M ...