
python网络爬虫(11)近期电影票房或热度信息爬取
目标意义
为了理解动态网站中一些数据如何获取,做一个简单的分析。
说明
思路,原始代码来源于:https://book.douban.com/subject/27061630/。
构造-下载器
构造分下载器,下载原始网页,用于原始网页的获取,动态网页中,js部分的响应获取。
通过浏览器模仿,合理制作请求头,获取网页信息即可。
代码如下:
import requests

import chardet

class HtmlDownloader(object):

    def download(self,url):

        if url is None:

            return None

        user_agent='Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36 SE 2.X MetaSr 1.0'

        headers={'User-Agent':user_agent}

        r=requests.get(url,headers=headers)

        if r.status_code is 200:

            r.encoding=chardet.detect(r.content)['encoding']

            return r.text

        return None
构造-解析器
解析器解析数据使用。
获取的票房信息,电影名称等,使用解析器完成。
被解析的动态数据来源于js部分的代码。
js地址的获取则通过F12控制台-->网络-->JS,然后观察,得到。
地址如正上映的电影:
http://service.library.mtime.com/Movie.api?Ajax_CallBack=true&Ajax_CallBackType=Mtime.Library.Services&Ajax_CallBackMethod=GetMovieOverviewRating&Ajax_CrossDomain=1&Ajax_RequestUrl=http://movie.mtime.com/257982/&t=201907121611461266&Ajax_CallBackArgument0=257982
返回信息中,解析出json格式的部分,通过json的一些方法,获取其中的票房等信息。
其中,json解析工具地址如:https://www.json.cn/
未上映的电影是同理的。
这些数据的解析有差异,所以定制了函数分支,处理解析过程中可能遇到的不同情景。
代码如下:
import re

import json

class HtmlParser(object):

    def parser_url(self,page_url,response):

        pattern=re.compile(r'(http://movie.mtime.com/(\d+)/)')

        urls=pattern.findall(response)

        if urls != None:

            return list(set(urls))#Duplicate removal

        else:

            return None

    def parser_json(self,url,response):

        #parsing json. input page_url as js url and response for parsing

        pattern=re.compile(r'=(.*?);')

        result=pattern.findall(response)[0]

        if result != None:

            value=json.loads(result)

            isRelease=value.get('value').get('isRelease')

            if isRelease:

                isRelease=1

                return self.parser_json_release(value,url)

            else:

                isRelease=0

                return self.parser_json_notRelease(value,url)

        return None

    def parser_json_release(self,value,url):

        isRelease=1

        movieTitle=value.get('value').get('movieTitle')

        RatingFinal=value.get('value').get('movieRating').get('RatingFinal')

        try:

            TotalBoxOffice=value.get('value').get('boxOffice').get('TotalBoxOffice')

            TotalBoxOfficeUnit=value.get('value').get('boxOffice').get('TotalBoxOfficeUnit')

        except:

            TotalBoxOffice="None"

            TotalBoxOfficeUnit="None"

        return isRelease,movieTitle,RatingFinal,TotalBoxOffice,TotalBoxOfficeUnit,url

    def parser_json_notRelease(self,value,url):

        isRelease=0

        movieTitle=value.get('value').get('movieTitle')

        try:

            RatingFinal=Ranking=value.get('value').get('hotValue').get('Ranking')

        except:

            RatingFinal=-1

        TotalBoxOffice='None'

        TotalBoxOfficeUnit='None'

        return isRelease,movieTitle,RatingFinal,TotalBoxOffice,TotalBoxOfficeUnit,url
构造-存储器
存储方案为Sqlite,所以在解析器中isRelease部分,使用了0和1进行的存储。
存储需要连接sqlite3,创建数据库,获取执行数据库语句的方法,插入数据等。
按照原作者思路,存储时,先暂时存储到内存中,条数大于10以后,将内存中的数据插入到sqlite数据库中。
代码如下:
import sqlite3

class DataOutput(object):

    def __init__(self):

        self.cx=sqlite3.connect("MTime.db")

        self.create_table('MTime')

        self.datas=[]

    def create_table(self,table_name):

        values='''

        id integer primary key autoincrement,

        isRelease boolean not null,

        movieTitle varchar(50) not null,

        RatingFinal_HotValue real not null default 0.0,

        TotalBoxOffice varchar(20),

        TotalBoxOfficeUnit varchar(10),

        sourceUrl varchar(300)

        '''

        self.cx.execute('create table if not exists %s(%s)' %(table_name,values))

    def store_data(self,data):

        if data is None:

            return

        self.datas.append(data)

        if len(self.datas)>10:

            self.output_db('MTime')

    def output_db(self,table_name):

        for data in self.datas:

            cmd="insert into %s (isRelease,movieTitle,RatingFinal_HotValue,TotalBoxOffice,TotalBoxOfficeUnit,sourceUrl) values %s" %(table_name,data)

            self.cx.execute(cmd)

            self.datas.remove(data)

        self.cx.commit()

    def output_end(self):

        if len(self.datas)>0:

            self.output_db('MTime')

        self.cx.close()
主函数部分
创建以上对象作为初始化
然后获取根路径。从根路径下找到百余条电影网址信息。
对每个电影网址信息一一解析,然后存储。
import HtmlDownloader

import HtmlParser

import DataOutput

import time

class Spider(object):

    def __init__(self):

        self.downloader=HtmlDownloader.HtmlDownloader()

        self.parser=HtmlParser.HtmlParser()

        self.output=DataOutput.DataOutput()

    def crawl(self,root_url):

        content=self.downloader.download(root_url)

        urls=self.parser.parser_url(root_url, content)

        for url in urls:

            print('.')

            t=time.strftime("%Y%m%d%H%M%S1266",time.localtime())

            rank_url='http://service.library.mtime.com/Movie.api'\

            '?Ajax_CallBack=true'\

            '&Ajax_CallBackType=Mtime.Library.Services'\

            '&Ajax_CallBackMethod=GetMovieOverviewRating'\

            '&Ajax_CrossDomain=1'\

            '&Ajax_RequestUrl=%s'\

            '&t=%s'\

            '&Ajax_CallBackArgument0=%s' %(url[0],t,url[1])

            rank_content=self.downloader.download(rank_url)

            try:

                data=self.parser.parser_json(rank_url, rank_content)

            except:

                print(rank_url)

            self.output.store_data(data)

        self.output.output_end()

        print('ed')

if __name__=='__main__':

    spider=Spider()

    spider.crawl('http://theater.mtime.com/China_Beijing/')
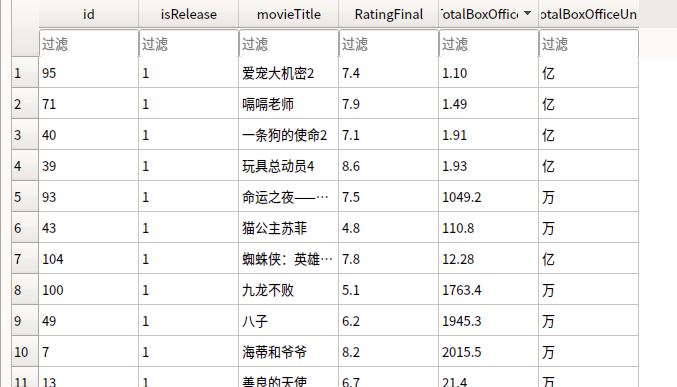
当前效果
如下:
python网络爬虫(11)近期电影票房或热度信息爬取的更多相关文章
- Python 网络爬虫 004 (编程) 如何编写一个网络爬虫,来下载(或叫:爬取)一个站点里的所有网页
爬取目标站点里所有的网页 使用的系统:Windows 10 64位 Python语言版本:Python 3.5.0 V 使用的编程Python的集成开发环境:PyCharm 2016 04 一 . 首 ...
- 【Python3网络爬虫开发实战】6.4-分析Ajax爬取今日头条街拍美图【华为云技术分享】
[摘要] 本节中,我们以今日头条为例来尝试通过分析Ajax请求来抓取网页数据的方法.这次要抓取的目标是今日头条的街拍美图,抓取完成之后,将每组图片分文件夹下载到本地并保存下来. 1. 准备工作 在本节 ...
- 转:【Python3网络爬虫开发实战】6.4-分析Ajax爬取今日头条街拍美图
[摘要] 本节中,我们以今日头条为例来尝试通过分析Ajax请求来抓取网页数据的方法.这次要抓取的目标是今日头条的街拍美图,抓取完成之后,将每组图片分文件夹下载到本地并保存下来. 1. 准备工作 在本节 ...
- 《精通Python网络爬虫》|百度网盘免费下载|Python爬虫实战
<精通Python网络爬虫>|百度网盘免费下载|Python爬虫实战 提取码:7wr5 内容简介 为什么写这本书 网络爬虫其实很早就出现了,最开始网络爬虫主要应用在各种搜索引擎中.在搜索引 ...
- python网络爬虫之解析网页的BeautifulSoup(爬取电影图片)[三]
目录 前言 一.BeautifulSoup的基本语法 二.爬取网页图片 扩展学习 后记 前言 本章同样是解析一个网页的结构信息 在上章内容中(python网络爬虫之解析网页的正则表达式(爬取4k动漫图 ...
- 一篇文章教会你利用Python网络爬虫获取电影天堂视频下载链接
[一.项目背景] 相信大家都有一种头疼的体验,要下载电影特别费劲,对吧?要一部一部的下载,而且不能直观的知道最近电影更新的状态. 今天小编以电影天堂为例,带大家更直观的去看自己喜欢的电影,并且下载下来 ...
- 从零开始学Python网络爬虫PDF高清完整版免费下载|百度网盘
百度网盘:从零开始学Python网络爬虫PDF高清完整版免费下载 提取码:wy36 目录 前言第1章 Python零基础语法入门 11.1 Python与PyCharm安装 11.1.1 Python ...
- python网络爬虫学习笔记
python网络爬虫学习笔记 By 钟桓 9月 4 2014 更新日期:9月 4 2014 文章文件夹 1. 介绍: 2. 从简单语句中開始: 3. 传送数据给server 4. HTTP头-描写叙述 ...
- Python网络爬虫
http://blog.csdn.net/pi9nc/article/details/9734437 一.网络爬虫的定义 网络爬虫,即Web Spider,是一个很形象的名字. 把互联网比喻成一个蜘蛛 ...
随机推荐
- IOS开发之把 JSON 数据转化成 Arrays 或者 Dictionaries
1 前言通过 NSJSONSerialization 这个类的 JSONObjectWithData:options:error:方法来实现,把JSON 数据解析出来放在数据或者字典里面保存. 2 代 ...
- wpf 绑定表达式和手动更新源
<Window x:Class="BindingExpressionExam.MainWindow" xmlns="http://schemas.mi ...
- Springboot统一配置Jackson
经常要为接口响应对象设置属性,序列化的时候是不是包含空值,反序列化的时候是否忽略不认识的字段.所以,必须要手动制定ObjectMapper或者在类上声明 @JsonInclude(Include.NO ...
- Thinkphp模板开放给第三方编辑权限时,如何禁止模板使用php代码
首先我要吐槽一个问题:为什么在博客园发布的文章总是被其他网站采集过去,而他们采集过去后,排名比博客园还好,比如这篇文章,我把标题复制到百度搜索,结果第一页的搜索结果全部都是采集我的,而我在博客园发布的 ...
- ES6/ES2015核心内容(转载)
ES6其实就是ES2015,因为是2015年发布的,所以也叫ES2015.这个版本是JS的最新版本,很多浏览器还不支持,所有有了babel,专门把最新的JS转换一下,让大部分浏览器都支持的JS版本. ...
- 零元学Expression Blend 4 - Chapter 27 PathlistBox被Selected时的蓝底蓝框问题
原文:零元学Expression Blend 4 - Chapter 27 PathlistBox被Selected时的蓝底蓝框问题 最近收到网友Cloud的来信,询问我有关放进PathlistBox ...
- shell中select、case的使用
case和select结构在技术上说并不是循环, 因为它们并不对可执行代码块进行迭代. 但是和循环相似的是, 它们也依靠在代码块顶部或底部的条件判断来决定程序的分支. select select结 ...
- C# ACCESS 向含有自动编码字段表中添加记录提示“查询值的数目与目标字段中的数目不同”
引发错误的SQL语句如下: sqlStr = "insert into tb_ReportLog values('" + DevSite + "','" + D ...
- 转载 《我用 TypeScript 语言的七个月》
快速使用Romanysoft LAB的技术实现 HTML 开发Mac OS App,并销售到苹果应用商店中. <HTML开发Mac OS App 视频教程> 土豆网同步更新:http: ...
- Windows下获取逻辑cpu数量和cpu核数量
代码可在Windows NT下正常运行 具体API说明请参照如下文档: GetLogicalProcessorInformation 点击打开链接 点击打开链接 点击打开链接 typedef BOOL ...