
文本文档中各字母出现次数汇总(java)
 package 字母频率统计;

 import java.io.*;

 public class Inputfile {

     public static void main(String args[]) {

         try {

             char shu[] = new char[1000];

             char zimu[] = new char[52];

             int j=0;

             int count[]=new int[52];

             String pathname="D:\\a.txt";

             File filename=new File(pathname);

             InputStreamReader reader=new InputStreamReader(new FileInputStream(filename));

             BufferedReader br=new BufferedReader(reader);

             String line[]=new String[100];;

             for(int i=0;i<line.length;i++){

             line[i]=br.readLine();

             }

             br.close();

             int k=0;

              while(line[k]!=null) {

                  for(int i=0;i<line[k].length();i++) {

                       shu[j]=line[k].charAt(i);

                       j++;

                  }

                  k++;

             }

             for(int i=0;i<shu.length;i++) {

                  switch(shu[i]) {

                  case 'a':zimu[0]='a';count[0]++;break;

                  case 'b':zimu[1]='b';count[1]++;break;

                  case 'c':zimu[2]='c';count[2]++;break;

                  case 'd':zimu[3]='d';count[3]++;break;

                  case 'e':zimu[4]='e';count[4]++;break;

                  case 'f':zimu[5]='f';count[5]++;break;

                  case 'g':zimu[6]='g';count[6]++;break;

                  case 'h':zimu[7]='h';count[7]++;break;

                  case 'i':zimu[8]='i';count[8]++;break;

                  case 'j':zimu[9]='j';count[9]++;break;

                  case 'k':zimu[10]='k';count[10]++;break;

                  case 'l':zimu[11]='l';count[11]++;break;

                  case 'm':zimu[12]='m';count[12]++;break;

                  case 'n':zimu[13]='n';count[13]++;break;

                  case 'o':zimu[14]='o';count[14]++;break;

                  case 'p':zimu[15]='p';count[15]++;break;

                  case 'q':zimu[16]='q';count[16]++;break;

                  case 'r':zimu[17]='r';count[17]++;break;

                  case 's':zimu[18]='s';count[18]++;break;

                  case 't':zimu[19]='t';count[19]++;break;

                  case 'u':zimu[20]='u';count[20]++;break;

                  case 'v':zimu[21]='v';count[21]++;break;

                  case 'w':zimu[22]='w';count[22]++;break;

                  case 'x':zimu[23]='x';count[23]++;break;

                  case 'y':zimu[24]='y';count[24]++;break;

                  case 'z':zimu[25]='z';count[25]++;break;

                  case 'A':zimu[26]='A';count[26]++;break;

                  case 'B':zimu[27]='B';count[27]++;break;

                  case 'C':zimu[28]='C';count[28]++;break;

                  case 'D':zimu[29]='D';count[29]++;break;

                  case 'E':zimu[30]='E';count[30]++;break;

                  case 'F':zimu[31]='F';count[31]++;break;

                  case 'G':zimu[32]='G';count[32]++;break;

                  case 'H':zimu[33]='H';count[33]++;break;

                  case 'I':zimu[34]='I';count[34]++;break;

                  case 'J':zimu[35]='G';count[35]++;break;

                  case 'K':zimu[36]='K';count[36]++;break;

                  case 'L':zimu[37]='L';count[37]++;break;

                  case 'M':zimu[38]='M';count[38]++;break;

                  case 'N':zimu[39]='N';count[39]++;break;

                  case 'O':zimu[40]='O';count[40]++;break;

                  case 'P':zimu[41]='P';count[41]++;break;

                  case 'Q':zimu[42]='Q';count[42]++;break;

                  case 'R':zimu[43]='R';count[43]++;break;

                  case 'S':zimu[44]='S';count[44]++;break;

                  case 'T':zimu[45]='T';count[45]++;break;

                  case 'U':zimu[46]='U';count[46]++;break;

                  case 'V':zimu[47]='V';count[47]++;break;

                  case 'W':zimu[48]='W';count[48]++;break;

                  case 'X':zimu[49]='X';count[49]++;break;

                  case 'Y':zimu[50]='Y';count[50]++;break;

                  case 'Z':zimu[51]='Z';count[51]++;

                  }

             }

             int ci=0;

             int sum=0;

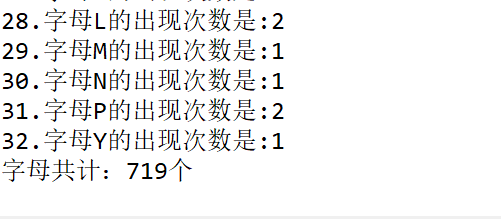
             System.out.println("短文中各字母出现情况统计如下:");

             for(int i=0;i<52;i++)

             {

                 if(count[i]!=0) {

                     ci++;

                     sum+=count[i];

                     System.out.println(ci+".字母"+zimu[i]+"的出现次数是:"+count[i]);

                     }

             }

             System.out.println("字母共计:"+sum+"个");

         }catch (Exception e) {

             e.printStackTrace();

         }

     }

 }
测试文档:
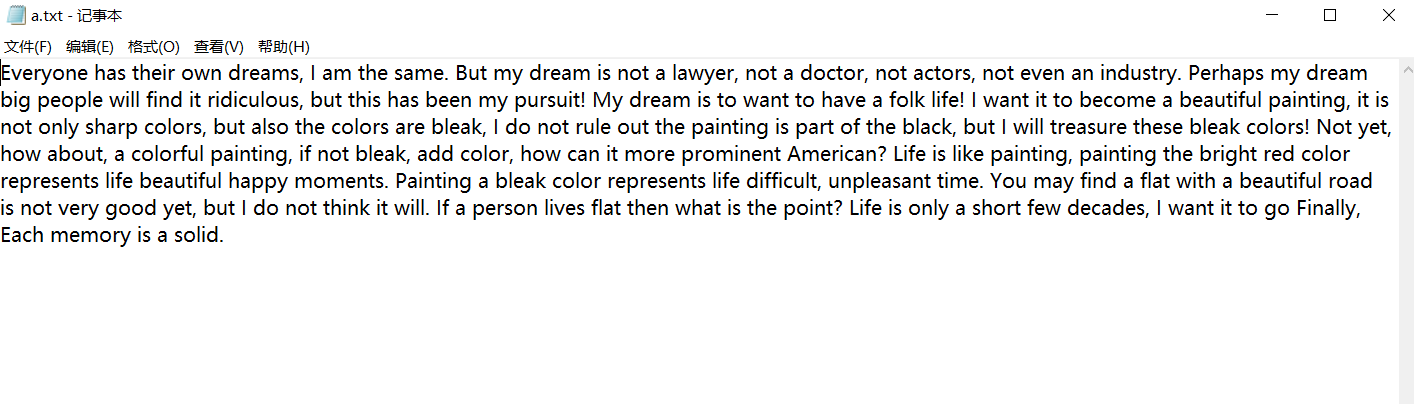
运行截图:

构成思路:
一,利用输入流从文本文档读入字符串;
二,利用方法charAT(),将字符串转换为字符数组;
三,利用for循环和switch语句统计字母次数
四,输出结果。
文本文档中各字母出现次数汇总(java)的更多相关文章
- Java 写一段字符到指定的文本文档中,如果该文本文档不存在,则创建该文本文档
写一段字符到指定的文本文档中,如果该文本文档不存在,则创建该文本文档 import java.io.File; import java.io.FileNotFoundException; import ...
- 编写Java程序,读取文本文档的内容,去除文本中包含的“广告”字样,把更改后的内容保存到一个新的文本文档中
查看本章节 查看作业目录 需求说明: 读取文本文档的内容,去除文本中包含的"广告"字样,把更改后的内容保存到一个新的文本文档中 实现思路: 在main() 方法中,使用 new F ...
- 使用 AWK 去掉文本文档中的空白行
在 Linux 操作系统中,可以使用 AWK 命令高效地处理文本文档.AWK 命令通过执行使用 AWK 语言编写的脚本程序,处理文本文档.AWK 脚本程序是由模式(patterns)与相关操作(cor ...
- Java 单字节、多字节读取文本文档中的内容
文本文档位于工程下. 鼠标右击工程,选择“new - File”,即可创建. 文本文档的格式:GBK 单字节读取 import java.io.File; import java.io.FileInp ...
- Java提取文本文档中的所有网址(小案例介绍正则基础知识)
正则表达式基础以及Java中使用正则查找 定义: 正则表达式是一些用来匹配和处理文本的字符串 正则的基础(先大致了解下) 1. 正则表达式的作用 查找特定的信息(搜索) 替换一些文本(替换) 2. 正 ...
- oracle数据库中将clob字段内容利用java提取出至文本文档中
代码段: 1.执行clob转String public static String ClobToString(Clob sc) throws SQLException, IOException { S ...
- 过滤文本文档中的数据并插入Cassandra数据库
代码如下: package com.locationdataprocess; import java.io.BufferedReader; import java.io.File; import ja ...
- python 读取文本文档中的数据
import os dir = input('Please input the file dir:')#提示输入文件路径 while not os.path.exists(dir):#判断文件是否存在 ...
- jenkins job构建后汇总结果到同一个文本文档中去
jenkins 构建后,执行下shell脚本,把结果汇总到同一个文件中,这样多个job构建后的结果可以在一个文件中展示 result_all_dir="/app/jenkins_result ...
随机推荐
- c/c++ 广义表
广义表 列表里面有列表,比如(1,(2,(3,4)),5) 用链表可以实现 结果如图 guangyibiao.h #ifndef __GUANGYIBIAO__ #define __GUANGYIBI ...
- JavaScript -- 时光流逝(九):Window 对象、Navigator 对象
JavaScript -- 知识点回顾篇(九):Window 对象.Navigator 对象 1. Window 对象 1.1 Window 对象的属性 (1) closed: 返回窗口是否已被关闭. ...
- C# -- 接口 (关键字:interface)
C#: 接口(关键字:interface) 1.代码(入门举例) class Program { static void Main(string[] args) { Console.WriteLine ...
- C语言 投票系统:给定候选人,从键盘输入候选人的名字,统计票数,并输出最终获胜者
投票系统:给定候选人名单,从键盘输入候选人的名字,统计票数,并输出最终获胜者.若投票人输入的名字不在其候选名单上,则该票数无效. //凯鲁嘎吉 - 博客园 http://www.cnblogs.com ...
- 【Linux基础】VI命令模式下大小写转换
[开始位置] ---- 可以指定开始的位置,默认是光标的当前位置 gu ---- 把选择范围全部小写 gU ---- 把选择范围全部大写 [结束位置] ---- 可以跟着类似的w,6G,gg等定位到错 ...
- Mysql的用户管理
- 连接rabbitmq
#消费者import pika # 连接服务器 credentials = pika.PlainCredentials('*****', '***') connection = pika.Blocki ...
- Unicode与UTF-8关系
Unicode字符集合 Unicode 也称为 UCS(Universal Coded Character Set:国际编码字符集合) 是一个字符集合. 对世界上大部分的文字系统进行了整理,编码,使电 ...
- 搭建golang学习环境,并用chrome headless获取网页内容
想用go练练手(我是win7系统,已从https://studygolang.com/dl 下载了go安装包并安装,比较简单,不详述. 但作为边民,没法go get ,又不敢用梯子,幸亏有爱心大牛们的 ...
- php面试中的经典问题
原文:https://blog.csdn.net/ghostlv/article/details/51284745 问题一问题描述考虑下面代码: $str1 = 'yabadabadoo';$str2 ...