
第10讲:Flink Side OutPut 分流
Flink系列文章
- 第01讲:Flink 的应用场景和架构模型
- 第02讲:Flink 入门程序 WordCount 和 SQL 实现
- 第03讲:Flink 的编程模型与其他框架比较
- 第04讲:Flink 常用的 DataSet 和 DataStream API
- 第05讲:Flink SQL & Table 编程和案例
- 第06讲:Flink 集群安装部署和 HA 配置
- 第07讲:Flink 常见核心概念分析
- 第08讲:Flink 窗口、时间和水印
- 第09讲:Flink 状态与容错
关注公众号:
大数据技术派,回复资料,领取1024G资料。
这一课时将介绍 Flink 中提供的一个很重要的功能:旁路分流器。
分流场景
我们在生产实践中经常会遇到这样的场景,需把输入源按照需要进行拆分,比如我期望把订单流按照金额大小进行拆分,或者把用户访问日志按照访问者的地理位置进行拆分等。面对这样的需求该如何操作呢?
分流的方法
通常来说针对不同的场景,有以下三种办法进行流的拆分。
Filter 分流
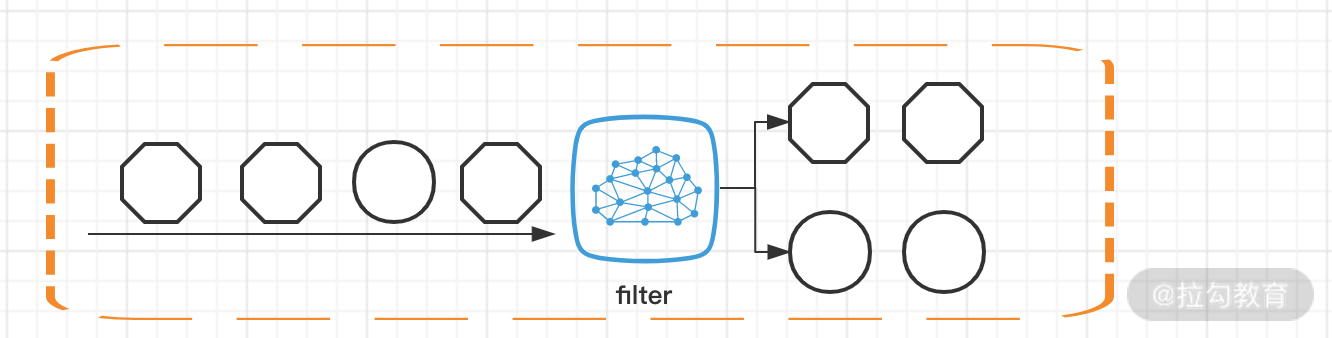
Filter 方法我们在第 04 课时中(Flink 常用的 DataSet 和 DataStream API)讲过,这个算子用来根据用户输入的条件进行过滤,每个元素都会被 filter() 函数处理,如果 filter() 函数返回 true 则保留,否则丢弃。那么用在分流的场景,我们可以做多次 filter,把我们需要的不同数据生成不同的流。
来看下面的例子:
复制代码
public static void main(String[] args) throws Exception {

    StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

    //获取数据源

    List data = new ArrayList<Tuple3<Integer,Integer,Integer>>();

    data.add(new Tuple3<>(0,1,0));

    data.add(new Tuple3<>(0,1,1));

    data.add(new Tuple3<>(0,2,2));

    data.add(new Tuple3<>(0,1,3));

    data.add(new Tuple3<>(1,2,5));

    data.add(new Tuple3<>(1,2,9));

    data.add(new Tuple3<>(1,2,11));

    data.add(new Tuple3<>(1,2,13));

    DataStreamSource<Tuple3<Integer,Integer,Integer>> items = env.fromCollection(data);

    SingleOutputStreamOperator<Tuple3<Integer, Integer, Integer>> zeroStream = items.filter((FilterFunction<Tuple3<Integer, Integer, Integer>>) value -> value.f0 == 0);

    SingleOutputStreamOperator<Tuple3<Integer, Integer, Integer>> oneStream = items.filter((FilterFunction<Tuple3<Integer, Integer, Integer>>) value -> value.f0 == 1);

    zeroStream.print();

    oneStream.printToErr();

    //打印结果

    String jobName = "user defined streaming source";

    env.execute(jobName);

}
在上面的例子中我们使用 filter 算子将原始流进行了拆分,输入数据第一个元素为 0 的数据和第一个元素为 1 的数据分别被写入到了 zeroStream 和 oneStream 中,然后把两个流进行了打印。
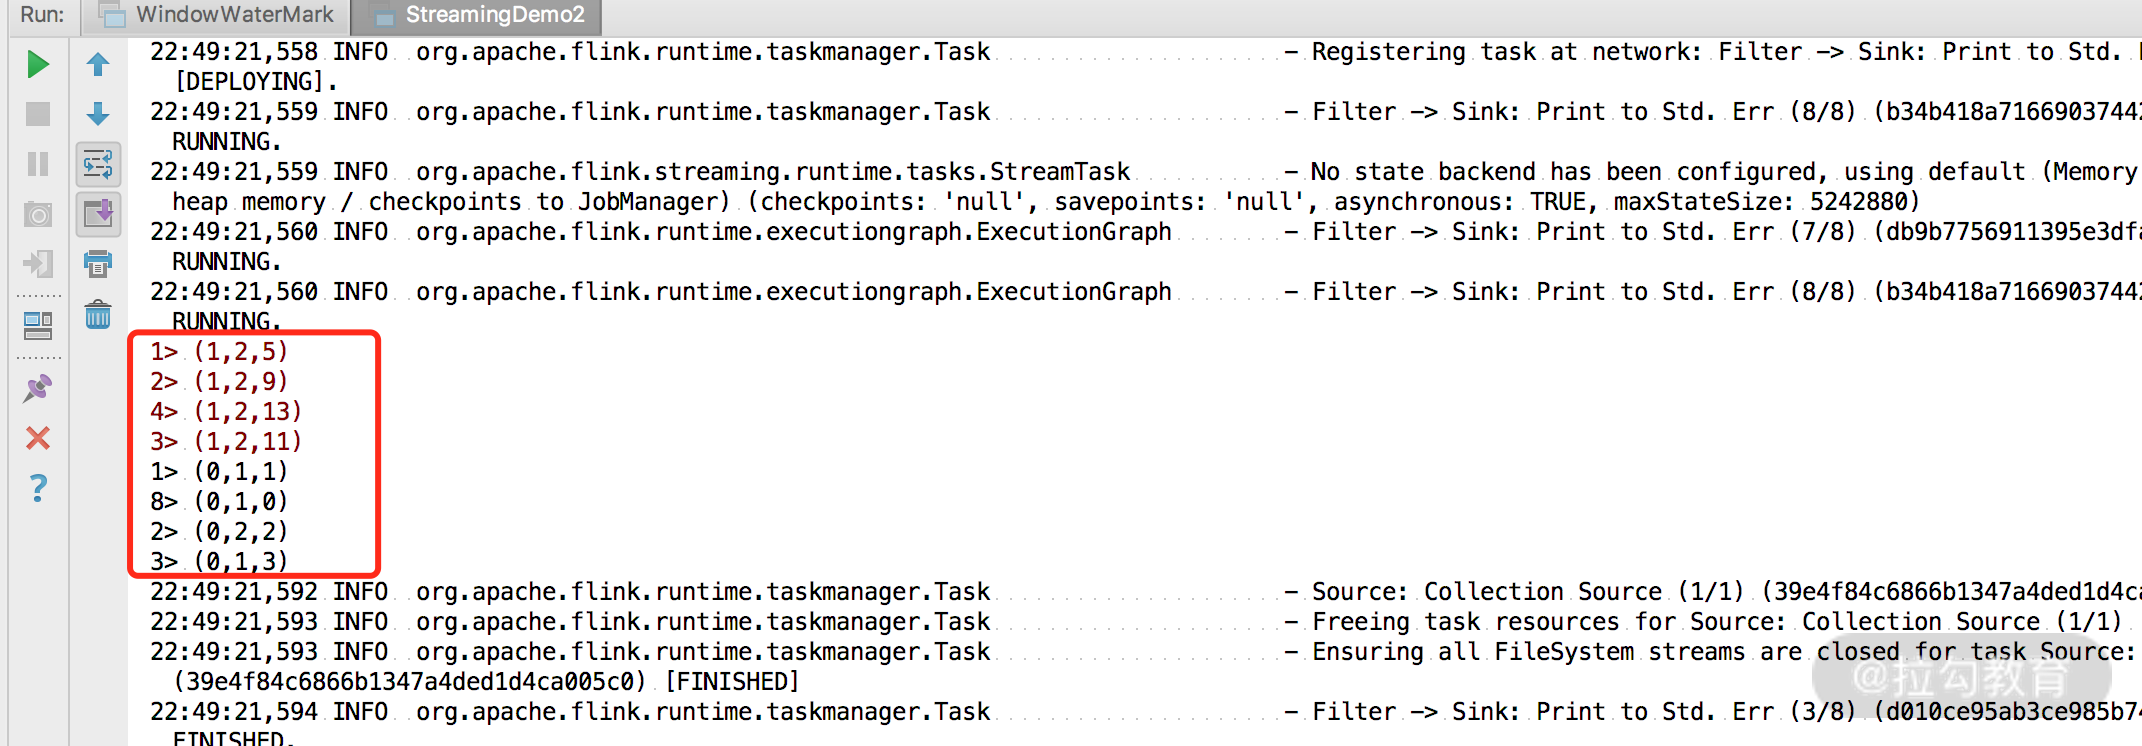
可以看到 zeroStream 和 oneStream 分别被打印出来。
Filter 的弊端是显而易见的,为了得到我们需要的流数据,需要多次遍历原始流,这样无形中浪费了我们集群的资源。
Split 分流
Split 也是 Flink 提供给我们将流进行切分的方法,需要在 split 算子中定义 OutputSelector,然后重写其中的 select 方法,将不同类型的数据进行标记,最后对返回的 SplitStream 使用 select 方法将对应的数据选择出来。
我们来看下面的例子:
复制代码
public static void main(String[] args) throws Exception {

    StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

    //获取数据源

    List data = new ArrayList<Tuple3<Integer,Integer,Integer>>();

    data.add(new Tuple3<>(0,1,0));

    data.add(new Tuple3<>(0,1,1));

    data.add(new Tuple3<>(0,2,2));

    data.add(new Tuple3<>(0,1,3));

    data.add(new Tuple3<>(1,2,5));

    data.add(new Tuple3<>(1,2,9));

    data.add(new Tuple3<>(1,2,11));

    data.add(new Tuple3<>(1,2,13));

    DataStreamSource<Tuple3<Integer,Integer,Integer>> items = env.fromCollection(data);

    SplitStream<Tuple3<Integer, Integer, Integer>> splitStream = items.split(new OutputSelector<Tuple3<Integer, Integer, Integer>>() {

        @Override

        public Iterable<String> select(Tuple3<Integer, Integer, Integer> value) {

            List<String> tags = new ArrayList<>();

            if (value.f0 == 0) {

                tags.add("zeroStream");

            } else if (value.f0 == 1) {

                tags.add("oneStream");

            }

            return tags;

        }

    });

    splitStream.select("zeroStream").print();

    splitStream.select("oneStream").printToErr();

    //打印结果

    String jobName = "user defined streaming source";

    env.execute(jobName);

}
同样,我们把来源的数据使用 split 算子进行了切分,并且打印出结果。

但是要注意,使用 split 算子切分过的流,是不能进行二次切分的,假如把上述切分出来的 zeroStream 和 oneStream 流再次调用 split 切分,控制台会抛出以下异常。
复制代码
Exception in thread "main" java.lang.IllegalStateException: Consecutive multiple splits are not supported. Splits are deprecated. Please use side-outputs.
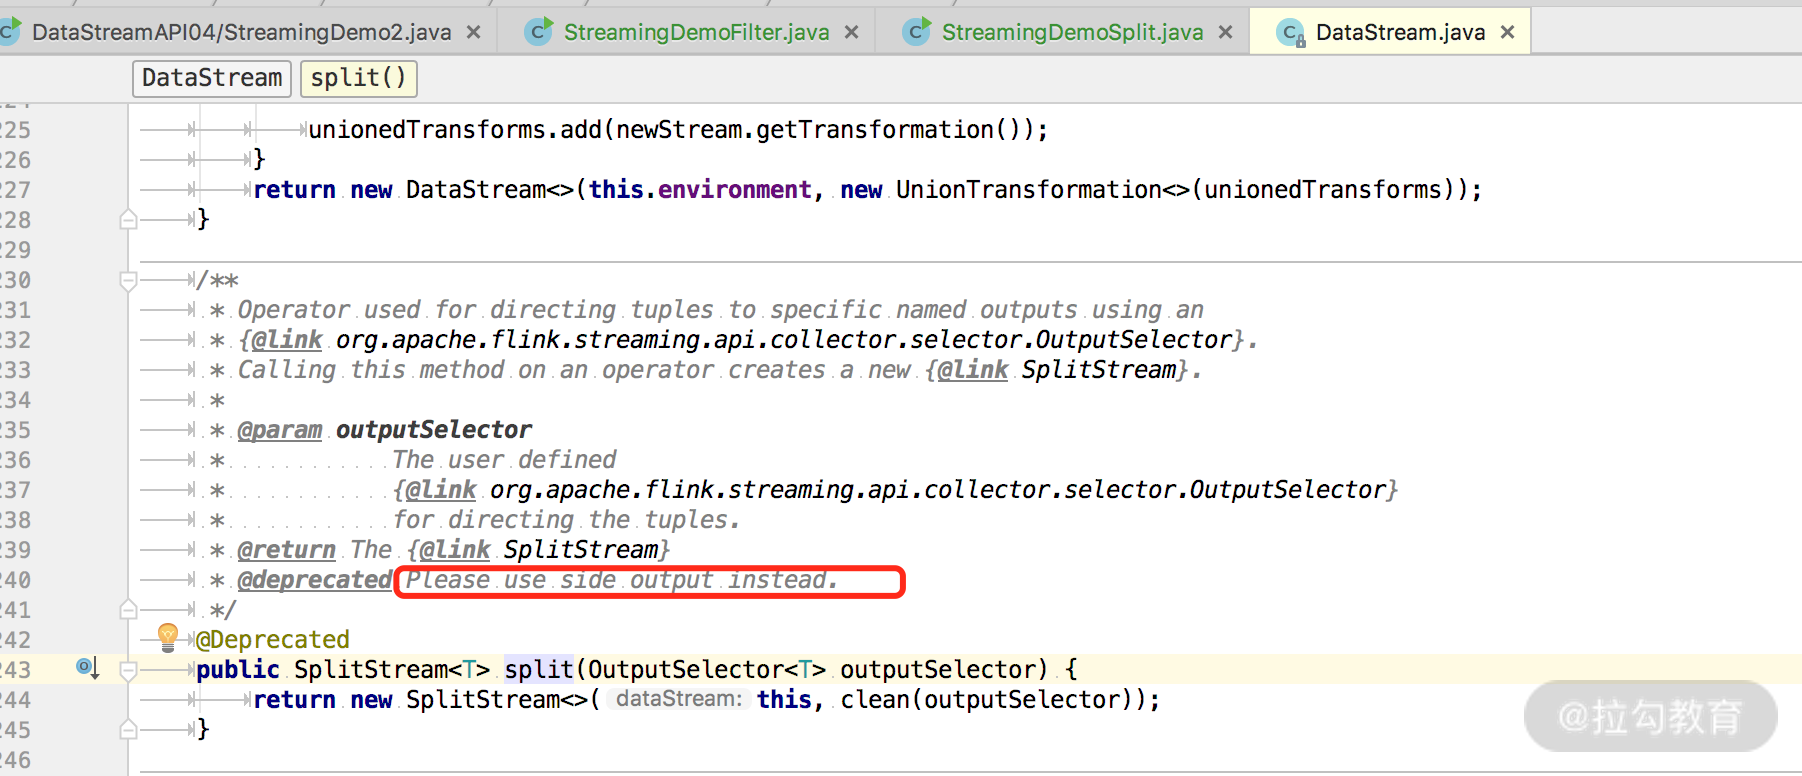
这是什么原因呢?我们在源码中可以看到注释,该方式已经废弃并且建议使用最新的 SideOutPut 进行分流操作。
SideOutPut 分流
SideOutPut 是 Flink 框架为我们提供的最新的也是最为推荐的分流方法,在使用 SideOutPut 时,需要按照以下步骤进行:
- 定义 OutputTag
- 调用特定函数进行数据拆分
- ProcessFunction
- KeyedProcessFunction
- CoProcessFunction
- KeyedCoProcessFunction
- ProcessWindowFunction
- ProcessAllWindowFunction
在这里我们使用 ProcessFunction 来讲解如何使用 SideOutPut:
复制代码
public static void main(String[] args) throws Exception {

    StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

    //获取数据源

    List data = new ArrayList<Tuple3<Integer,Integer,Integer>>();

    data.add(new Tuple3<>(0,1,0));

    data.add(new Tuple3<>(0,1,1));

    data.add(new Tuple3<>(0,2,2));

    data.add(new Tuple3<>(0,1,3));

    data.add(new Tuple3<>(1,2,5));

    data.add(new Tuple3<>(1,2,9));

    data.add(new Tuple3<>(1,2,11));

    data.add(new Tuple3<>(1,2,13));

    DataStreamSource<Tuple3<Integer,Integer,Integer>> items = env.fromCollection(data);

    OutputTag<Tuple3<Integer,Integer,Integer>> zeroStream = new OutputTag<Tuple3<Integer,Integer,Integer>>("zeroStream") {};

    OutputTag<Tuple3<Integer,Integer,Integer>> oneStream = new OutputTag<Tuple3<Integer,Integer,Integer>>("oneStream") {};

    SingleOutputStreamOperator<Tuple3<Integer, Integer, Integer>> processStream= items.process(new ProcessFunction<Tuple3<Integer, Integer, Integer>, Tuple3<Integer, Integer, Integer>>() {

        @Override

        public void processElement(Tuple3<Integer, Integer, Integer> value, Context ctx, Collector<Tuple3<Integer, Integer, Integer>> out) throws Exception {

            if (value.f0 == 0) {

                ctx.output(zeroStream, value);

            } else if (value.f0 == 1) {

                ctx.output(oneStream, value);

            }

        }

    });

    DataStream<Tuple3<Integer, Integer, Integer>> zeroSideOutput = processStream.getSideOutput(zeroStream);

    DataStream<Tuple3<Integer, Integer, Integer>> oneSideOutput = processStream.getSideOutput(oneStream);

    zeroSideOutput.print();

    oneSideOutput.printToErr();

    //打印结果

    String jobName = "user defined streaming source";

    env.execute(jobName);

}
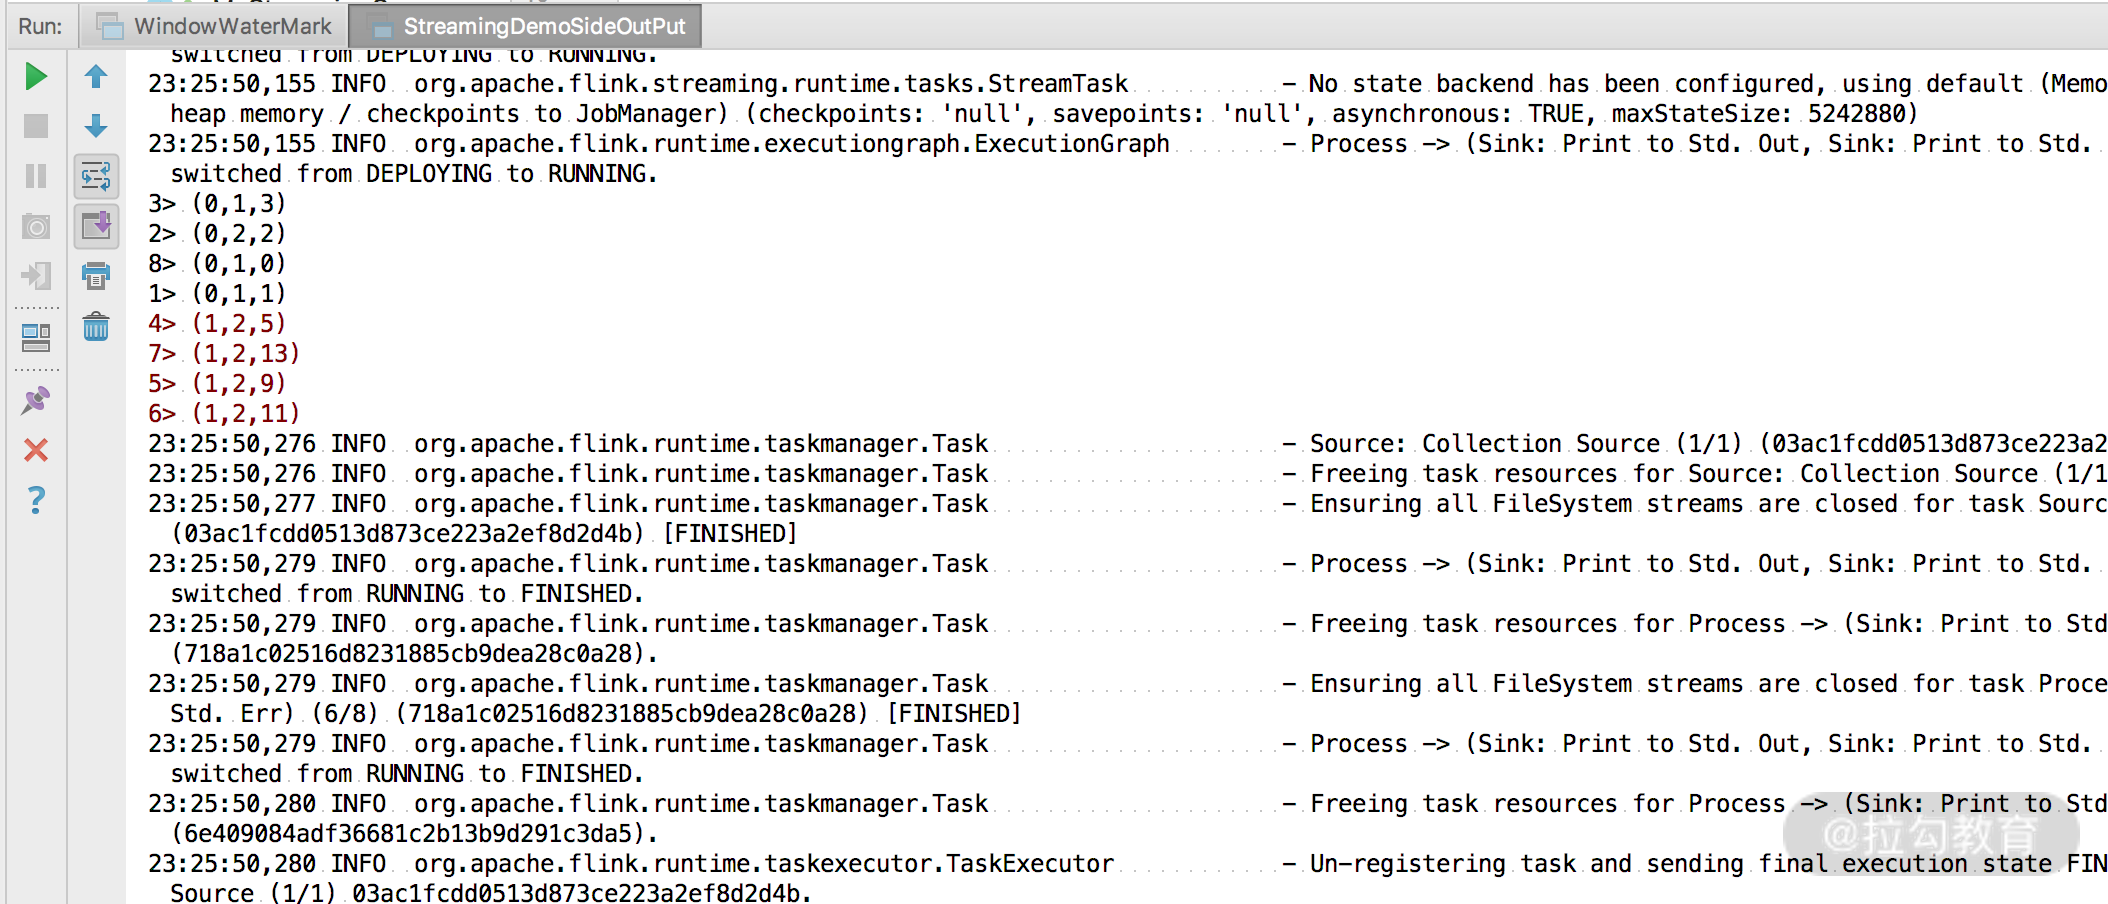
可以看到,我们将流进行了拆分,并且成功打印出了结果。这里要注意,Flink 最新提供的 SideOutPut 方式拆分流是可以多次进行拆分的,无需担心会爆出异常。
总结
这一课时我们讲解了 Flink 的一个小的知识点,是我们生产实践中经常遇到的场景,Flink 在最新的版本中也推荐我们使用 SideOutPut 进行流的拆分。
关注公众号:
大数据技术派,回复资料,领取1024G资料。
第10讲:Flink Side OutPut 分流的更多相关文章
- [ionic开源项目教程] - 第10讲 新闻详情页的用户体验优化
目录 [ionic开源项目教程] 第1讲 前言,技术储备,环境搭建,常用命令 [ionic开源项目教程] 第2讲 新建项目,架构页面,配置app.js和controllers.js [ionic开源项 ...
- 第10讲- UI线程阻塞及其优化
第10讲UI线程阻塞及其优化 .UI 阻塞demo (首先在activity_main.xml中放置两个button,分别命名为button1,button2) //首先设置一个button1用来进行 ...
- JVM基础系列第10讲:垃圾回收的几种类型
我们经常会听到许多垃圾回收的术语,例如:Minor GC.Major GC.Young GC.Old GC.Full GC.Stop-The-World 等.但这些 GC 术语到底指的是什么,它们之间 ...
- 第10讲-Java集合框架
第10讲 Java集合框架 1.知识点 1.1.课程回顾 1.2.本章重点 1.2.1 List 1.2.2 Set 1.2.3 Map 2.具体内容 2.1.Java集合框架 2.1.1 为什么需要 ...
- [VirtualBox] Install Ubuntu 14.10 error 5 Input/output error
After you download the VirtualBox install package and install it (just defualt setting). Then you sh ...
- PHP学习之[第10讲]PHP 的 Mysql 数据库函数 (微型博客系统)II
mysql结构如下: -- phpMyAdmin SQL Dump -- version 4.4.1.1 -- http://www.phpmyadmin.net -- -- Host: localh ...
- 《Tsinghua oc mooc》第8~10讲 虚拟内存管理
资源 OS2018Spring课程资料首页 uCore OS在线实验指导书 ucore实验基准源代码 MOOC OS习题集 OS课堂练习 Piazza问答平台 暂时无法注册 第八讲 虚拟内存概念 为什 ...
- flink系列-10、flink保证数据的一致性
本文摘自书籍<Flink基础教程> 一.一致性的三种级别 当在分布式系统中引入状态时,自然也引入了一致性问题.一致性实际上是“正确性级别”的另一种说法,即在成功处理故障并恢复之后得到的结果 ...
- 第10讲:利用SQL语言实现关系代数操作
一.实现并.交.差运算 1. 基本语法形式:子查询 [union [all] | intersect [all] | except [all] 子查询] ①意义:将关系代数中的∪.∩.- 分别用uni ...
随机推荐
- Azure Terraform(九)GitHub Actions 实现 Infra 资源的自动化部署
思路浅析 使用 Terraform Code 部署 Azure 基础设施资源是特别受欢迎的,我曾经有写文章分享过利用 Azure DevOps 自动部署 Terraform Code 所描述的 Azu ...
- sqlplus -S参数表示什么意思?
sqlplus -S , -S选项是静默模式,是Silent的缩写.在这种模式下将会以最精简的形式完成SQL*Plus的交互过程. -S模式多用于脚本模式.在命令行sqlplus -S还有可能出现卡住 ...
- Hive的分析函数的使用
原文: https://www.toutiao.com/i6769120000578945544/?group_id=6769120000578945544 我们先准备数据库.表和数据 开窗分析函数相 ...
- stm32单片机利用ntc热敏电阻温度转换公式C语言版
首先 我们需要明确电路结构 热敏电阻的原理就不再赘述,本文不凑字数,只讲干货 必须要知道的就是串联电阻R9程序中定义为resistanceInSeries ,精度越高越好 为了方便,先在程序中定义好你 ...
- Ubuntu 桌面版使用总结
最近拿出了大学时买的性(游)能(戏)本(机),其实从直观来看,硬件基础还是不错的,但是跑 WIN10, 清了各种广告,关了各种无效进城之后,用起来仍然还是很不爽.可能是已经用惯 mac 了吧,mac给 ...
- Javascript实现全选按钮
Javascript实现全选按钮 效果:有全选选项框和单个选项框,选择全选框,所有的的选择都打上的钩,取消全选钩所有的都去掉了钩,如果取消其中某一个的钩,那么全选的钩也取消,反之全选所有的选项,那么全 ...
- [开发笔记usbTOcan]系统架构设计
SYS.3 | 系统架构设计 系统架构设计过程的目的是建立一个系统体系结构设计,并确定哪些系统需求分配给系统的哪些元素,并根据确定的标准评估系统架构. 系统结构设计需要做一下工作: 开发系统架构设计. ...
- csapp lab2 拆炸弹
1. 实验内容 包含一个二进制应用bomb,需要根据该应用猜测程序的运行过程.程序主体包含了六个函数phase_1到phase_6,每个函数会根据用户的输入做出反应,当输入符合要求时,会炸弹拆解成功, ...
- Gradle下载安装教程
前言 1.gradle和maven一样都是用来构建java程序的,maven2004年开始兴起,gradle2012年开始诞生,既然已经有了maven这么成熟的构建工具为什么还有gradle的诞生呢, ...
- SDCC 的 MCS-51 汇编基础概念和传参方式
寄存器 Register 寄存器用于数据的临时存储, 其数据可以表示为 用于处理的数据字节 指向数据的地址 寄存器的结构 8051的寄存器几乎都是8位寄存器, 因为8位MCU处理的主要是8位数据, 如 ...