
Bilateral Multi-Perspective Matching for Natural Language Sentences---读书笔记
- 自然语言句子的双向、多角度匹配,是来自IBM 2017 年的一篇文章。代码github地址:https://github.com/zhiguowang/BiMPM
- 摘要
- 自然语言句子匹配(Natural language sentence matching ,NLSM)是比较两个句子并且识别它们的关系的任务。
- NLSM 一般有两种架构来解决:
- BiMPM 属于 匹配聚合框架。
- 之前的 匹配聚合框架的局限性:
- BiMPM 对以上的两个局限性进行了改进。
- 任务的定义:
- BiMPM 架构图

- word representstion layer(词表达层):
- context representation layer(上下文表达层):
- matching layer(匹配层)
- aggregation layer(聚合层):
- prediction layer(预测层):
- Multi-perspective Matching Operation(多角度匹配操作):
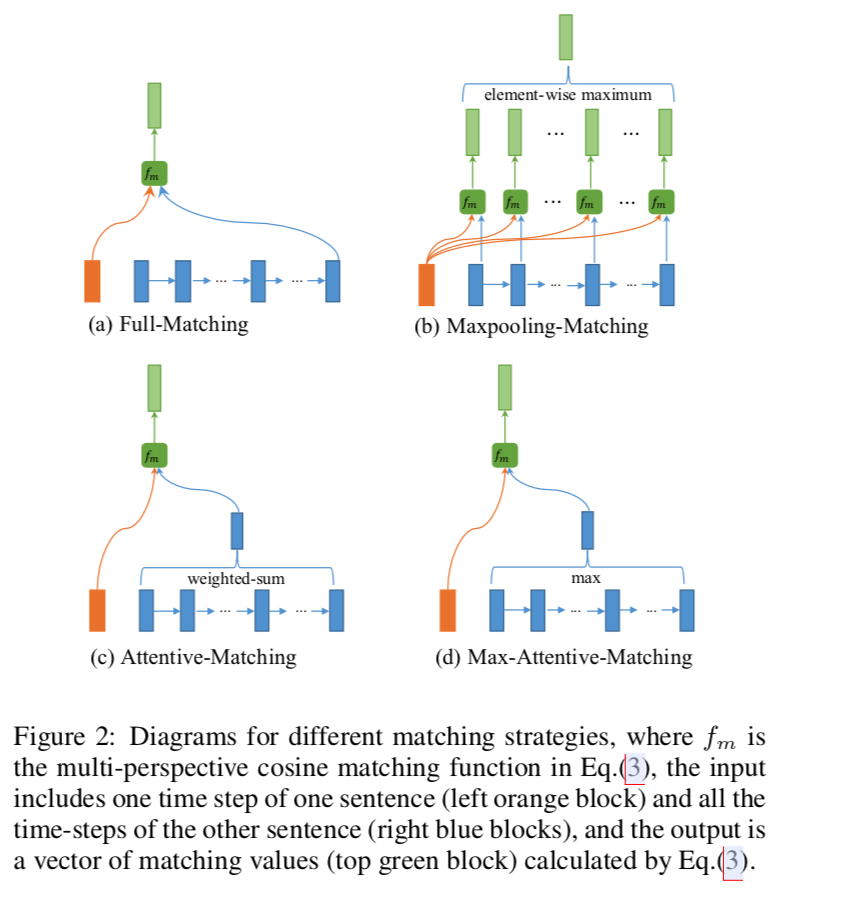
- 实验参数设置:
- Quora Question Pairs(https://www.kaggle.com/quora/question-pairs-dataset)
- quora dataset 训练/验证/测试集的选取
Bilateral Multi-Perspective Matching for Natural Language Sentences---读书笔记的更多相关文章
- 《Bilateral Multi-Perspective Matching for Natural Language Sentences》(句子匹配)
问题: Natural language sentence matching (NLSM),自然语言句子匹配,是指比较两个句子并判断句子间关系,是许多任务的一项基本技术.针对NLSM任务,目前有两种流 ...
- BiMPM:Bilateral Multi-Perspctive Matching for Natural Language Sentences
导言 本论文的工作主要是在 'matching-aggregation'的sentence matching的框架下,通过增加模型的特征(实现P与Q的双向匹配和多视角匹配),来增加NLSM(Natur ...
- Convolutional Neural Network Architectures for Matching Natural Language Sentences
interaction n. 互动;一起活动;合作;互相影响 capture vt.俘获;夺取;夺得;引起(注意.想像.兴趣)n.捕获;占领;捕获物;[计算机]捕捉 hence adv. 从此;因 ...
- 《Convolutional Neural Network Architectures for Matching Natural Language Sentences》句子匹配
模型结构与原理 1. 基于CNN的句子建模 这篇论文主要针对的是句子匹配(Sentence Matching)的问题,但是基础问题仍然是句子建模.首先,文中提出了一种基于CNN的句子建模网络,如下图: ...
- 《The C Programming Language》读书笔记(一)
1. 对这本书的印象 2011年进入大学本科,C语言入门书籍如果我没记错的话应该是谭浩强的<C程序设计>,而用现在的眼光来看,这本书只能算是一本可用的教材,并不能说是一本好书.在自学操作系 ...
- 《PC Assembly Language》读书笔记
本书下载地址:pcasm-book. 前言 8086处理器只支持实模式(real mode),不能满足安全.多任务等需求. Q:为什么实模式不安全.不支持多任务?为什么虚模式能解决这些问题? A: 以 ...
- Parsing Natural Scenes and Natural Language with Recursive Neural Networks-paper
Parsing Natural Scenes and Natural Language with Recursive Neural Networks作者信息: Richard Socher richa ...
- <Natural Language Processing with Python>学习笔记一
Spoken input (top left) is analyzed, words are recognized, sentences are parsed and interpreted in c ...
- (zhuan) Speech and Natural Language Processing
Speech and Natural Language Processing obtain from this link: https://github.com/edobashira/speech-l ...
随机推荐
- Linux使用帮助详解
主要内容: whatis command --help man and info ...
- [唐胡璐]Selenium技巧- 如何处理Table
由于webdriver中没有专门的table类,所以我们需要简单的封装出一个易用易扩展的Table类来帮助简化代码。 以下是我之前用C#语言来实现的一个简单的封装: 只是一个大概的思路,有些具体实现就 ...
- Interleaving String (DP)
Given s1, s2, s3, find whether s3 is formed by the interleaving of s1 and s2. For example, Given:s1 ...
- C#中的@符号的使用
一 字符串中的用法 字符@表示,其后的字符串是个“逐字字符串”(verbatim string). @只能对字符串常量作用. 1.用于文件路径 string s_FilePath ="C:\ ...
- 025_自动为其他脚本添加解释器信息#!/bin/bash
#!/bin/bash#先使用 grep 判断对象脚本是否已经有解释器信息,如果没有则使用 sed 添加解释器以及描述信息if ! grep -q "^#!" $1; then # ...
- java实现大文件上传和下载
[文件上传和下载]是很多系统必备功能, 比如PM\OA\ERP等:系统中常见的开发模式有B/S和C/S,而前者主要是通过浏览器来访问web服务器,一般采用七层协议中的[应用层http]进行数据传输,后 ...
- 正则regex
Regual expression 普通正常字符 字符匹配 . 表示任意字符 匹配次数 位置锚定 分组及引用
- Gradle 如何配置将编译的 JAR 发布到 Archiva 中
有时候我们希望将我们的jar 开发包发布到 Archiva 中. 如何配置 Gradle 的编译脚本呢? 首先你需要启用 Gradle 的 Maven-publish 插件. plugins { id ...
- [USACO17JAN] 晋升者计数 dfs序+树状数组
[USACO17JAN] 晋升者计数 dfs序+树状数组 题面 洛谷P3605 题意:一棵有点权的树,找出树中所有\((u,v)\)的对数,其中\(u,v\)满足\(val(u)\le val(v)\ ...
- 数据分析之numpy使用
使用numpy生成数字 生成的类型是ndarray类型 t1 = np.array([1,2,3,4,5]) print(t1,type(t1)) # 类型为ndarray t2 = np.array ...