
Caffe : Layer Catalogue(1)
原文:http://caffe.berkeleyvision.org/tutorial/layers.html
参考:http://blog.csdn.net/u011762313/article/details/47361571#vision-layers
记:总感觉对于caffe是一知半解,要深入深度学习,以及更好的去工程和实验,详细学习caffe是必须的。
Layers
- 要想创建一个Caffe模型,需要在prototxt中定义一个model architecture(模型架构)。
- Caffe自带的Layer及其参数被定义在caffe.proto中。
Vision Layers
------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------
- 头文件: ./include/caffe/vision_layers.hpp
Vision layers 通常以图片images作为输入,运算后产生输出的也是图片images。对于图片而言,可能是单通道的(c=1),例如灰度图,或者三通道的 (c=3),例如RGB图。但是,对于Vision layers而言,最重要的特性是输入的spatial structure(空间结构)。2D的几何形状有助于输入处理,大部分的Vision layers工作是对于输入图片中的某一个区域做一个特定的处理,产生一个相应的输出。与此相反,其他大部分的layers会忽略输入的空间结构,而只是 将输入视为一个很大的向量,维度为: c*h*w。
Convolution
- 类型(type):Convolution(卷积层)
- CPU 实现: ./src/caffe/layers/convolution_layer.cpp
- CUDA、GPU实现: ./src/caffe/layers/convolution_layer.cu
- 参数 (convolution_param):
- 必要:
- num_output (c_o): the number of filters(滤波器数目)
- kernel_size (or kernel_h and kernel_w): specifies height and width of each filter(每一个滤波器的大小)
- 强烈推荐:
- weight_filler [default type: ‘constant’ value: 0](滤波器权重,默认为0)
可选:
- bias_term [default true]: specifies whether to learn and apply a
set of additive biases to the filter outputs(是否添加bias-偏置项,默认为True) - pad (or pad_h and pad_w) [default 0]: specifies the number of pixels
to (implicitly) add to each side of the input(为输入添加边界的像素大小,默认为0) - stride (or stride_h and stride_w) [default 1]: specifies the
intervals at which to apply the filters to the
input(每一次使用滤波器处理输入图片时,前后两次处理区域的间隔,即“步进”,默认为1) - group (g) [default 1]: If g > 1, we restrict the connectivity of
each filter to a subset of the input. Specifically, the input and output
channels are separated into g groups, and the ith output group channels
will be only connected to the ith input group
channels.(默认为1,如果大于1:将限制每一个滤波器只与输入的一部分连接。输入、输出通道会被分隔为不同的g个groups,并且第i个输出
group只会与第i个输出group相关)
- bias_term [default true]: specifies whether to learn and apply a
输入(Input)
- n * c_i * h_i * w_i
- 输出(Output)
n * c_o * h_o * w_o,其中h_o = (h_i + 2 * pad_h - kernel_h) / stride_h + 1;w_o类似
例子(详见 ./examples/imagenet/imagenet_train_val.prototxt)
layer {

  name: "conv1"                  # 名称:conv1

  type: "Convolution"            # 类型:卷积层

  bottom: "data"                 # 输入层:数据层

  top: "conv1"                   # 输出层:卷积层1

  # 滤波器(filters)的学习速率因子和衰减因子

  param { lr_mult:  decay_mult:  }

  # 偏置项(biases)的学习速率因子和衰减因子

  param { lr_mult:  decay_mult:  }

  convolution_param {

    num_output:                # 96个滤波器(filters)

    kernel_size:               # 每个滤波器(filters)大小为11*

    stride:                     # 每次滤波间隔为4个像素

    weight_filler {

      type: "gaussian"           # 初始化高斯滤波器(Gaussian)

      std: 0.01                  # 标准差为0., 均值默认为0

    }

    bias_filler {

      type: "constant"           # 初始化偏置项(bias)为零

      value:

    }

  }

}
卷积层(The Convolution layer)利用一系列具有学习功能的滤波器(learnable filters)对输入的图像进行卷积操作,每一个滤波器(filter)对于一个特征(feature )会产生一个输出图像(output image)。
Pooling
- 类型(type):Pooling(池化层)
- CPU 实现: ./src/caffe/layers/pooling_layer.cpp
- CUDA、GPU实现: ./src/caffe/layers/pooling_layer.cu
参数 (pooling_param):
- 必要:
- kernel_size (or kernel_h and kernel_w): specifies height and width of each filter(每一个滤波器的大小)
- 可选:
- pool [default MAX]: the pooling method. Currently MAX, AVE, or STOCHASTIC(pooling方法,目前有MAX、AVE,和STOCHASTIC三种,默认为MAX)
- pad (or pad_h and pad_w) [default 0]: specifies the number of pixels
to (implicitly) add to each side of the input(为输入添加边界的像素大小,默认为0) - stride (or stride_h and stride_w) [default 1]: specifies the
intervals at which to apply the filters to the
input(每一次使用滤波器处理输入图片时,前后两次处理区域的间隔,即“步进”,默认为1)
- 必要:
输入(Input)
- n * c_i * h_i * w_i
输出(Output)
- n * c_o * h_o * w_o,其中h_o = (h_i + 2 * pad_h - kernel_h) / stride_h + 1;w_o类似
例子(详见 ./examples/imagenet/imagenet_train_val.prototxt)
layer {

  name: "pool1"                 # 名称:pool1

  type: "Pooling"               # 类型:池化层

  bottom: "conv1"               # 输入层:卷积层conv1

  top: "pool1"                  # 输出层:池化层pool1

  pooling_param {

    pool: MAX                   # pool方法:MAX

    kernel_size:               # 每次pool区域为3*3像素大小

    stride:                    # pool步进为2

  }

}
Local Response Normalization (LRN)
- 类型(type):LRN(局部响应归一化层)
- CPU 实现: ./src/caffe/layers/lrn_layer.cpp
- CUDA、GPU实现: ./src/caffe/layers/lrn_layer.cu
- 参数 (lrn_param):
- 可选:
- local_size [default 5]: the number of channels to sum over (for
cross channel LRN) or the side length of the square region to sum over
(for within channel LRN)(对于cross channel LRN,表示需要求和的channel的数量;对于within channel LRN表示需要求和的空间区域的边长;默认为5) - alpha [default 1]: the scaling parameter(缩放参数,默认为1)
- beta [default 5]: the exponent(指数,默认为5)
- norm_region [default ACROSS_CHANNELS]: whether to sum over adjacent
channels (ACROSS_CHANNELS) or nearby spatial locaitons
(WITHIN_CHANNEL)(选择基准区域,是ACROSS_CHANNELS =>
相邻channels,还是WITHIN_CHANNEL => 同一 channel下的相邻空间区域;默认为ACROSS_CHANNELS)
- local_size [default 5]: the number of channels to sum over (for
- 可选:
LRN Layer对一个局部的输入区域进行归一化,有两种模式。ACROSS_CHANNELS模式,局部区域在相邻的channels之间拓展,不进行空间拓展,所以维度是local_size x 1 x 1。WITHIN_CHANNEL模式,局部区域进行空间拓展,但是是在不同的channels中,所以维度是1 x local_size x local_size。对于每一个 ,其中n是局部区域的大小,求和部分是对该输入值为中心的区域进行求和(必要时候可以补零)。
im2col
Im2col 是一个helper方法,用于将图片文件image转化为列矩阵,详细的细节不需要过多的了解。在Caffe中进行卷积操作,做矩阵乘法时,会用到Im2col方法。
---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------
Loss Layers
Caffe是通过最小化输出output与目标target之间的cost(loss)来驱动学习的。loss是由forward pass计算得出的,loss的gradient 是由backward pass计算得出的。
Softmax
- 类型(type):SoftmaxWithLoss(广义线性回归分析损失层)
Softmax Loss Layer计算的是输入的多项式回归损失(multinomial logistic loss of the softmax of its inputs)。可以当作是将一个softmax layer和一个multinomial logistic loss layer连接起来,但是计算出的gradient更可靠。
Sum-of-Squares / Euclidean
- 类型(type):EuclideanLoss(欧式损失层)
Euclidean loss layer计算两个不同输入之间的平方差之和,
Hinge / Margin
- 类型(type):HingeLoss
- CPU 实现: ./src/caffe/layers/hinge_loss_layer.cpp
- CUDA、GPU实现: 尚无
参数 (hinge_loss_param):
- 可选:
- norm [default L1]: the norm used. Currently L1, L2(可以选择使用L1范数或者L2范数;默认为L1)
- 可选:
输入(Input)
- n * c * h * w Predictions(预测值)
- n * 1 * 1 * 1 Labels(标签值)
输出(Output)
- 1 * 1 * 1 * 1 Computed Loss(计算得出的loss值)
例子
# 使用L1范数

layer {

  name: "loss"                  # 名称:loss

  type: "HingeLoss"             # 类型:HingeLoss

  bottom: "pred"                # 输入:预测值

  bottom: "label"               # 输入:标签值

}

# 使用L2范数

layer {

  name: "loss"                  # 名称:loss

  type: "HingeLoss"             # 类型:HingeLoss

  bottom: "pred"                # 输入:预测值

  bottom: "label"               # 输入:标签值

  top: "loss"                   # 输出:loss值

  hinge_loss_param {

    norm: L2                    # 使用L2范数

  }

}
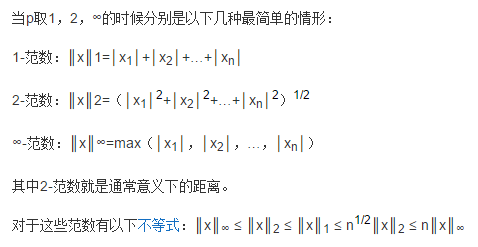
关于范数:
Sigmoid Cross-Entropy
- 类型(type):SigmoidCrossEntropyLoss
- (没有详解)
Infogain
- 类型(type):InfogainLoss
- (没有详解)
Accuracy and Top-k
- 类型(type):Accuracy
- 计算输出的准确率(相对于target),事实上这不是一个loss layer,并且也没有backward pass。
------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------
Activation / Neuron Layers
激励层的操作都是element-wise的操作(针对每一个输入blob产生一个相同大小的输出):
- 输入(Input)
- n * c * h * w
- 输出(Output)
- n * c * h * w
ReLU / Rectified-Linear and Leaky-ReLU
- 类型(type):ReLU
- CPU 实现: ./src/caffe/layers/relu_layer.cpp
- CUDA、GPU实现: ./src/caffe/layers/relu_layer.cu
参数 (relu_param):
- 可选:
- negative_slope [default 0]: specifies whether to leak the
negative part by multiplying it with the slope value rather than setting
it to 0.(但当输入x小于0时,指定输出为negative_slope * x;默认值为0)
- negative_slope [default 0]: specifies whether to leak the
- 可选:
例子(详见 ./examples/imagenet/imagenet_train_val.prototxt)
layer {

  name: "relu1"

  type: "ReLU"

  bottom: "conv1"

  top: "conv1"

}
给定一个输入值x,ReLU layer的输出为:x > 0 ? x : negative_slope * x,如未给定参数negative_slope 的值,则为标准ReLU方法:max(x, 0)。ReLU layer支持in-place计算,输出会覆盖输入,以节省内存空间。
Sigmoid
- 类型(type):Sigmoid
- CPU 实现: ./src/caffe/layers/sigmoid_layer.cpp
CUDA、GPU实现: ./src/caffe/layers/sigmoid_layer.cu
例子(详见 ./examples/mnist/mnist_autoencoder.prototxt)
layer {

  name: "encode1neuron"

  bottom: "encode1"

  top: "encode1neuron"

  type: "Sigmoid"

}
对于每一个输入值x,Sigmoid layer的输出为sigmoid(x)。
Caffe : Layer Catalogue(1)的更多相关文章
- Caffe : Layer Catalogue(2)
TanH / Hyperbolic Tangent 类型(type):TanH CPU 实现: ./src/caffe/layers/tanh_layer.cpp CUDA.GPU实现: ./src/ ...
- 【caffe Layer】代码中文注释
src/caffe/proto/caffe.proto 中LayerParameter部分 // NOTE // Update the next available ID when you add a ...
- caffe 学习(3)——Layer Catalogue
layer是建模和计算的基本单元. caffe的目录包含各种state-of-the-art model的layers. 为了创建一个caffe model,我们需要定义模型架构在一个protocol ...
- caffe layer注册机制
Caffe内部维护一个注册表用于查找特定Layer对应的工厂函数(Layer Factory的设计用到了设计模式里的工厂模式).Layer_factory的主要作用是负责Layer的注册,已经注册完事 ...
- caffe layer层cpp、cu调试经验和相互关系
对于layer层的cpp文件,你可以用LOG和printf.cout进行调试,cu文件不能使用LOG,可以使用cout,printf. 对于softmaxloss的layer层,既有cpp文件又有cu ...
- Caffe(卷积神经网络框架)介绍
Caffe(卷积神经网络框架)Caffe,全称Convolution Architecture For Feature Extraction caffe是一个清晰,可读性高,快速的深度学习框架.作者是 ...
- caffe 教程
Caffe是一个清晰而高效的深度学习框架,本文详细介绍了caffe的优势.架构,网络定义.各层定义,Caffe的安装与配置,解读了Caffe实现的图像分类模型AlexNet,并演示了CIFAR-10在 ...
- 知乎:GAN 的发展对于研究通用人工智能有什么意义?
https://www.zhihu.com/question/57668112/answer/155367561 Lyken 愿以有涯随无涯 收录于 编辑推荐知乎圆桌 · 296 人赞同了该回答 资历 ...
- 在Caffe添加Python layer详细步骤
本文主要讨论的是在caffe中添加python layer的一般流程,自己设计的test_python_layer.py层只是起到演示作用,没有实际的功能. 1) Python layer 在caff ...
随机推荐
- 设定PCB电路板形状和物理边界
1 设定PCB电路板形状和物理边界 在Protel DXP的PCB板文件向导中,我们已经初步确定了电路板的形状和物理边界.但我们在绘制PCB板之前,也许还会对电路板的边界的细节加以调整.如果我们要对电 ...
- 我想要个pc和手机共有的客户端,就像百度云(iBarn网盘好用)
https://github.com/zhimengzhe/iBarn iBarn网盘是一个基于PHP开发的先进的云存储系统,提供文件的网络备份,同步和分享服务:支持断点续传,秒传等功能:可选择文件下 ...
- Linux企业级项目实践之网络爬虫(26)——线程池
一旦有一个抓取请求开始,就创建一个新的线程,由该线程执行任务,任务执行完毕之后,线程就退出.这就是"即时创建,即时销毁"的策略.尽管与创建进程相比,创建线程的时间已经大大的缩短,但 ...
- Codeforces Round #203 - D. Looking for Owls
D. Looking for Owls Emperor Palpatine loves owls very much. The emperor has some blueprints with the ...
- jetty插件配置
1.jetty maven 插件启动设置: Base directory:${project_loc} Goals:clean -Djetty.port=8080 jetty:run 2.jetty ...
- 常用cl命令参数解释
紧接前文,第一行cl命令如下: 1> cl /c /IC:\...\include /ZI /nologo- /W3 /WX- /sdl /Od /Oy- /D WIN32 /D _DEBUG ...
- IOS-UITableView开发常用各种方法总结
实现列表有两种方式 方式一 继承UIViewController,实现UITableViewDataSource和UITableViewDelegate协议.声明UITableView. UserIn ...
- 查询rman备份信息经常使用指令
查询rman备份信息经常使用指令 ----登陆到rman $rman target / ----以精简的格式查看备份信息 RMAN> list backup of database summar ...
- 《STL源代码剖析》---stl_alloc.h阅读笔记
这一节是讲空间的配置与释放,但不涉及对象的构造和析构,仅仅是解说对象构造前空前的申请以及对象析构后空间怎么释放. SGI版本号的STL对空间的的申请和释放做了例如以下考虑: 1.向堆申请空间 2.考虑 ...
- Myeclipse 中添加mysql的jdbc驱动
打开myeclipse后单击菜单栏中的myeclipse——>preferences 然后在Myeclipse Enterprise workbench下的Java Enterprise Pro ...