
hashMap的底层数据结构
本节用于记录Java HashMap底层数据结构、方法实现原理等,基于JDK 1.8。
# 底层数据结构
Java hashMap 是采用哈希表结构的(数组+链表 /jdk8后加入红黑树)实现,结合了数组和链表的优点,
1,数组优点:可以快速通过数组下标对数组元素操作,效率极高
2,链表优点:插入或删除元素不需要移动元素,只需要修改链表的引用,效率极高
hashMap图示如下:
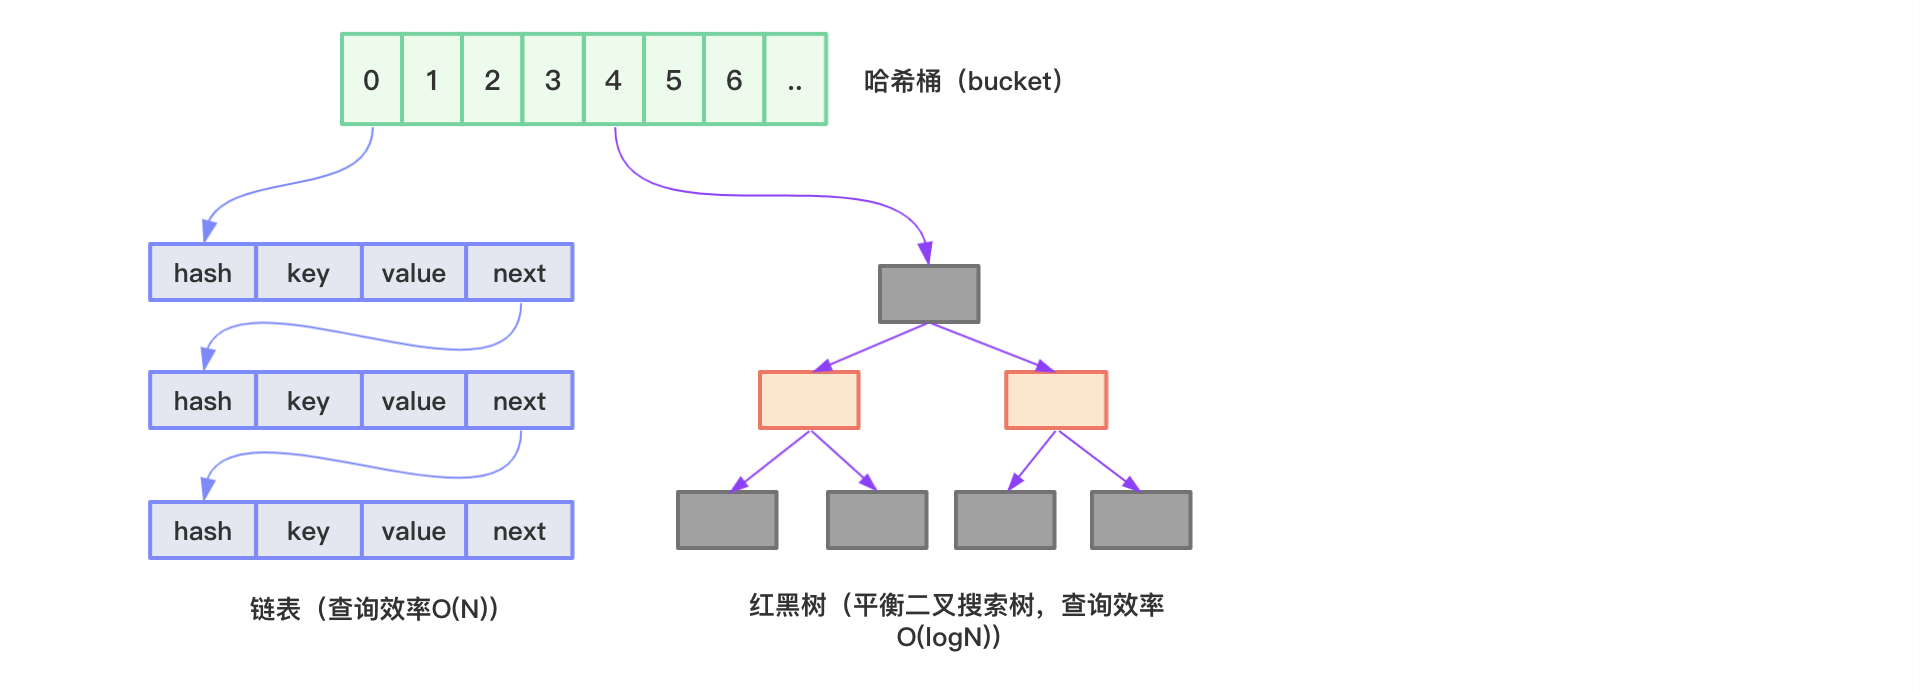
hashMap内部使用数组储存数据,每个元素都是一个Node<k,v>
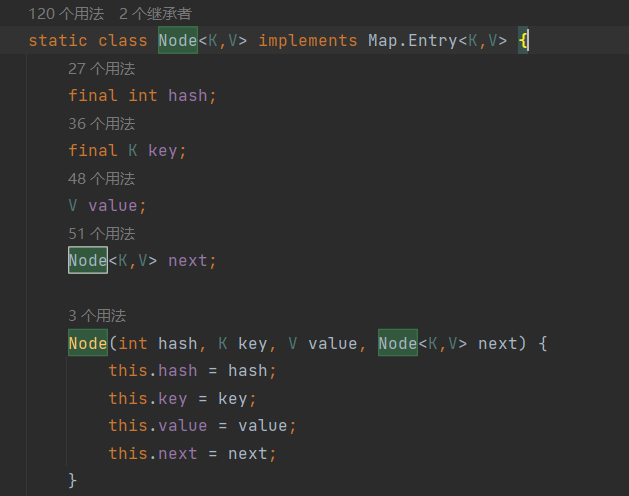
每个node 包含了hash,key,value,next 其中next表示下一个节点。
hashMap通过hash方法计算key的哈希码,然后通过公式计算key的下标。当数组中的下标存放一致时,数据将以链表的方式储存(hash冲突,hash碰撞)
我们知道,在链表中查找数据必须从第一个元素开始一层一层往下找,直到找到为止,时间复杂度为O(N),所以当链表长度越来越长时,HashMap的效率越来越低。
为了解决这个问题,JDK1.8开始采用数组+链表+红黑树的结构来实现HashMap。当链表中的元素超过8个(TREEIFY_THRESHOLD)并且数组长度大于64(MIN_TREEIFY_CAPACITY)时,会将链表转换为红黑树
HashMap包含几个重要的变量:
// 数组默认的初始化长度16

static final int DEFAULT_INITIAL_CAPACITY = 1 << 4;

// 数组最大容量,2的30次幂,即1073741824

static final int MAXIMUM_CAPACITY = 1 << 30;

// 默认加载因子值

static final float DEFAULT_LOAD_FACTOR = 0.75f;

// 链表转换为红黑树的长度阈值

static final int TREEIFY_THRESHOLD = 8;

// 红黑树转换为链表的长度阈值

static final int UNTREEIFY_THRESHOLD = 6;

// 链表转换为红黑树时,数组容量必须大于等于64

static final int MIN_TREEIFY_CAPACITY = 64;

// HashMap里键值对个数

transient int size;

// 扩容阈值,计算方法为 数组容量*加载因子

int threshold;

// HashMap使用数组存放数据,数组元素类型为Node<K,V>

transient Node<K,V>[] table;

// 加载因子

final float loadFactor;

// 用于快速失败,由于HashMap非线程安全,在对HashMap进行迭代时,如果期间其他线程的参与导致HashMap的结构发生变化了(比如put,remove等操作),直接抛出ConcurrentModificationException异常

transient int modCount;
hashMap的底层数据结构的更多相关文章
- 深入解析Java对象的hashCode和hashCode在HashMap的底层数据结构的应用
转自:http://kakajw.iteye.com/blog/935226 一.java对象的比较 等号(==): 对比对象实例的内存地址(也即对象实例的ID),来判断是否是同一对象实例:又可以说是 ...
- HashMap的底层实现原理
HashMap的底层实现原理1,属性static final int MAX_CAPACITY = 1 << 30;//1073741824(十进制)0100000000000000000 ...
- jdk1.8源码解析:HashMap底层数据结构之链表转红黑树的具体时机
本文从三个部分去探究HashMap的链表转红黑树的具体时机: 一.从HashMap中有关“链表转红黑树”阈值的声明: 二.[重点]解析HashMap.put(K key, V value)的源码: 三 ...
- HashMap底层数据结构详解
一.HashMap底层数据结构 JDK1.7及之前:数组+链表 JDK1.8:数组+链表+红黑树 关于HashMap基本的大家都知道,但是为什么数组的长度必须是2的指数次幂,为什么HashMap的加载 ...
- [转]java 的HashMap底层数据结构
java 的HashMap底层数据结构 HashMap也是我们使用非常多的Collection,它是基于哈希表的 Map 接口的实现,以key-value的形式存在.在HashMap中,key-v ...
- java 的HashMap底层数据结构
HashMap也是我们使用非常多的Collection,它是基于哈希表的 Map 接口的实现,以key-value的形式存在.在HashMap中,key-value总是会当做一个整体来处理,系统会根据 ...
- Redis(二)--- Redis的底层数据结构
1.Redis的数据结构 Redis 的底层数据结构包含简单的动态字符串(SDS).链表.字典.压缩列表.整数集合等等:五大数据类型(数据对象)都是由一种或几种数结构构成. 在命令行中可以使用 OBJ ...
- 深入理解Mysql索引底层数据结构与算法
索引是帮助MySQL高效获取数据的排好序的数据结构 索引数据结构对比 二叉树 左边子节点的数据小于父节点数据,右边子节点的数据大于父节点数据. 如果col2是索引,查找索引为89的行元素,那么只需要查 ...
- HashMap的底层原理(jdk1.7.0_79)
前言 在Java中我们最常用的集合类毫无疑问就是Map,其中HashMap作为Map最重要的实现类在我们代码中出现的评率也是很高的. 我们对HashMap最常用的操作就是put和get了,那么你知道它 ...
- HashMap的底层结构和原理
http://youzhixueyuan.com/the-underlying-structure-and-principle-of-hashmap.html HashMap是Java程序员使用频率最 ...
随机推荐
- LeetCode HOT 100:搜索旋转排序数组
题目:33. 搜索旋转排序数组 题目描述: 一个整数数组,数组每个值都不相同,且该整数数组是一个被旋转过的数组.被旋转过的数组是指,由一个递增的数组,从某一个下标开始往后的元素,移到最开头.举个例子: ...
- Clickhouse表引擎探究-ReplacingMergeTree
作者:耿宏宇 1 表引擎简述 1.1 官方描述 MergeTree 系列的引擎被设计用于插入极大量的数据到一张表当中.数据可以以数据片段的形式一个接着一个的快速写入,数据片段在后台按照一定的规则进行合 ...
- Linux基础守护进程、高级IO、进程间通信
守护进程(Daemon) 前言 Linux常用于服务器,程序通常不运行在前台.运行于前台的进程和终端关联,一旦终端关闭,进程也随之退出.因为守护进程不和终端关联,因此它的标准输出和标准输入也无法工作, ...
- CTFshow——funnyrsa1的wp理解
题目如下: 题目分析: 拿到题,发现给的e不常规,p1和p2相等,有两个不同n,两个不同c和两个不同e.给定两个密文的情况下,通常需要找到两者之间存在的关系,"合并"密文求解才能得 ...
- DFS深度优先搜索例题分析
洛谷P1596 Lake Counting S 题面翻译 由于近期的降雨,雨水汇集在农民约翰的田地不同的地方.我们用一个 \(N\times M(1\times N\times 100, 1\leq ...
- 3、mysql着重号解决关键字冲突
1.着重号(` `): 使用着重号(` `)将字段名或表名括起来解决冲突:保证表中的字段.表名等没有和保留字.数据库系统名或常用方法名冲突
- 模仿 vscode-server 把本地代码目录映射到外网
目录 概述 分析 解决方案 准备一台VM 创建容器 SmartIDE 创建 直接使用 docker 创建 SSH 远程转发 内网穿透 ngrok frp 服务端 客户端 本文模仿 vscode-ser ...
- C/C++语言 MD5例子
之前研究了一下在C中进行MD5加密,由于找了很久没有找到现成的库文件,所以所幸自己去写了一下.个人感觉C的便捷性没有Python好的原因就是这里. 下面是我写的一个例子. mian.cpp: 点击查看 ...
- [机器学习] Yellowbrick使用笔记2-模型选择
在本教程中,我们将查看各种Scikit Learn模型的分数,并使用Yellowbrick的可视化诊断工具对它们进行比较,以便为我们的数据选择最佳的模型. 代码下载 文章目录 1 使用说明 1.1 模 ...
- 1.【窗口组件】小部件-QWidgt
一.前言 QWidget翻译过来是小部件的意思,QWidgt 类是所有用户界面对象的基类. 窗口部件是用户界面的一个基本单元:它从窗 口系统接收鼠标.键盘和其它事件,并且在屏幕上绘制自己.每一个窗口部 ...