
【Semantic Segmentation】 Instance-sensitive Fully Convolutional Networks论文解析(转)
这篇文章比较简单,但还是不想写overview,转自: https://blog.csdn.net/zimenglan_sysu/article/details/52451098
另外,读这篇paper的时候,一直想不明白白一个问题,就是他分出了\(k^2\)个Instance-sensitive score maps,他是怎么训练的。。换句话说,ground truth是怎么弄的? 文章里只说了用logistics做损失函数,应该需要看代码,因为还没有搞分割的打算,先不详细了解代码。
Instance-sensitive Fully Convolutional Networks - eccv 2016
=====
论文地址:http://arxiv.org/abs/1603.08678
=====
一句话概括:
根据local coherence的特性,以sliding window的方式,利用FCN产生positive-sensitive的instance-level的segment proposal。
=====
framework
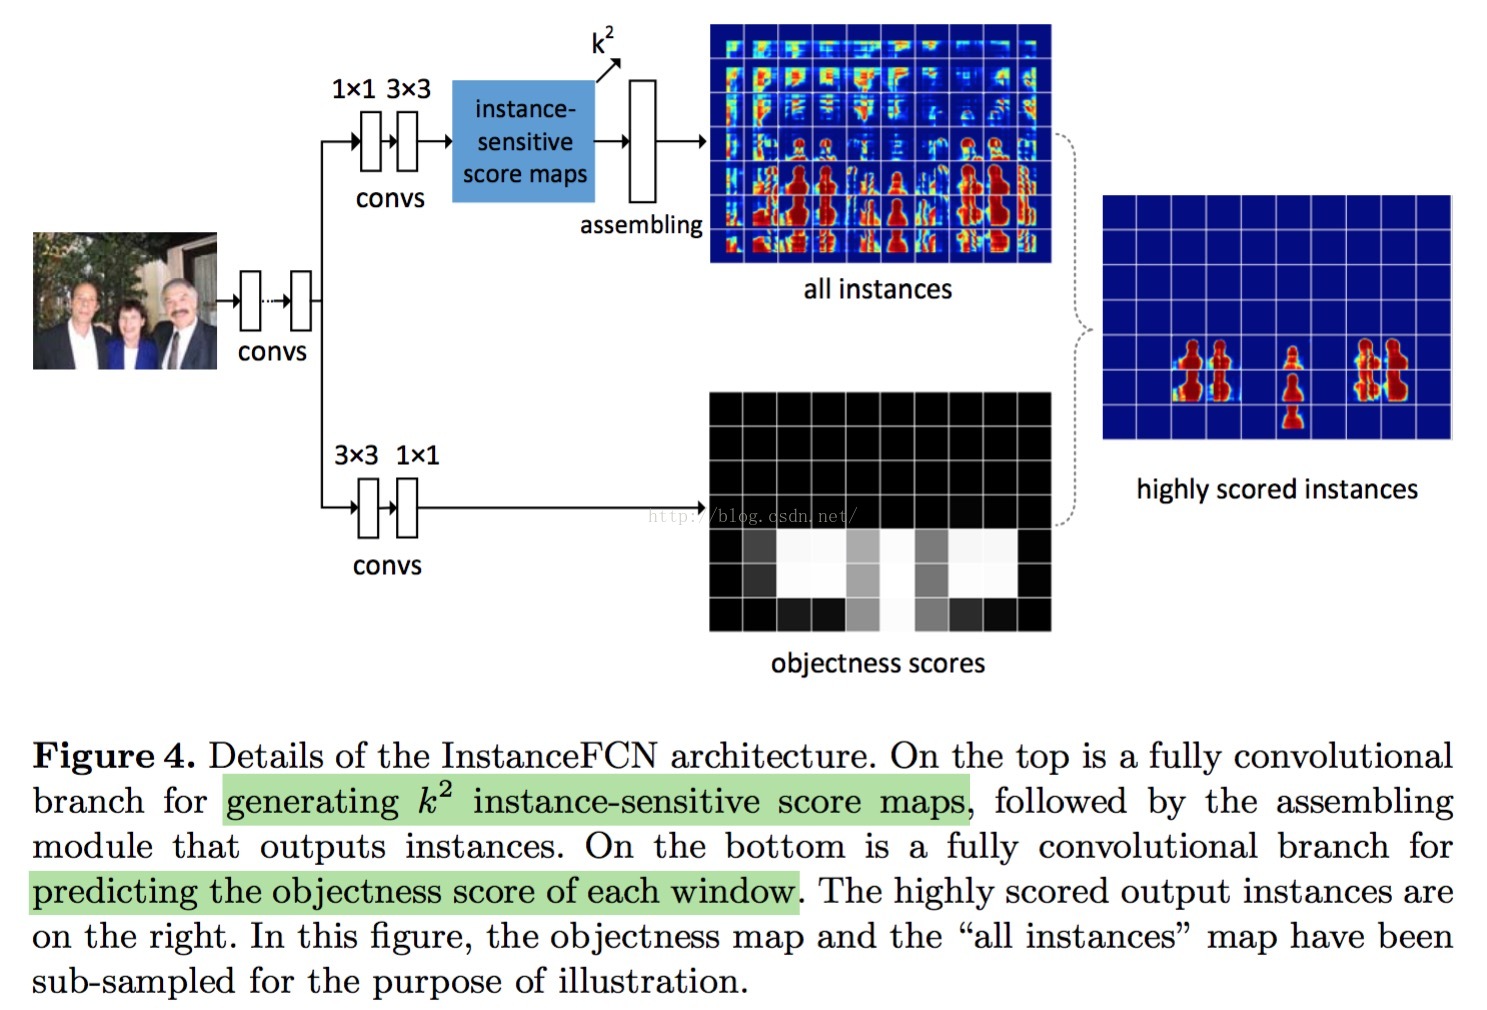
从上图可以看出,该network是一个full convolutional network(based on VGG16),除了feature extractor(VGG16的前13个conv layers)外,还有两个branches:
1 segment branch
该branch由1*1 conv,3*3 conv和一个assembling layer构成,后接segment的loss layer(采用logistic regression layer)
2 scoring branch
该branch由3*3 conv,1*1 conv构成,后接一个scoring的loss layer(采用logistic regression layer)
显然segment branch产生instance-level的segmentation mask,scoring branch对segment branch产生的instance mask进行打分。
(这里为objectness score,有点不明白为什么不是class-specific的)。
剩下的network architecture(VGG16-base)见下图:
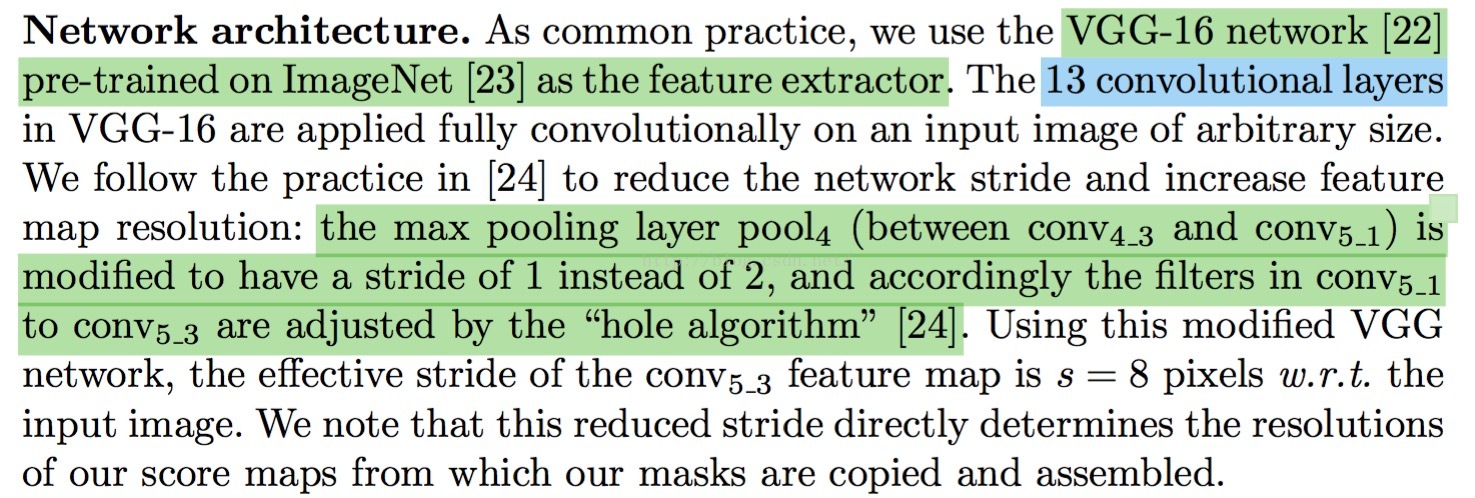
论文采用了hole algorithm来获取dense的feature map同时保持和原来VGG16的感受野大小。
=====
key module - assembling module
论文中的network(如上所述)是比较容易理解的,除了segment branch的assembling module。
先上图来个感性认识
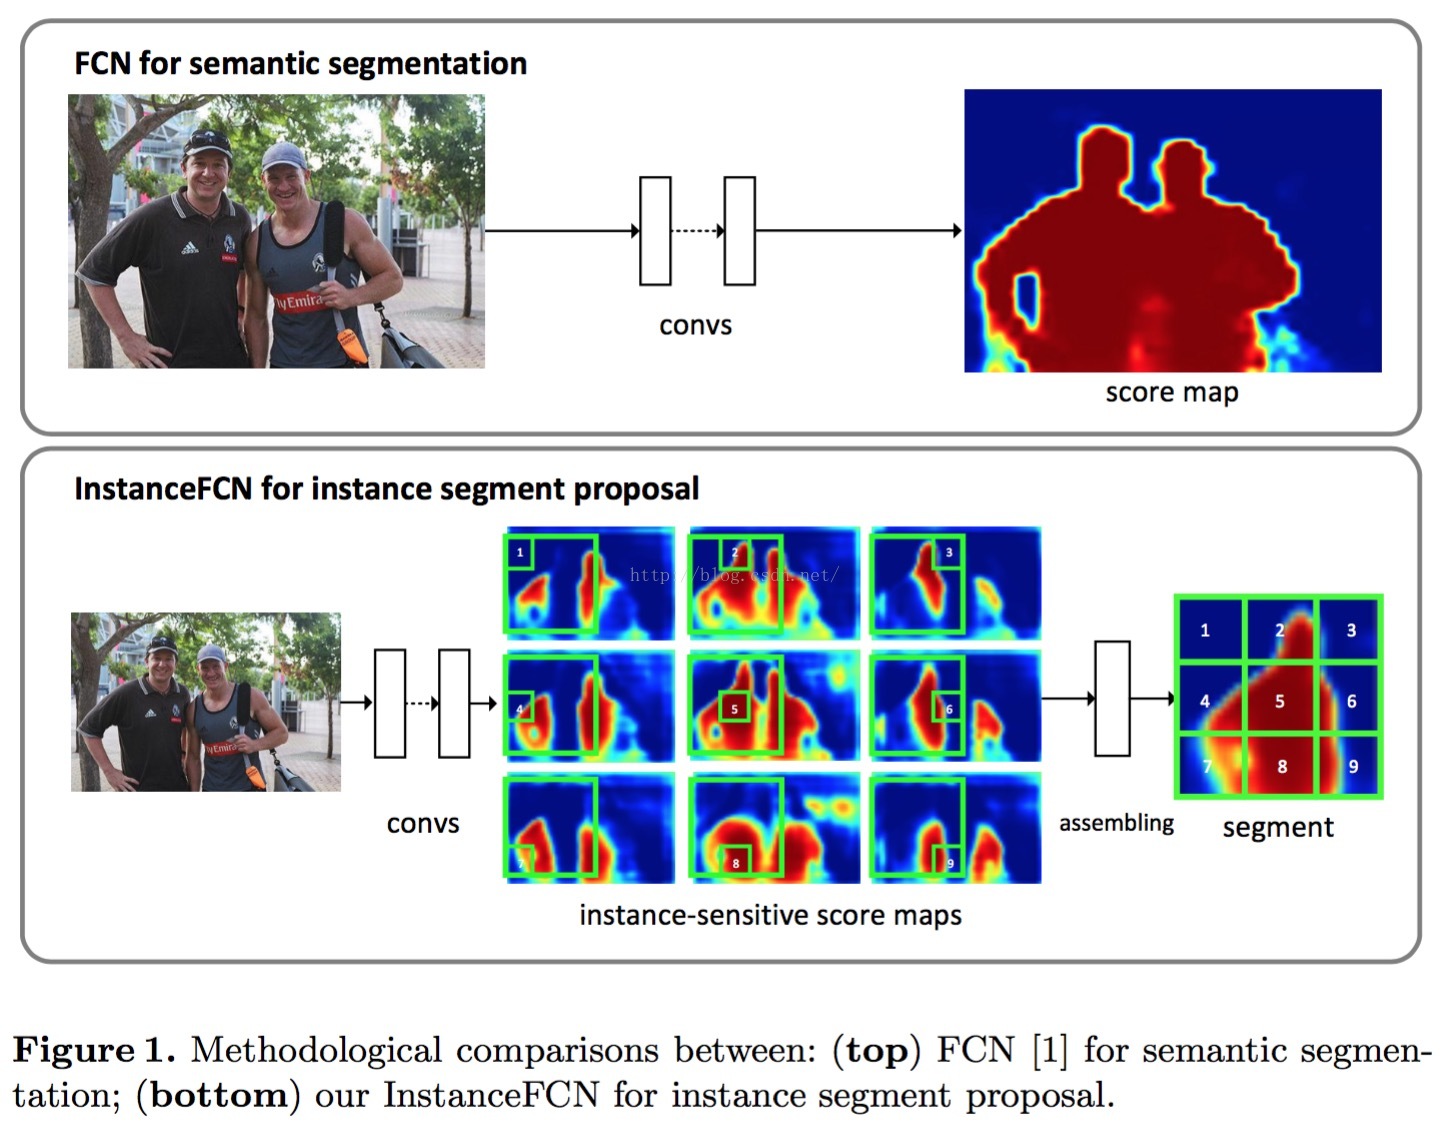
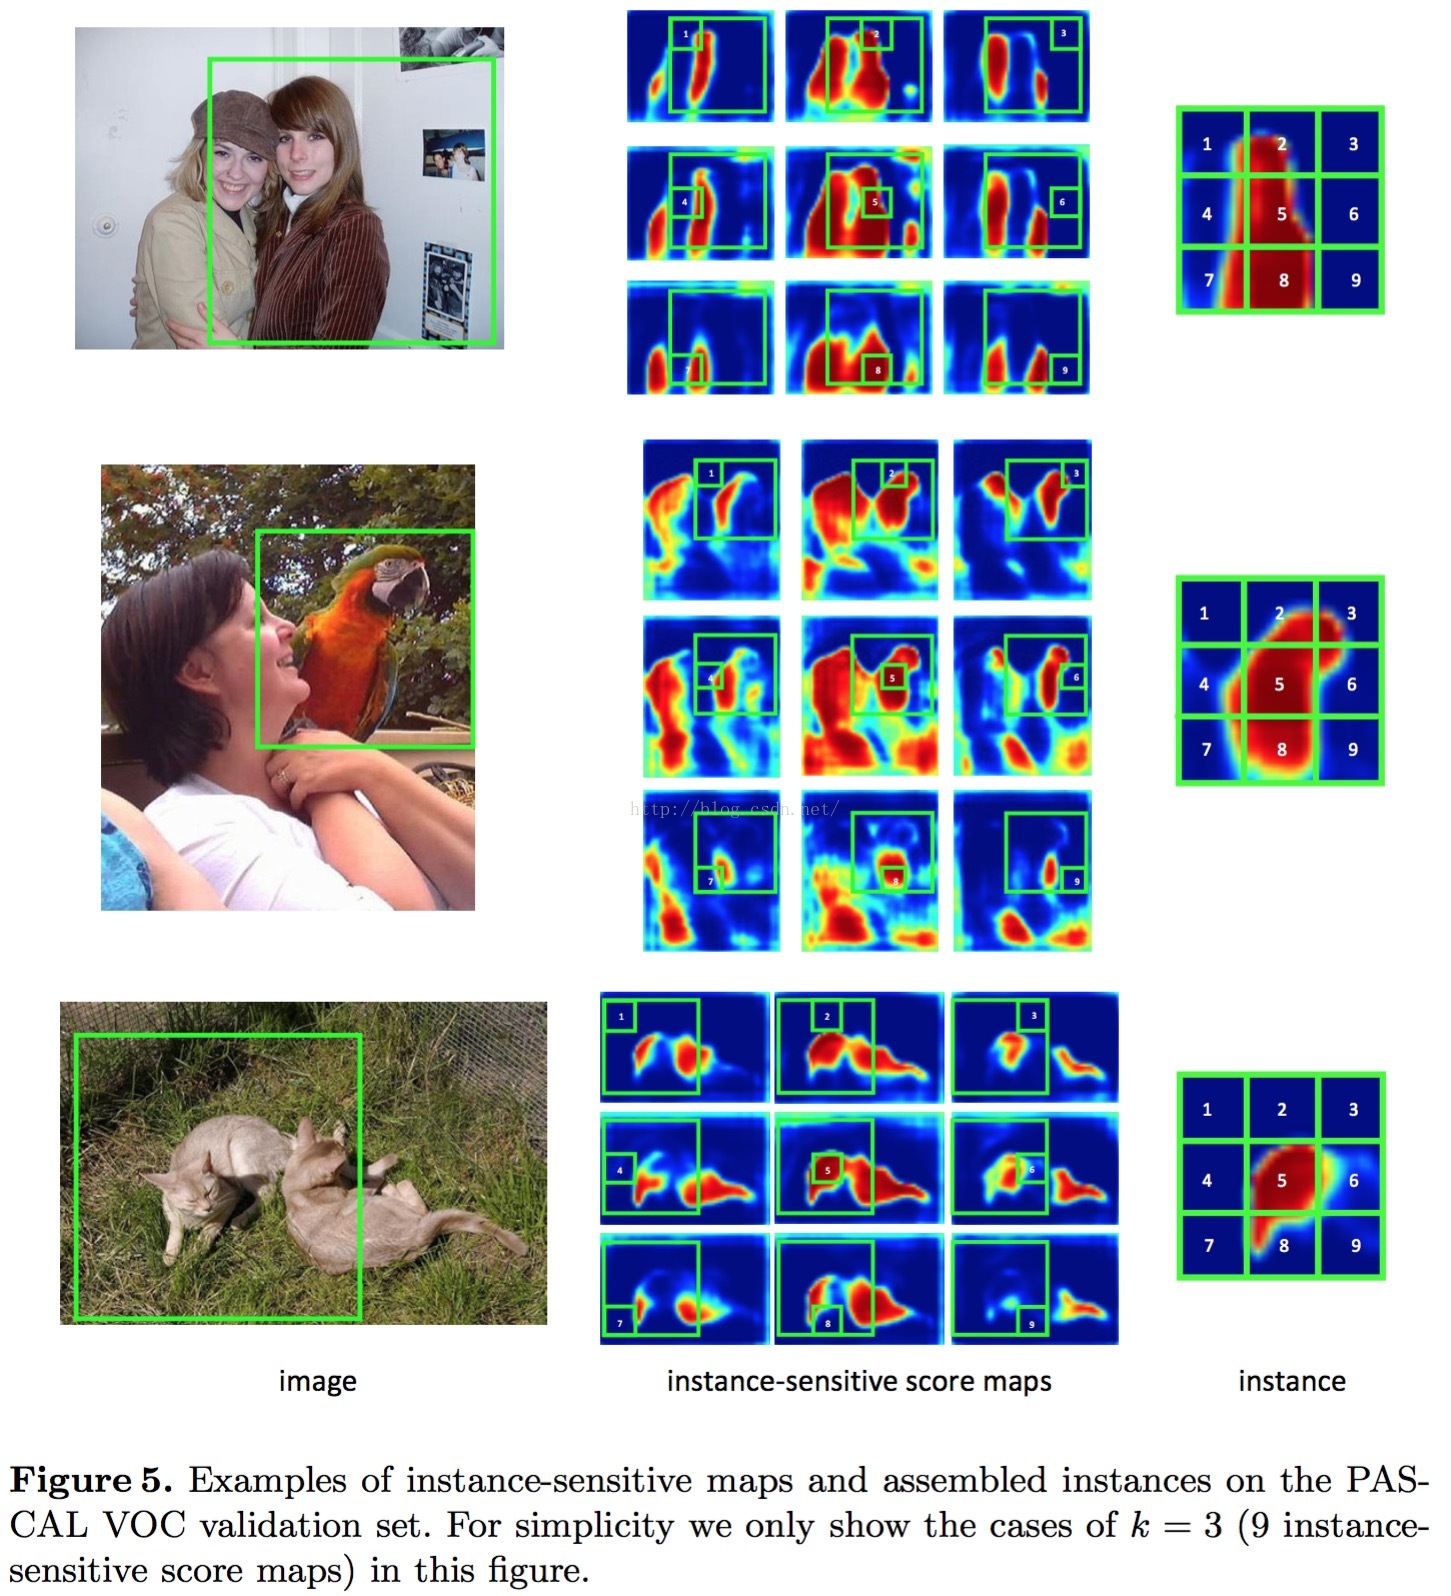
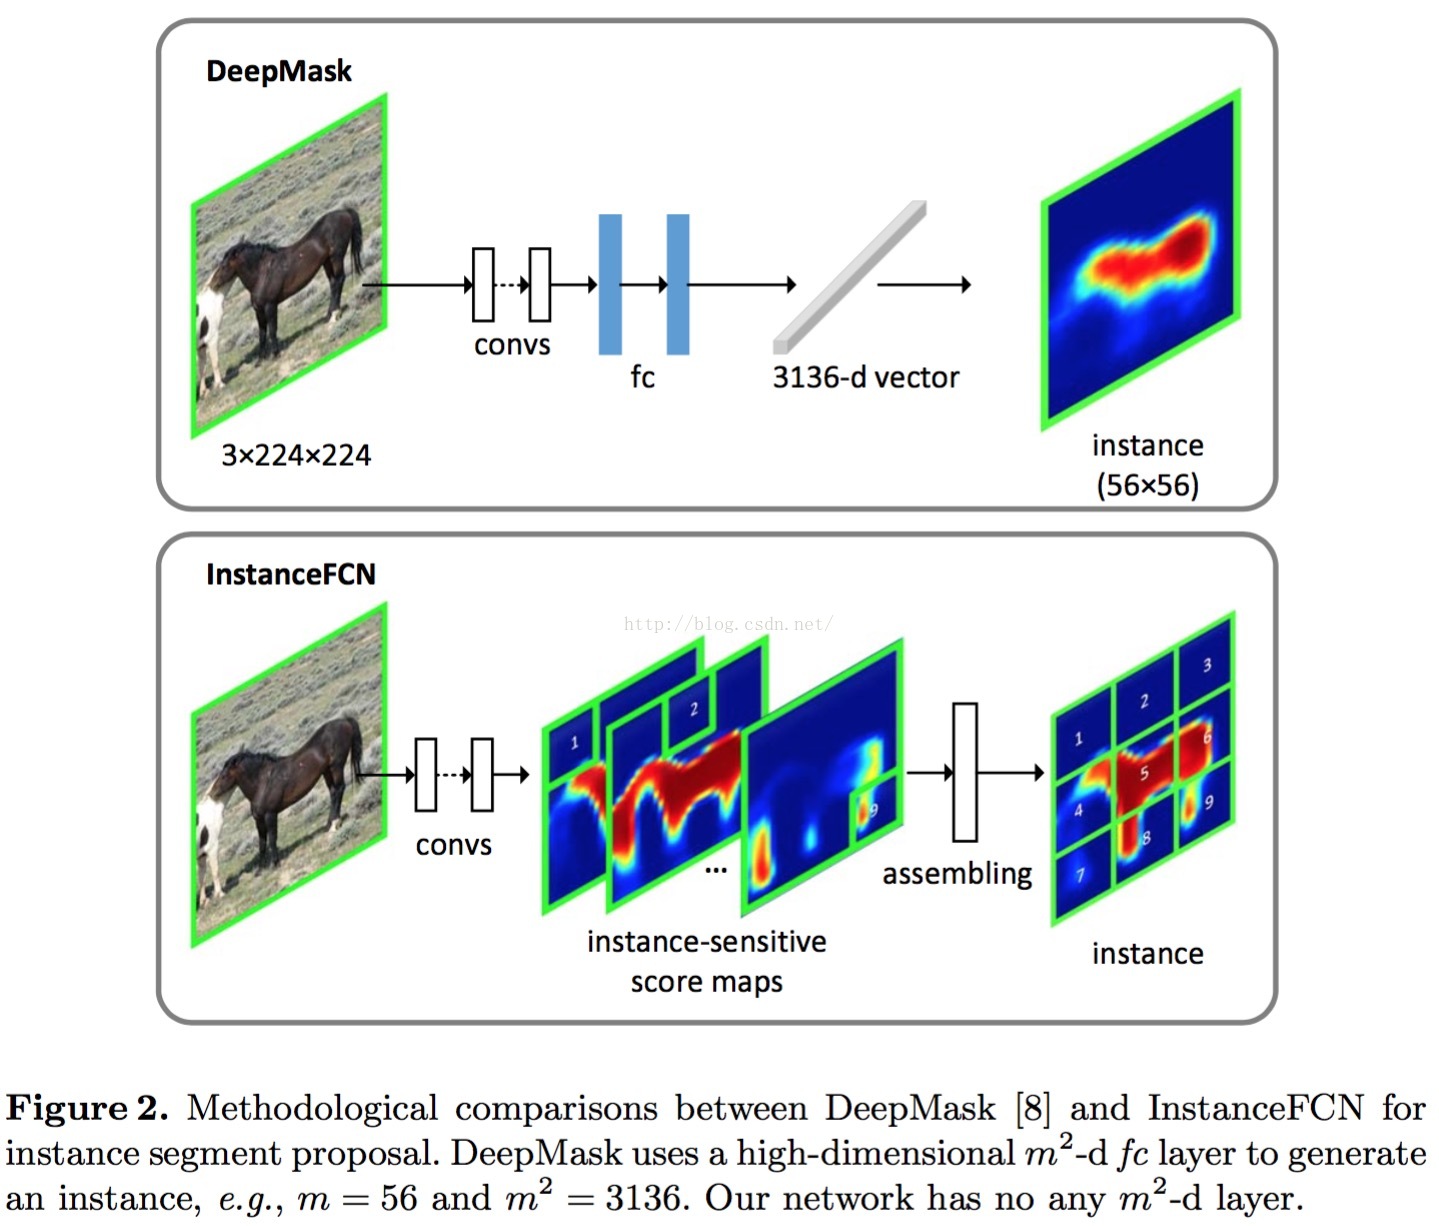
从上述三张图可以看出assembling module是如何工作的了,具体来说:
1 理解k^2 feature maps
由segment branch产生k^2个feature maps(或者理解为predicted masks),
这k^2 feature map编码了不同的位置信息,如top-left,top-center,……,bottom-right。
也就是每个feature map对应一个位置。
2 assembling -> producing instance-level mask
假如给定一个bounding box M(m*m大小),那么就可以将bounding box投影到k^2个feature map。
(类似RoIPooling)
将bounding box划分为k*k个bin,每个bin的大小为(m/k,m/k),
同理,bounding box投影到的feature map上的投影bounding boxes的
每个bounding box N_i (i=1,2, ...., k^2)也划分为k*k个bins。
这样M的每个bin K对应到第K个feature map上的N_k的bin K(刚好都是k^2)
那么对应的instance-level mask的输出为:同样为m*m大小,同样划分为k*k个bins
将第K个feature map上的N_k的bin K的feature values,拷贝到输出对应的bin K上。
(反向传播时,就是将对应的diff反过来拷贝过来就好)
说的有点绕口,但是它就是这么简单。
这里的输入bounding box并不是由proposal method产生的,而是论文作者以sliding window的方式
和指定bounding box的大小来产生的:
1 假设k^2的feature maps的大小为h和w,(同样对应的scoring branch的score map的大小也是h和w)
2 feature map上的每个pixel都产生一个bounding box,其大小为m*m,(论文里m=21)
3 每个pixel根据该bounding box
(已经是投影再feature map上的bounding box了,这个需要注意,而不是再从原图投影到feature map上),
输入其的instance-level的mask
4 这里的每个instance-level mask(一共w*h个)都由一个对应的objectness score,由scoring branch的score map给出
需要注意的是这里的w和h由个隐性的约束条件:h>=m, w>=m
=====
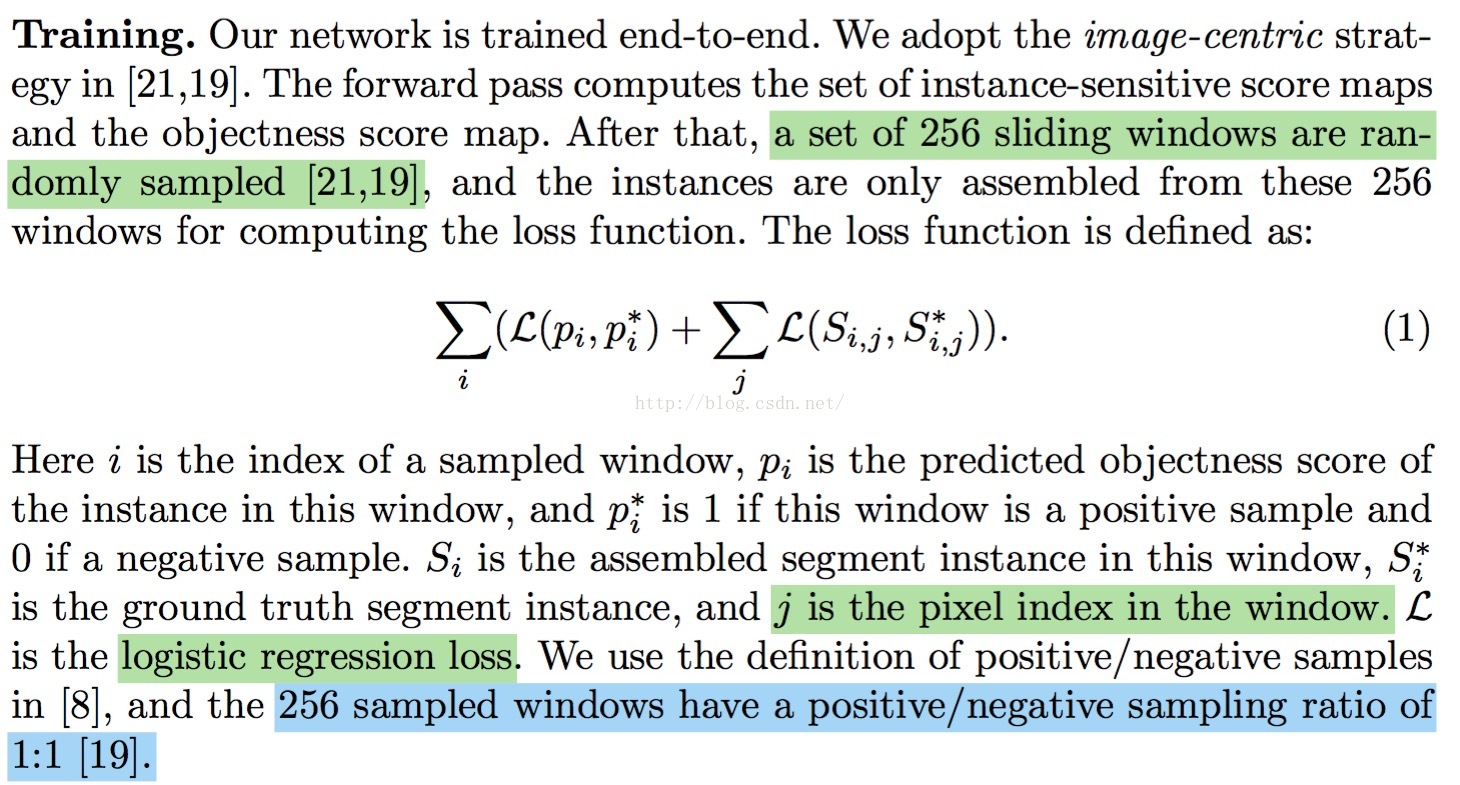
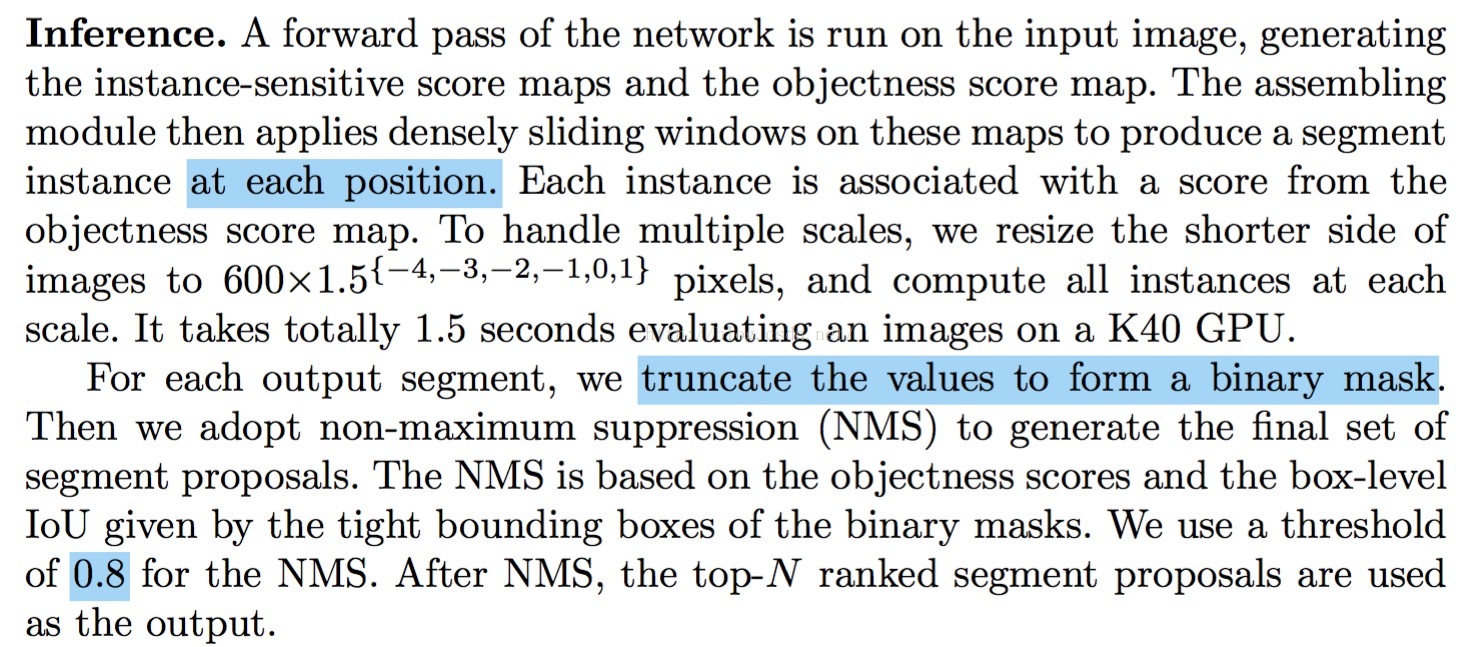
training & testing
那么论文是怎么training和testing的?还是直接看图(笔者直接截出来的)
=====
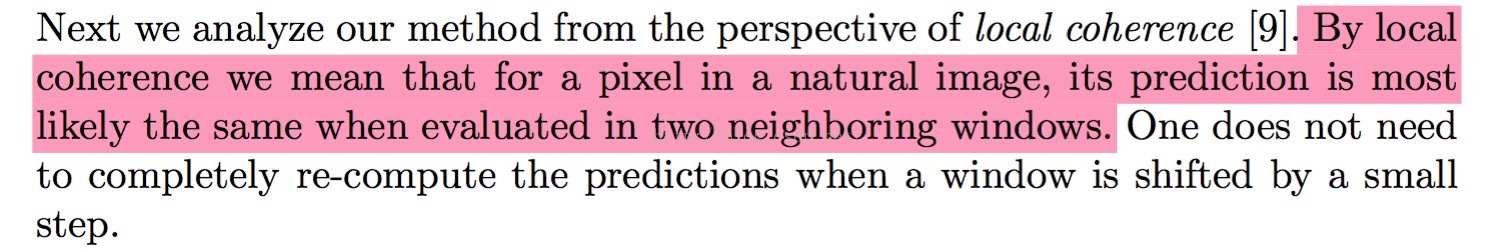
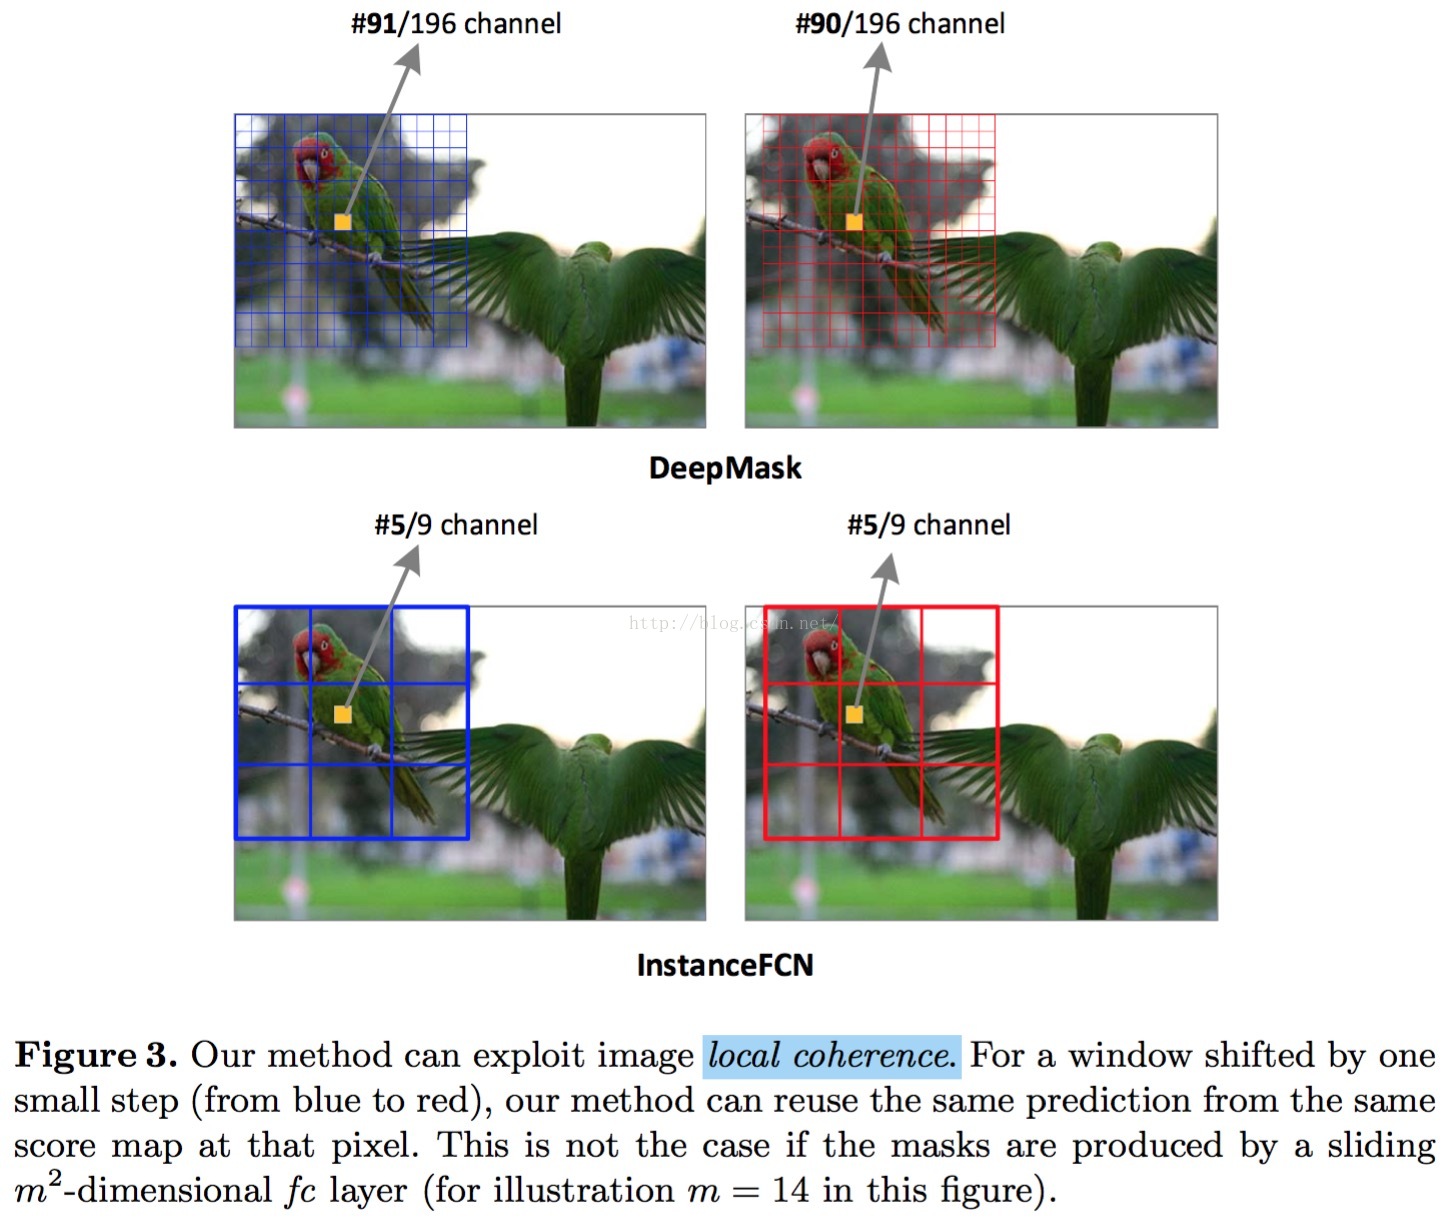
local coherence
嗯,直接看图,不说话
=====
与deepmask的对比
这个嘛,上面的local coherence已经说的很明白了,具体的请各位客官各自看论文和deepmask的论文
=====
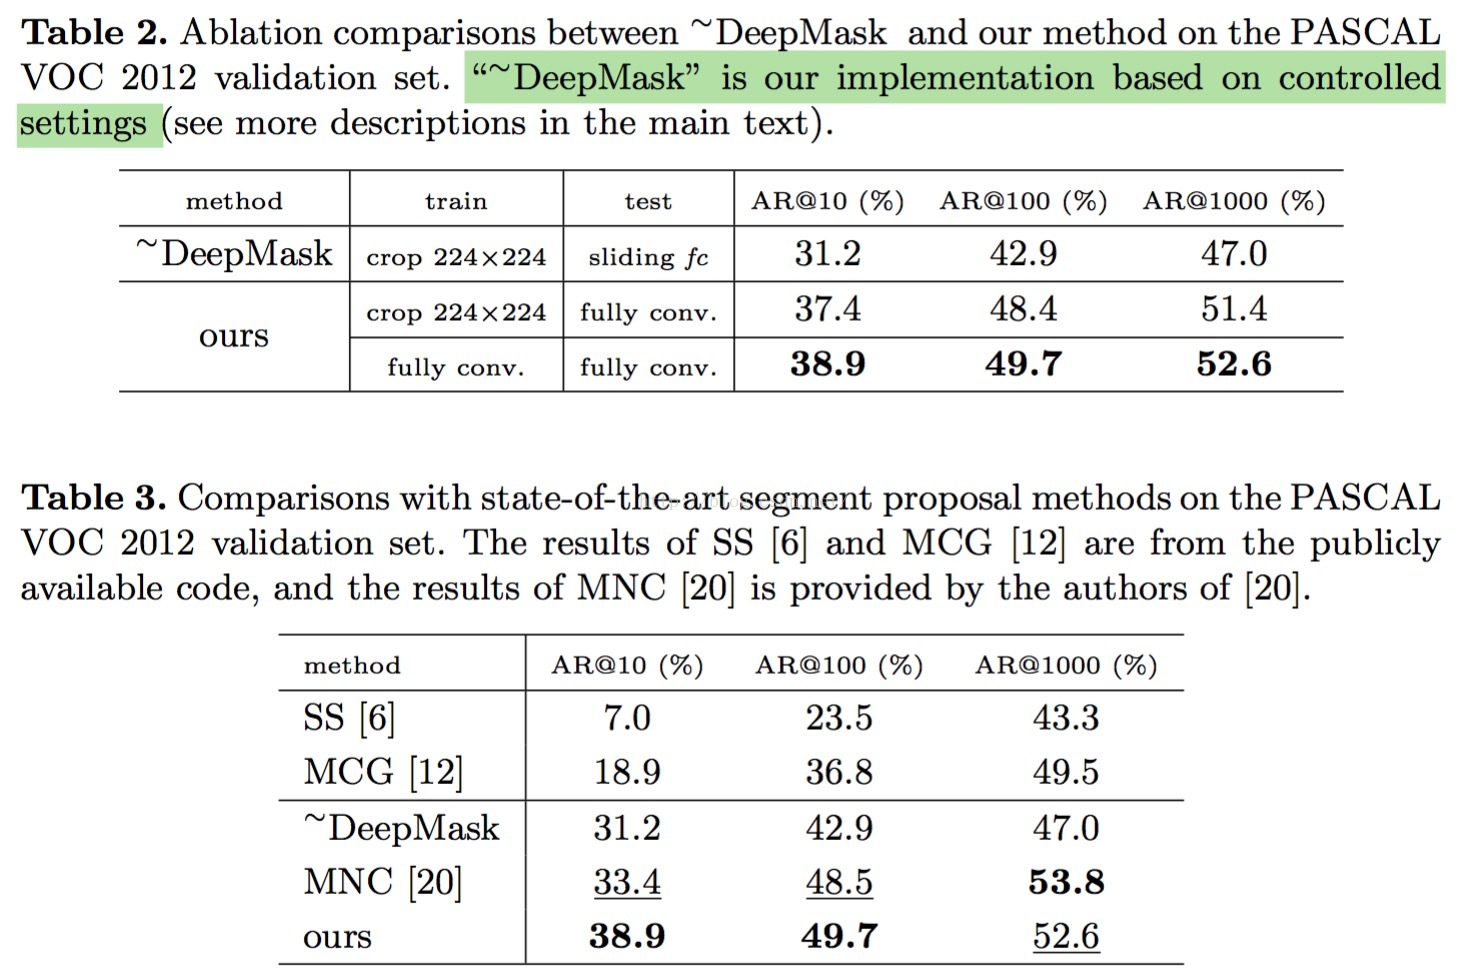
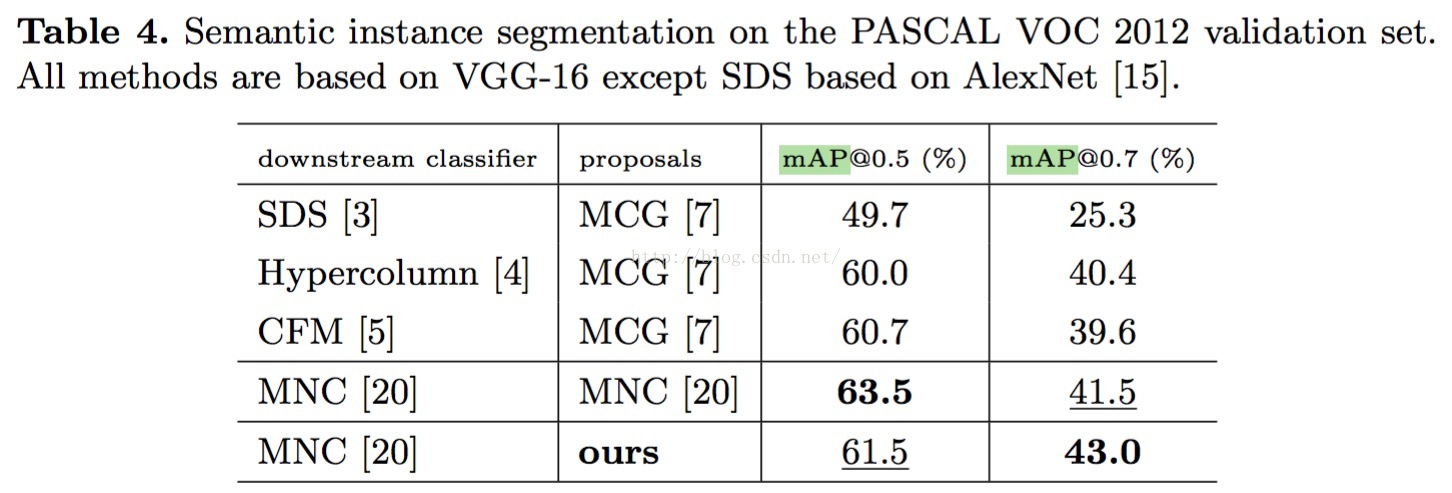
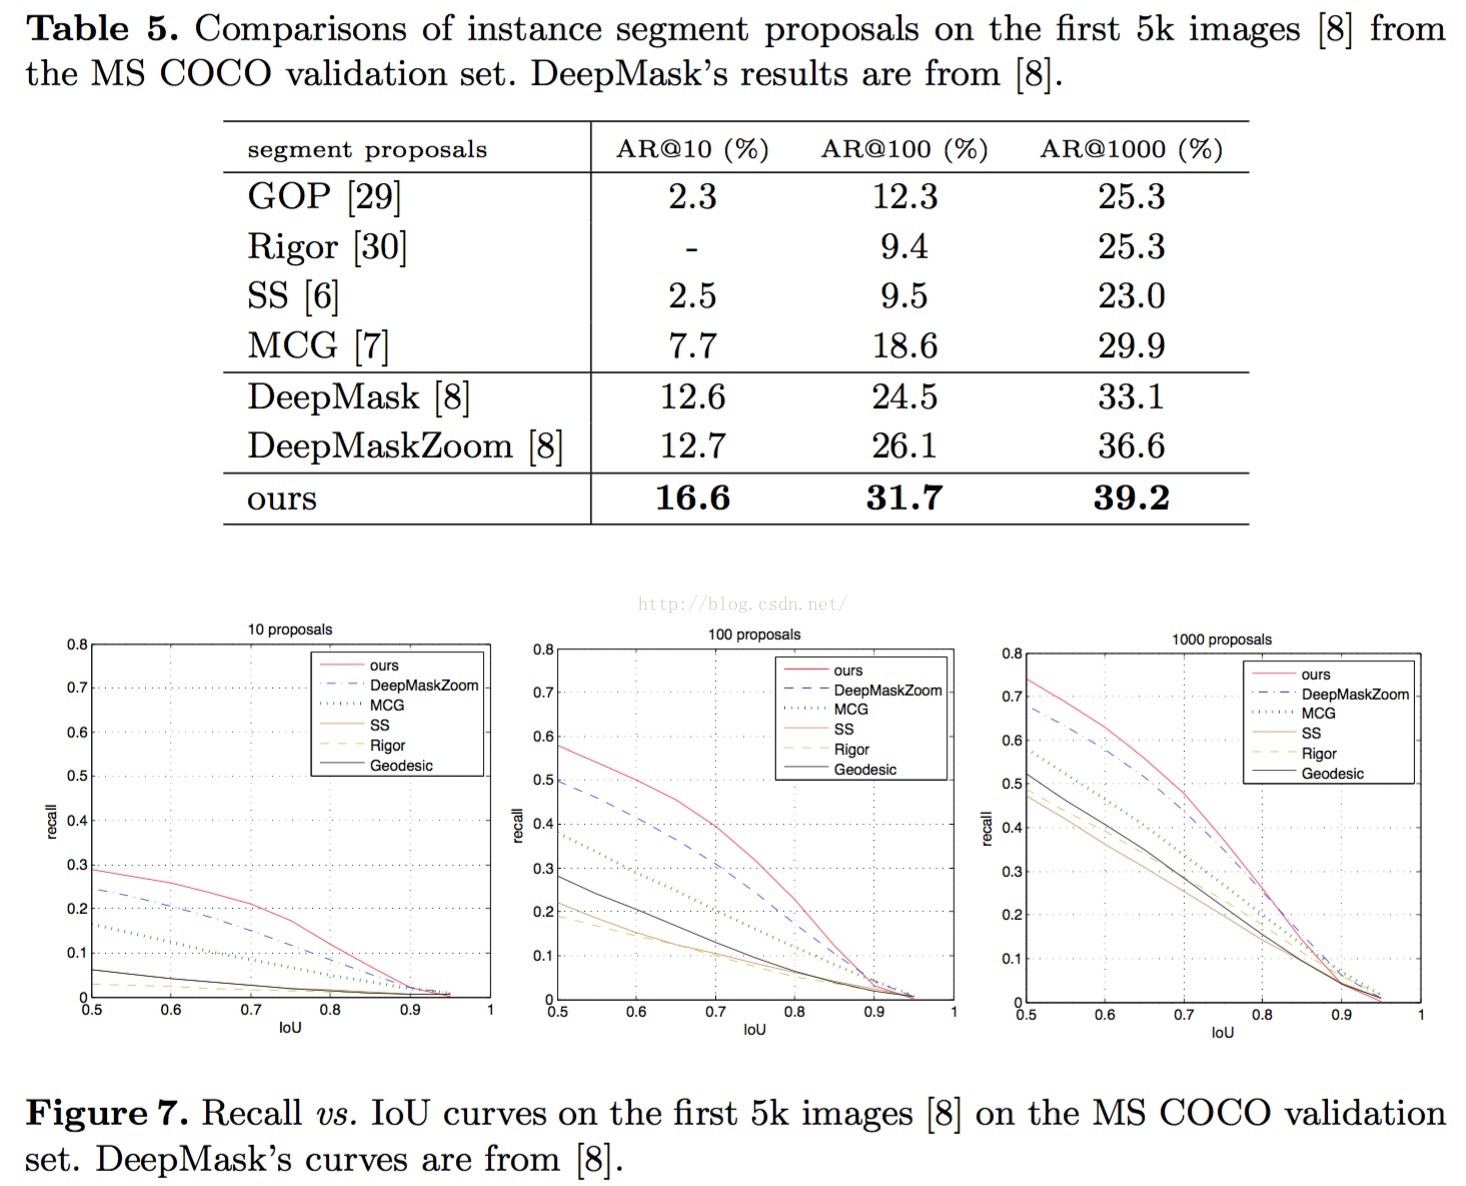
实验效果
嗯,直接看图,不说话
=====
总的来说,
整篇论文的思路很简单,但是效果就是好,复现也容易(但是,笔者还是坐等论文作者开源)
但是笔者有几处不是很明了,不知道哪位客官可以解答下:
1 branches的conv layer设计,为什么segment branch的为1*1,3*3,而scoring branch为3*3,1*1,为什么这样设计?
2 scoring branch的score为什么不是class-specific的而是objectness?
3 为什么不用proposal method的方式来产生bounding boxes?
4 训练segment branch时,是如何为每个predicted instance-level的mask分配对应的ground-truth?
5 为什么不用在论文作者的另外一篇论文上:Instance-aware Semantic Segmentation via Multi-task Network Cascades
笔者在此多谢喇!
欢迎前来探讨!

=====
如果这篇博文对你有帮助,可否赏笔者喝杯奶茶?
【Semantic Segmentation】 Instance-sensitive Fully Convolutional Networks论文解析(转)的更多相关文章
- 【Detection】R-FCN: Object Detection via Region-based Fully Convolutional Networks论文分析
目录 0. Paper link 1. Overview 2. position-sensitive score maps 2.1 Background 2.2 position-sensitive ...
- 【Network Architecture】Densely Connected Convolutional Networks 论文解析
目录 0. Paper link 1. Overview 2. DenseNet Architecture 2.1 Analogy to ResNet 2.2 Composite function 2 ...
- 论文学习:Fully Convolutional Networks for Semantic Segmentation
发表于2015年这篇<Fully Convolutional Networks for Semantic Segmentation>在图像语义分割领域举足轻重. 1 CNN 与 FCN 通 ...
- Fully Convolutional Networks for Semantic Segmentation 译文
Fully Convolutional Networks for Semantic Segmentation 译文 Abstract Convolutional networks are powe ...
- 论文笔记之:Visual Tracking with Fully Convolutional Networks
论文笔记之:Visual Tracking with Fully Convolutional Networks ICCV 2015 CUHK 本文利用 FCN 来做跟踪问题,但开篇就提到并非将其看做 ...
- 论文阅读(Xiang Bai——【CVPR2016】Multi-Oriented Text Detection with Fully Convolutional Networks)
Xiang Bai--[CVPR2016]Multi-Oriented Text Detection with Fully Convolutional Networks 目录 作者和相关链接 方法概括 ...
- 中文版 R-FCN: Object Detection via Region-based Fully Convolutional Networks
R-FCN: Object Detection via Region-based Fully Convolutional Networks 摘要 我们提出了基于区域的全卷积网络,以实现准确和高效的目标 ...
- 『计算机视觉』R-FCN:Object Detection via Region-based Fully Convolutional Networks
一.网络介绍 参考文章:R-FCN详解 论文地址:Object Detection via Region-based Fully Convolutional Networks R-FCN是Faster ...
- 全卷积网络Fully Convolutional Networks (FCN)实战
全卷积网络Fully Convolutional Networks (FCN)实战 使用图像中的每个像素进行类别预测的语义分割.全卷积网络(FCN)使用卷积神经网络将图像像素转换为像素类别.与之前介绍 ...
随机推荐
- Spark源码分析 – Shuffle
参考详细探究Spark的shuffle实现, 写的很清楚, 当前设计的来龙去脉 Hadoop Hadoop的思路是, 在mapper端每次当memory buffer中的数据快满的时候, 先将memo ...
- js Ajax 跨域请求
一.使用jsonp的方式(只支持get请求) 二.使用cors的方式(支持HTTP的大部分请求方式) 三.apache的转发(修改服务器配置) 没有试验,暂时不详细写!
- Ubuntu 下 mysql 卸载后重安装时遇到的问题
卸载mysql报错解决方法1 dpkg: error processing mysql-server (--configure): dependency problems - leaving unco ...
- 如何在 windows 配置 libtorch c++ 前端库?
如何在 windows 配置 libtorch c++ 前端库? 下载 pytorch 已经编译好的库: 此库不带 gpu,主要方便演示.支持 win7 win10 系统. 下载地址:https:// ...
- git学习------>如何汉化GitLab?
在上一篇博客中,已经正常安装好了GitLab,然而全部界面都是纯英文的,为了照顾整个团队的英文水平,因此这篇博客的目的是将纯英文的GitLab进行汉化. 纯英文界面 第一步: 确认GitLab版本号 ...
- jquery prop attr
checked比较特殊,只要设置了属性checked,不管何值都是checked的.例如:<input type="checkbox" checked><inpu ...
- 使用selenium实现简单网络爬虫抓取MM图片
撸主听说有个网站叫他趣,里面有个社区,其中有一项叫他趣girl,撸主点进去看了下,还真不错啊,图文并茂,宅男们自己去看看就知道啦~ 接下来当然就是爬取这些妹子的图片啦,不仅仅是图片,撸主发现里面的对话 ...
- XSS注入学习
引贴: http://mp.weixin.qq.com/s?__biz=MzIyMDEzMTA2MQ==&mid=2651148212&idx=1&sn=cd4dfda0b92 ...
- JavaScript和jQuery的学习
还有12天就要回学校了,我的假期计划还能实现吗?在这12天里,需要把JavaScript和jQuery学完.我知道这两个技术对于前端网页开发非常重要.前期把HTML和CSS学完了,学的不是特别深,只是 ...
- 测试:safenet提供的CheckKey函数 内存泄漏。具体来说是句柄.
unsigned char vendor_code[] = "7XSQT4jxlSkDJhwqpxxfLwbuxgrYw93OMy+K5sc5pyfTa7HQo1ikLyg7FDuEpgUK ...