
Hadoop源码解析 1 --- Hadoop工程包架构解析
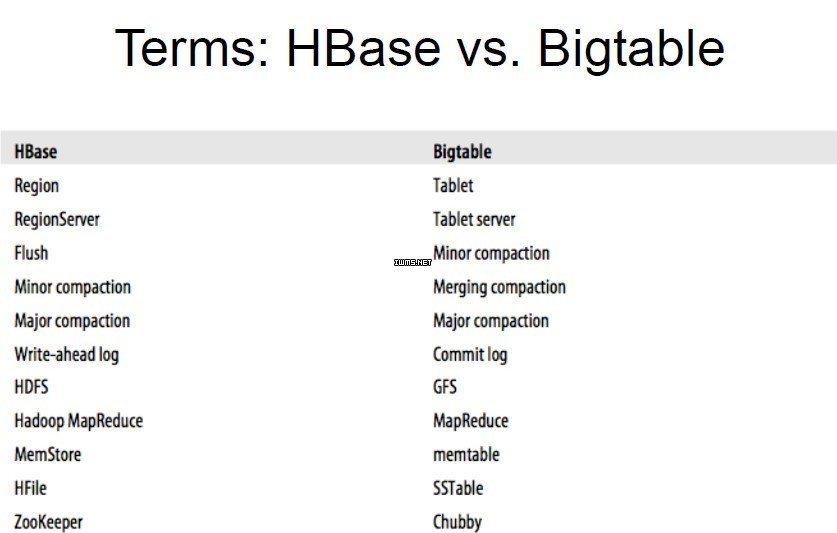
1 Hadoop中各工程包依赖简述 Google的核心竞争技术是它的计算平台。Google的大牛们用了下面5篇文章,介绍了它们的计算设施。 GoogleCluster: http://research.google.com/archive/googlecluster.html Chubby:http://labs.google.com/papers/chubby.html GFS:http://labs.google.com/papers/gfs.html BigTable:http://labs.google.com/papers/bigtable.html MapReduce:http://labs.google.com/papers/mapreduce.html 很快,Apache上就出现了一个类似的解决方案,目前它们都属于Apache的Hadoop项目,对应的分别是: Chubby-->ZooKeeper GFS-->HDFS BigTable-->HBase MapReduce-->Hadoop 目前,基于类似思想的Open Source项目还很多,如Facebook用于用户分析的Hive。 HDFS作为一个分布式文件系统,是所有这些项目的基础。分析好HDFS,有利于了解其他系统。由于Hadoop的HDFS和MapReduce是同一个项目,我们就把他们放在一块,进行分析。 Hadoop包之间的依赖关系比较复杂,原因是HDFS提供了一个分布式文件系统, 该系统提供API,可以屏蔽本地文件系统和分布式文件系统,甚至象Amazon S3这样的在线存储系统。这就造成了分布式文件系统的实现,或者是分布式 文件系统的底层的实现,依赖于某些貌似高层的功能。功能的相互引用,造成了蜘蛛网型的依赖关系。一个典型的例子就是包conf,conf用于读取系统配 置,它依赖于fs,主要是读取配置文件的时候,需要使用文件系统,而部分的文件系统的功能,在包fs中被抽象了。
2 Hadoop和Google分布式系统对应产品
3 Hadoop工程中各工程包依赖图示
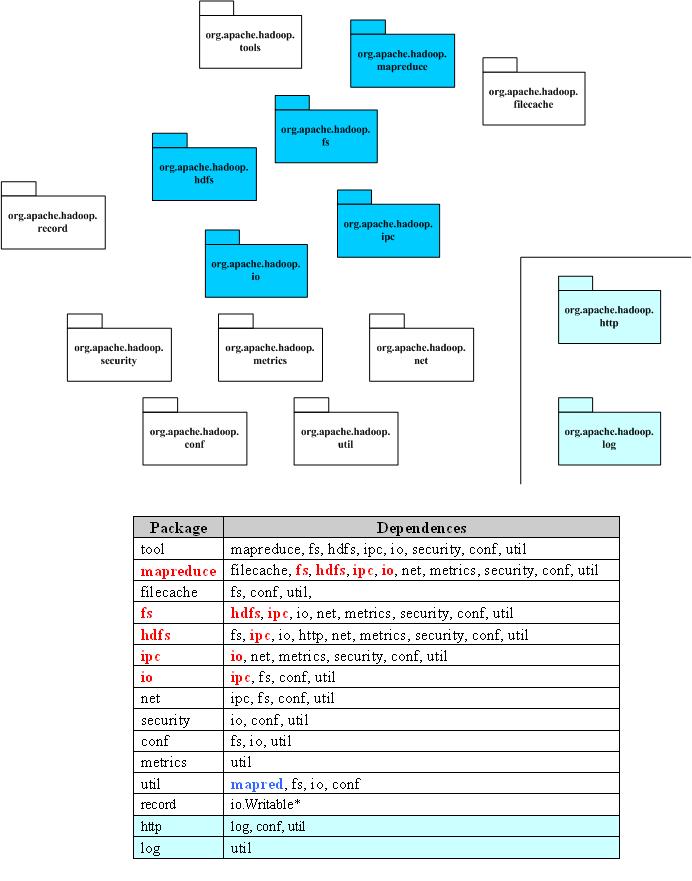
4 Hdoop工程中各工程包文件夹图示

5 各包功能
|
Package |
Dependences |
|
tool |
提供一些命令行工具,如DistCp,archive |
|
mapreduce |
Hadoop的Map/Reduce实现 |
|
filecache |
提供HDFS文件的本地缓存,用于加快Map/Reduce的数据访问速度 |
|
fs |
文件系统的抽象,可以理解为支持多种文件系统实现的统一文件访问接口 |
|
hdfs |
HDFS,Hadoop的分布式文件系统实现 |
|
ipc |
一个简单的IPC的实现,依赖于io提供的编解码功能 参考:http://zhangyu8374.iteye.com/blog/86306 |
|
io |
表示层。将各种数据编码/解码,方便于在网络上传输 |
|
net |
封装部分网络功能,如DNS,socket |
|
security |
用户和用户组信息 |
|
conf |
系统的配置参数 |
|
metrics |
系统统计数据的收集,属于网管范畴 |
|
util |
工具类 |
|
record |
根据DDL(数据描述语言)自动生成他们的编解码函数,目前可以提供C++和Java |
|
http |
基于Jetty的HTTP Servlet,用户通过浏览器可以观察文件系统的一些状态信息和日志 |
|
log |
提供HTTP访问日志的HTTP Servlet |
原创文章欢迎转载,转载时请注明出处。
作者推荐文章:
》如何获取系统信息(包括操作系统、jvm、cpu、内存、硬盘、网络等)
Hadoop源码解析 1 --- Hadoop工程包架构解析的更多相关文章
- Hadoop工程包架构解析
Hadoop源码解析 1 --- Hadoop工程包架构解析 1 Hadoop中各工程包依赖简述 Google的核心竞争技术是它的计算平台.Google的大牛们用了下面5篇文章,介绍了它们的计算 ...
- (转)把hadoop源码关联到eclipse工程
把hadoop源码关联到eclipse工程 转:http://www.superwu.cn/2013/08/04/355 在eclipse中阅读源码非常方便,利于我们平时的学习,下面讲述如何把 ...
- hadoop源码import到eclipse工程
1.解压hadoop-1.1.2.tar.gz,重点在src文件夹 2.在eclipse中通过菜单栏创建一个java工程,工程名随便 3.在创建的工程上,点击右键,在弹出菜单中选择最后一项,在弹出窗口 ...
- 使用其他Java工程导入hadoop源码用于在hadoop工程中查看源码
疑问:在开发hadoop程序的时候,有时候需要查看hadoop的源码,但是开发环境看不到,甚是烦恼,经过网上搜索和琢磨,终于实现了,虽然有点绕,但是目的达到了. 第一步:下载hadoop的源码包:ha ...
- hadoop源码分析(2):Map-Reduce的过程解析
一.客户端 Map-Reduce的过程首先是由客户端提交一个任务开始的. 提交任务主要是通过JobClient.runJob(JobConf)静态函数实现的: public static Runnin ...
- Hadoop源码分析(1):HDFS读写过程解析
一.文件的打开 1.1.客户端 HDFS打开一个文件,需要在客户端调用DistributedFileSystem.open(Path f, int bufferSize),其实现为: public F ...
- Hadoop源码分析:Hadoop编程思想
60页的ppt讲述Hadoop的编程思想 下载地址 http://download.csdn.net/detail/popsuper1982/9544904
- Hadoop源码分析(3): Hadoop的运行痕迹
在使用hadoop的时候,可能遇到各种各样的问题,然而由于hadoop的运行机制比较复杂,因而出现了问题的时候比较难于发现问题. 本文欲通过某种方式跟踪Hadoop的运行痕迹,方便出现问题的时候可以通 ...
- Hadoop源码编译过程
一. 为什么要编译Hadoop源码 Hadoop是使用Java语言开发的,但是有一些需求和操作并不适合使用java,所以就引入了本地库(Native Libraries)的概念,通 ...
随机推荐
- dubbox provider cosumer 包坐标及xml
provider pom <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http:// ...
- #leetcode刷题之路8-字符串转换整数 (atoi)
请你来实现一个 atoi 函数,使其能将字符串转换成整数.首先,该函数会根据需要丢弃无用的开头空格字符,直到寻找到第一个非空格的字符为止.当我们寻找到的第一个非空字符为正或者负号时,则将该符号与之后面 ...
- 19-3-5Python中列表、元组、以及range
一.列表: 为什么要学列表? 因为字符串存在缺点: 1) 只能存储少量的数据. 2) 数据类型无论索引.切片 获取的都是字符串类型,类型过于单一,转化成它原来的类型还需要进一步转换 ...
- jsp页面通过EL表达式获取list大小兼容性处理
1.jsp页面通过EL表达式获取list大小,中间件用tomcat7时,下面这个写法是可以的 <input id="test" type="hidden" ...
- 【mongdb主从复制和同步】
主从同步: Master: Slave: 副本集: #在卷本中加任意主机 #登录从 #登录主 #同步日志 #仲裁: 向集群中添加主机成为仲裁 #查看集群里的成员角色参数:
- “==”与equals的区别
“==”与equals的区别: “==”:两个对象比较的是对象的引用地址比较,对象的hashCode值是对象的引用地址,只有两个对象的hashCode值一样,此比较符才会返回true,否则即使两个对象 ...
- PHP 使用GD库合成带二维码的海报步骤以及源码实现
PHP 使用GD库合成带二维码的海报步骤以及源码实现 在做微信项目开发过程中,经常会遇到图片合成的问题,比如将用户的二维码合成到宣传海报中,那么,遇到这种情况,利用PHP的GD库也是很容易实现的,实现 ...
- 『Linux基础 - 5 』Linux常用命令(2)
这篇笔记的只要知识点: (1)ls查看文件信息,列表中每个字符所代表的含义 (2) 使用通配符匹配文件 (3) chmod命令:修改文件或目录权限 (4) 与用户相关命令(who.su.exit.pa ...
- ruby中的return方法及class实例方法的initialize方法
return是函数的返回值 class Mtring def initialize(str) @name = str end def aa ary = @name.split(/:/) return ...
- 用JavaScript动态实现单元格合并
不太想描述,大家自行理解吧,这样可能记忆会深一点儿- <script type="text/javascript"> function mergeCells(){ va ...