
retrival and clustering : week 3 k-means 笔记
华盛顿大学 machine learning 笔记。
K-means algorithm
算法步骤:
0. 初始化几个聚类中心 (cluster centers)μ1,μ2, … , μk

1. 将所有数据点分配给最近的聚类中心;
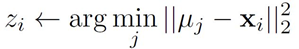
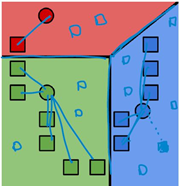
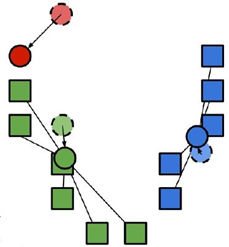
2. 将每个聚类中心的值改成分配到该点所有数据点的均值;
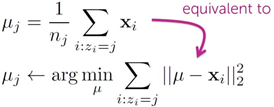
3. 重复1-2步骤,直到收敛到局部最优(local optimium).
#输入:

        #数据集 data

        #集群数 k

        #初始集群中心组 initial_centroids

        #最多循环次数 maxiter

#输出:

        #集群中心组 centroids

        #数据点分配情况 cluster_assignment

def kmeans(data, k, initial_centroids, maxiter):

    centroids = initial_centroids[:]

    prev_cluster_assignment = None

    for itr in xrange(maxiter):

        # 计算各数据点到各个centroid的距离

        distances_from_centroids = pairwise_distances(data, centroids, metric='euclidean')

        # 将数据点分配到各个centroid

        cluster_assignment = np.argmin(distances_from_centroids, axis = 1)

        # 将每个centroid的值改成分配到该点的所有数据点的均值

        new_centroids = []

        for i in xrange(k):

            member_data_points = data[cluster_assignment == i]

            centroid = member_data_points.mean(axis = 0)

            # 格式转换

            centroid = centroid.A1

            new_centroids.append(centroid)

        new_centroids = np.array(new_centroids)

        centroids = new_centroids

        # 判断是否收敛到局部最优

        if prev_cluster_assignment is not None and \

          (prev_cluster_assignment==cluster_assignment).all():

            break

        prev_cluster_assignment = cluster_assignment[:]

    return centroids, cluster_assignment
问题1: 算法结果为局部最优,受初始化选择的聚类中心影响很大,如何初始化?
k-means ++:
1.第一个聚类中心从随机点中随机选择。
2.对于每个数据点,计算到最近集群中心的距离。
3.从数据点中选择新的集群中心,数据点选择概率与它离最近的集群中心的距离成比例(使centroids之间离得越远越好)。
4.重复步骤2和3,直到k个中心全被选中。
特点:
随机初始化计算成本相对较高,但随后通常会更迅速地收敛,局部最优质量更高,运行时间短。
def smart_initialize(data, k):

    # k-means++ 方法 得到初始的centroids组

    centroids = np.zeros((k, data.shape[1]))

    # 随机选择第一个centroid

    idx = np.random.randint(data.shape[0])

    centroids[0] = data[idx,:].toarray()

    # 计算其他数据点到第一个centroid的距离

    squared_distances = pairwise_distances(data, centroids[0:1], metric='euclidean').flatten()**2

    # 选择接下来的 k-1 个centroids

    # 每个数据点被选中的概率与它离最近的centroid的距离成比例(即使得centroids之间离得越远越好)

    for i in xrange(1, k):

        idx = np.random.choice(data.shape[0], 1, p=squared_distances/sum(squared_distances))

        centroids[i] = data[idx,:].toarray()

        # 更新每个数据点离已选择的centroids的距离

        squared_distances = np.min(pairwise_distances(data, centroids[0:i+1], metric='euclidean')**2,axis=1)

    return centroids
问题2:如何评价聚类算法结果的质量?
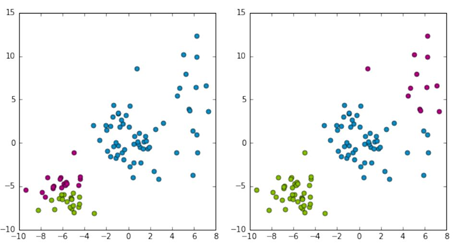
两种聚类方法,第二种更符合我们对聚类算法的预期,如何评估聚类的结果?
最小化距离的平方和:
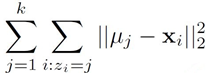
问题3: 如何选择合适的k?
随着k的增加,聚类算法的异质性(heterogeneity)会降低。
heterogeneity 表达式:

方法一:拐点法
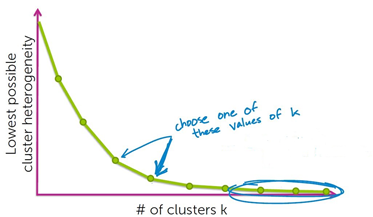
选取拐点处的k值。
方法二:均方根:  (n个数据点)
retrival and clustering : week 3 k-means 笔记的更多相关文章
- retrival and clustering : week 4 GMM & EM 笔记
华盛顿大学 机器学习 笔记. k-means的局限性 k-means 是一种硬分类(hard assignment)方法,例如对于文档分类问题,k-means会精确地指定某一文档归类到某一个主题,但很 ...
- retrival and clustering: week 2 knn & LSH 笔记
华盛顿大学 <机器学习> 笔记. knn k-nearest-neighbors : k近邻法 给定一个 数据集,对于查询的实例,在数据集中找到与这个实例最邻近的k个实例,然后再根据k个最 ...
- KNN 与 K - Means 算法比较
KNN K-Means 1.分类算法 聚类算法 2.监督学习 非监督学习 3.数据类型:喂给它的数据集是带label的数据,已经是完全正确的数据 喂给它的数据集是无label的数据,是杂乱无章的,经过 ...
- C程序设计语言(K&R)笔记
1.表达式中float类型的操作数不会自动转换为double类型.一般来说,数学函数(如math.h)使用双精度类型的变量.使用float类型主要是为了在使用较大数组时节省存储空间,有时也为了节省机器 ...
- 软件——机器学习与Python,聚类,K——means
K-means是一种聚类算法: 这里运用k-means进行31个城市的分类 城市的数据保存在city.txt文件中,内容如下: BJ,2959.19,730.79,749.41,513.34,467. ...
- [DL学习笔记]从人工神经网络到卷积神经网络_1_神经网络和BP算法
前言:这只是我的一个学习笔记,里边肯定有不少错误,还希望有大神能帮帮找找,由于是从小白的视角来看问题的,所以对于初学者或多或少会有点帮助吧. 1:人工全连接神经网络和BP算法 <1>:人工 ...
- 【机器学习笔记之一】深入浅出学习K-Means算法
摘要:在数据挖掘中,K-Means算法是一种 cluster analysis 的算法,其主要是来计算数据聚集的算法,主要通过不断地取离种子点最近均值的算法. 在数据挖掘中,K-Means算法是一种c ...
- kmeans笔记
1.算法过程 a.随机选取k个初始点作为中心点 b.依次计算剩余所有点分别与哪个初始点距离较近,则该点属于哪个簇 c.移动中心点到现在的簇的中心 d.重复b,c两步,直到中心点不再变化算法结束 2.优 ...
- 机器学习10—K-均值聚类学习笔记
机器学习实战之K-Means算法 test10.py #-*- coding:utf-8 import sys sys.path.append("kMeans.py") impor ...
随机推荐
- 《Linux内核设计与实现》笔记-1-linux内核简单介绍
一.Linux内核相对于传统的UNIX内核的比較: (1):Linux支持动态内核模块. 虽然Linux内核也是总体式结构,但是同意在须要的时候动态哦卸除(rmmod xxx)和载入内核模块(insm ...
- ionic 图片加载失败,显示默认图片代替
1.首先编写自定义指令 angular.module('starter.directives', []) //当图片找不到事显示替代图片 .directive("errSrc", ...
- 【FinancialKnowledge】拨备
一句话: 银行拨备就是银行贷款损失减值准备的俗称,其相当于为承担风险和损失的金融资产计提的准备金 通俗易懂的解释见:https://wallstreetcn.com/articles/3307725
- lucene示例
搭建环境 搭建Lucene的开发环境只需要加入Lucene的Jar包,要加入的jar包至少要有: lucene-core-3.0.1.jar(核心包) contrib\analyzers\common ...
- 关于UML图形/图示数量总结
http://www.uml.org/ 第一种说法: UML - Unified Modeling Language UML 共定义了9种图,包括4种结构图和5种形为图: //4种结构图: 类图 对象 ...
- 利用docker创建支持centos的ssh镜像
创建docker镜像需要基础镜像,目前官方已提供了多种基础镜像,参见: https://hub.docker.com/explore/ 要想创建支持centos的ssh镜像,就需要以centos镜像为 ...
- 几种TCP连接中出现RST的情况(转载)
TCP RST 网络 linux 目录[-] 1 端口未打开 2 请求超时 3 提前关闭 4 在一个已关闭的socket上收到数据 总结 参考文献: 应该没有人会质疑,现在是一个网络时代了.应该不少程 ...
- c#.net调用pdf2swf.exe将pdf文件转换为swf,vs中运行正常,布署IIS服务器部署转换后文字部分为空白
这个是权限问题, 需要在应用程序池中高级设置,将标识改为LocalSystem
- linux Apache CGI 安装配置
Apache 中的提交了一种利用扩展应用程序执行动态网页的机制. 称为Common Gateway Interface (通用网关接口)简称CGI. 本文假定已安装好linux(本文的linux版本为 ...
- Atitit. Class 元数据的反射操作 api apache 工具
Atitit. Class 元数据的反射操作 api apache 工具 1 BeanUtils & PropertyUtils & MethodUtils类使用方法 - 短裤党 ...