
memcache的一致性hash算法使用
一、概述
1、我们的memcache客户端(这里我看的spymemcache的源码),使用了一致性hash算法ketama进行数据存储节点的选择。与常规的hash算法思路不同,只是对我们要存储数据的key进行hash计算,分配到不同节点存储。一致性hash算法是对我们要存储数据的服务器进行hash计算,进而确认每个key的存储位置。
2、常规hash算法的应用以及其弊端
最常规的方式莫过于hash取模的方式。比如集群中可用机器适量为N,那么key值为K的的数据请求很简单的应该路由到hash(K) mod N对应的机器。的确,这种结构是简单的,也是实用的。但是在一些高速发展的web系统中,这样的解决方案仍有些缺陷。随着系统访问压力的增长,缓存系统不得不通过增加机器节点的方式提高集群的相应速度和数据承载量。增加机器意味着按照hash取模的方式,在增加机器节点的这一时刻,大量的缓存命不中,缓存数据需要重新建立,甚至是进行整体的缓存数据迁移,瞬间会给DB带来极高的系统负载,设置导致DB服务器宕机。
3、设计分布式cache系统时,一致性hash算法可以帮我们解决哪些问题?
分布式缓存设计核心点:在设计分布式cache系统的时候,我们需要让key的分布均衡,并且在增加cache server后,cache的迁移做到最少。
这里提到的一致性hash算法ketama的做法是:选择具体的机器节点不在只依赖需要缓存数据的key的hash本身了,而是机器节点本身也进行了hash运算。
二、一致性哈希算法情景描述(转载)
1、 hash机器节点
首先求出机器节点的hash值(怎么算机器节点的hash?ip可以作为hash的参数吧。。当然还有其他的方法了),然后将其分布到0~2^32的一个圆环上(顺时针分布)。如下图所示: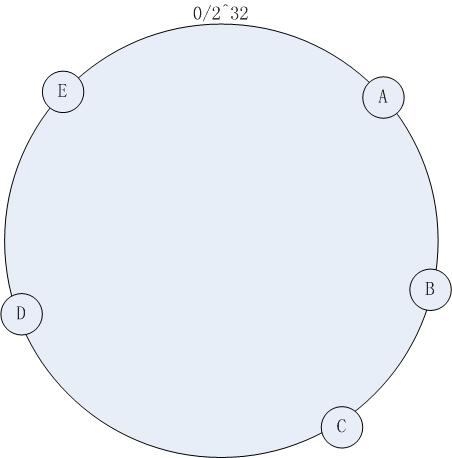
图一
集群中有机器:A , B, C, D, E五台机器,通过一定的hash算法我们将其分布到如上图所示的环上。
2、访问方式
如果有一个写入缓存的请求,其中Key值为K,计算器hash值Hash(K), Hash(K) 对应于图 – 1环中的某一个点,如果该点对应没有映射到具体的某一个机器节点,那么顺时针查找,直到第一次找到有映射机器的节点,该节点就是确定的目标节点,如果超过了2^32仍然找不到节点,则命中第一个机器节点。比如 Hash(K) 的值介于A~B之间,那么命中的机器节点应该是B节点(如上图 )。
3、增加节点的处理
如上图 – 1,在原有集群的基础上欲增加一台机器F,增加过程如下:
计算机器节点的Hash值,将机器映射到环中的一个节点,如下图: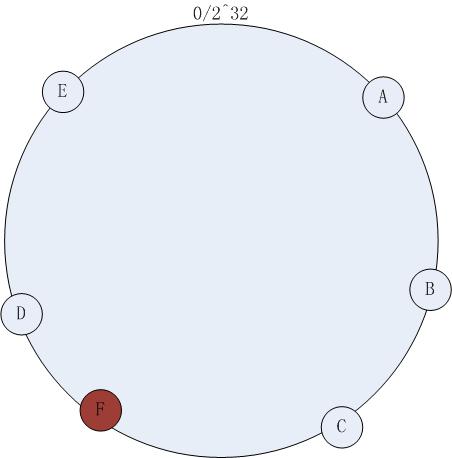
图二
增加机器节点F之后,访问策略不改变,依然按照(2)中的方式访问,此时缓存命不中的情况依然不可避免,不能命中的数据是hash(K)在增加节点以前落在C~F之间的数据。尽管依然存在节点增加带来的命中问题,但是比较传统的 hash取模的方式,一致性hash已经将不命中的数据降到了最低。
Consistent Hashing最大限度地抑制了hash键的重新分布。另外要取得比较好的负载均衡的效果,往往在服务器数量比较少的时候需要增加虚拟节点来保证服务器能均匀的分布在圆环上。因为使用一般的hash方法,服务器的映射地点的分布非常不均匀。使用虚拟节点的思想,为每个物理节点(服务器)在圆上分配100~200个点。这样就能抑制分布不均匀,最大限度地减小服务器增减时的缓存重新分布。用户数据映射在虚拟节点上,就表示用户数据真正存储位置是在该虚拟节点代表的实际物理服务器上。
下面有一个图描述了需要为每台物理服务器增加的虚拟节点。
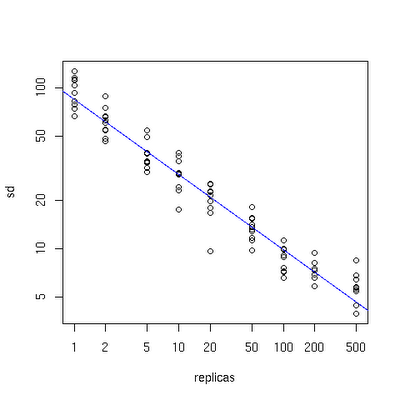
图三
x轴表示的是需要为每台物理服务器扩展的虚拟节点倍数(scale),y轴是实际物理服务器数,可以看出,当物理服务器的数量很小时,需要更大的虚拟节点,反之则需要更少的节点,从图上可以看出,在物理服务器有10台时,差不多需要为每台服务器增加100~200个虚拟节点才能达到真正的负载均衡。
三、以spymemcache源码来演示虚拟节点应用
1、上边描述的一致性Hash算法有个潜在的问题是:
(1)、将节点hash后会不均匀地分布在环上,这样大量key在寻找节点时,会存在key命中各个节点的概率差别较大,无法实现有效的负载均衡。
(2)、如有三个节点Node1,Node2,Node3,分布在环上时三个节点挨的很近,落在环上的key寻找节点时,大量key顺时针总是分配给Node2,而其它两个节点被找到的概率都会很小。
2、这种问题的解决方案可以有:
改善Hash算法,均匀分配各节点到环上;[引文]使用虚拟节点的思想,为每个物理节点(服务器)在圆上分配100~200个点。这样就能抑制分布不均匀,最大限度地减小服务器增减时的缓存重新分布。用户数据映射在虚拟节点上,就表示用户数据真正存储位置是在该虚拟节点代表的实际物理服务器上。
在查看Spy Memcached client时,发现它采用一种称为Ketama的Hash算法,以虚拟节点的思想,解决Memcached的分布式问题。
3、源码说明
该client采用TreeMap存储所有节点,模拟一个环形的逻辑关系。在这个环中,节点之前是存在顺序关系的,所以TreeMap的key必须实现Comparator接口。
那节点是怎样放入这个环中的呢?
- protected void setKetamaNodes(List<MemcachedNode> nodes) {
- TreeMap<Long, MemcachedNode> newNodeMap = new TreeMap<Long, MemcachedNode>();
- int numReps= config.getNodeRepetitions();
- for(MemcachedNode node : nodes) {
- // Ketama does some special work with md5 where it reuses chunks.
- if(hashAlg == HashAlgorithm.KETAMA_HASH) {
- for(int i=0; i<numReps / 4; i++) {
- byte[] digest=HashAlgorithm.computeMd5(config.getKeyForNode(node, i));
- for(int h=0;h<4;h++) {
- Long k = ((long)(digest[3+h*4]&0xFF) << 24)
- | ((long)(digest[2+h*4]&0xFF) << 16)
- | ((long)(digest[1+h*4]&0xFF) << 8)
- | (digest[h*4]&0xFF);
- newNodeMap.put(k, node);
- getLogger().debug("Adding node %s in position %d", node, k);
- }
- }
- } else {
- for(int i=0; i<numReps; i++) {
- newNodeMap.put(hashAlg.hash(config.getKeyForNode(node, i)), node);
- }
- }
- }
- assert newNodeMap.size() == numReps * nodes.size();
- ketamaNodes = newNodeMap;
上面的流程大概可以这样归纳:四个虚拟结点为一组,以getKeyForNode方法得到这组虚拟节点的name,Md5编码后,每个虚拟结点对应Md5码16个字节中的4个,组成一个long型数值,做为这个虚拟结点在环中的惟一key。第10行k为什么是Long型的呢?就是因为Long型实现了Comparator接口。
处理完正式结点在环上的分布后,可以开始key在环上寻找节点的游戏了。
对于每个key还是得完成上面的步骤:计算出Md5,根据Md5的字节数组,通过Kemata Hash算法得到key在这个环中的位置。
- MemcachedNode getNodeForKey(long hash) {
- final MemcachedNode rv;
- if(!ketamaNodes.containsKey(hash)) {
- // Java 1.6 adds a ceilingKey method, but I'm still stuck in 1.5
- // in a lot of places, so I'm doing this myself.
- SortedMap<Long, MemcachedNode> tailMap=getKetamaNodes().tailMap(hash);
- if(tailMap.isEmpty()) {
- hash=getKetamaNodes().firstKey();
- } else {
- hash=tailMap.firstKey();
- }
- }
- rv=getKetamaNodes().get(hash);
- return rv;
- }
上边代码的实现就是在环上顺时针查找,没找到就去的第一个,然后就知道对应的物理节点了。
四、应用场景分析
1、memcache的add方法:通过一致性hash算法确认当前客户端对应的cacheserver的hash值以及要存储数据key的hash进行对应,确认cacheserver,获取connection进行数据存储
2、memcache的get方法:通过一致性hash算法确认当前客户端对应的cacheserver的hash值以及要提取数据的hash值,进而确认存储的cacheserver,获取connection进行数据提取
五、总结
1、一致性hash算法只是帮我们减少cache集群中的机器数量增减的时候,cache的数据能进行最少重建。只要cache集群的server数量有变化,必然产生数据命中的问题
2、对于数据的分布均衡问题,通过虚拟节点的思想来达到均衡分配。当然,我们cache server节点越少就越需要虚拟节点这个方式来均衡负载。
3、我们的cache客户端根本不会维护一个map来记录每个key存储在哪里,都是通过key的hash和cacheserver(也许ip可以作为参数)的hash计算当前的key应该存储在哪个节点上。
4、当我们的cache节点崩溃了。我们必定丢失部分cache数据,并且要根据活着的cache server和key进行新的一致性匹配计算。有可能对部分没有丢失的数据也要做重建...
5、至于正常到达数据存储节点,如何找到key对应的数据,那就是cache server本身的内部算法实现了,此处不做描述。
这里只是针对数据的存储方式以及提取方式进行了流程展示。
memcache的一致性hash算法使用的更多相关文章
- memcache分布式 [一致性hash算法] 的php实现
最近在看一些分布式方面的文章,所以就用php实现一致性hash来练练手,以前一般用的是最原始的hash取模做分布式,当生产过程中添加或删除一台memcache都会造成数据的全部失效,一致性hash就是 ...
- memcache的一致性hash算法
<?php /** * 一致性哈希memcache分布式,采用的是虚拟节点的方式解决分布均匀性问题,查找节点采用二分法快速查找 * the last known user to change t ...
- Nginx+Memcache+一致性hash算法 实现页面分布式缓存(转)
网站响应速度优化包括集群架构中很多方面的瓶颈因素,这里所说的将页面静态化.实现分布式高速缓存就是其中的一个很好的解决方案... 1)先来看看Nginx负载均衡 Nginx负载均衡依赖自带的 ngx_h ...
- php 实现一致性hash 算法 memcache
散列表的应用 涉及到数据查找比对,首先考虑到使用HashSet.HashSet最大的好处就是实现查找时间复杂度为O(1).使用HashSet需要解决一个重要问题:冲突问题.对比研究了网上一些字符串哈希 ...
- 对一致性Hash算法,Java代码实现的深入研究
一致性Hash算法 关于一致性Hash算法,在我之前的博文中已经有多次提到了,MemCache超详细解读一文中"一致性Hash算法"部分,对于为什么要使用一致性Hash算法.一致性 ...
- 一致性hash算法简介与代码实现
一.简介: 一致性hash算法提出了在动态变化的Cache环境中,判定哈希算法好坏的四个定义: 1.平衡性(Balance) 2.单调性(Monotonicity) 3.分散性(Spread) 4.负 ...
- Java实现一致性Hash算法深入研究
一致性Hash算法 关于一致性Hash算法,在我之前的博文中已经有多次提到了,MemCache超详细解读一文中”一致性Hash算法”部分,对于为什么要使用一致性Hash算法和一致性Hash算法的算法原 ...
- 对一致性Hash算法及java实现(转)
一致性Hash算法 关于一致性Hash算法,在我之前的博文中已经有多次提到了,MemCache超详细解读一文中"一致性Hash算法"部分,对于为什么要使用一致性Hash算法.一致性 ...
- 对一致性Hash算法,Java代码实现的深入研究(转)
转载:http://www.cnblogs.com/xrq730/p/5186728.html 一致性Hash算法 关于一致性Hash算法,在我之前的博文中已经有多次提到了,MemCache超详细解读 ...
随机推荐
- 高并发分布式系统中生成全局唯一Id汇总
数据在分片时,典型的是分库分表,就有一个全局ID生成的问题.单纯的生成全局ID并不是什么难题,但是生成的ID通常要满足分片的一些要求: 1 不能有单点故障. 2 以时间为序,或者ID里包含时间 ...
- zen coding和emmet
zen coding 改名为 emmet http://emmet.io/download/
- No.1__C#
这是第一篇C#的日记,到现在为止已经学习了一个礼拜的C#了.由于是实习中才开始学习,所以这次不准备像在大学学习那样,拿着课本划重点,背概念.这应当是一门实践的课程,应该一边编程,一边学.这是到公司第一 ...
- (转载)SQL Server 2005 如何启用xp_cmdshell组件
原文地址:http://www.cnblogs.com/atree/p/SQL_SERVER_xp_cmdshell.html [错误描述]: SQL Server阻止了对组件‘xp_cmdshell ...
- [Git].gitignore失效的原因
使用git管理源代码已经成为现在开源社区的一大选择. 开发的人都知道,在源代码管理中,我们需要监控和备份的是代码,而不是开发过程中生成的exe和dll文件.//即使在某些时候,我们需要某些dll,我们 ...
- C++设计模式-Builder建造者模式
作用:将一个复杂对象的构建与它的表示分离,使得同样的构建过程可以创建不同的表示. Builder模式和AbstractFactory模式在功能上很相似,因为都是用来创建大的复杂的对象,它们的区别是:B ...
- .NET 扩展方法
.NET 的扩展方法是在.NET 3.0引入的,MSDN给出的定义是:扩展方法使你能够向现有类型“添加”方法(包括你自定义的类型和对象噢),而无需创建新的派生类型.重新编译或以其他方式修改原始类型.扩 ...
- 解决多网卡SNMP获取不到数据的问题
前言 前几天,公司的某个平台突然访问不了,我以为是网站挂了,于是想连接服务器查看,谁知道连服务器都连不上,然后我尝试PING,结果一直PING不通,此时我有点慌了,但我的头脑还是保持清醒的,我马上连接 ...
- 搭建java,oracle,plsql开发环境
一:安装jdk和jre; (1)有两种方法:1,从官网网址上安装:2,安装绿色版 (2)配置环境变量 在"系统变量"下进行如下配置: (1)新建->变量名:JAVA_HOME ...
- SQL Server SELECT逻辑处理顺序
SQL Server SELECT语句,逻辑处理顺序,虽然SELECT位于语句最前面,它在逻辑处理中,基本上是最后一个被执行的部分. 下面列出查询子句在逻辑上处理顺序: 1. FROM 2. WH ...