
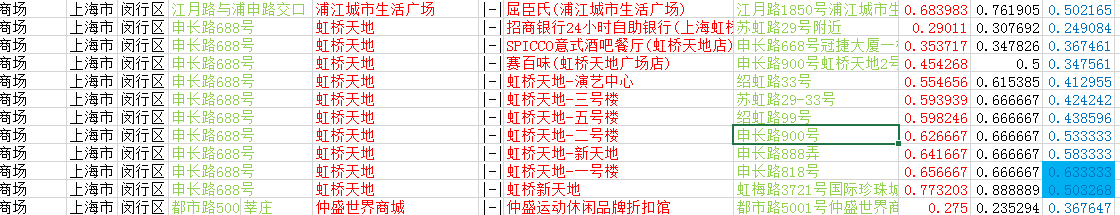
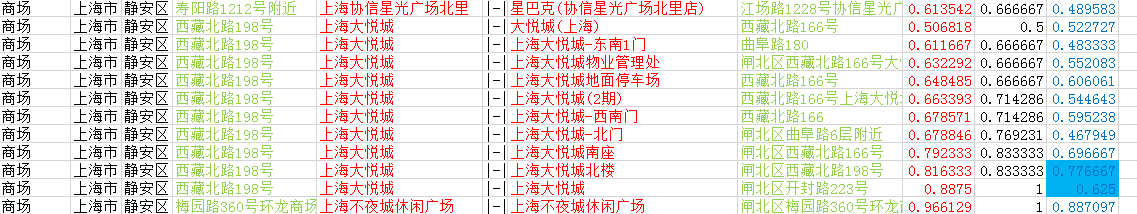
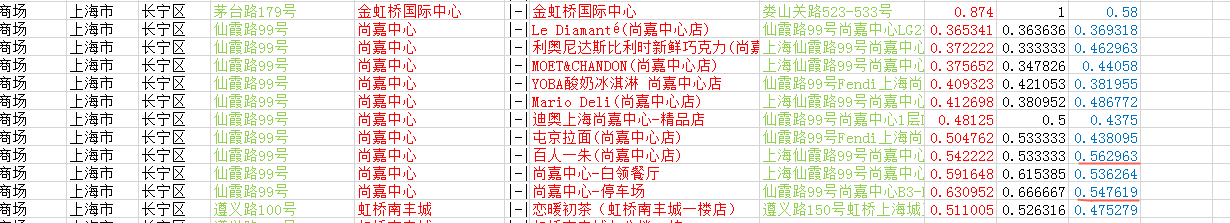
算法调参 weight_ratio, weight_seqratio
from openpyxl import Workbook

import xlrd

import time

import Levenshtein as Le

target_city_list = ['北京市', '上海市', '深圳市', '广州市']

source_name = 'JMTool任务_csv_py_wholeCSV-加百度170826165729'

BDpoi_list_tag, BDpoi_list_tagb = '|-|', '|--|'

FEXCEL = '%s%s' % (source_name, '.xlsx')

weight_ratio, weight_seqratio = 0.7, 0.3

def main_():

    global source_name

    data = xlrd.open_workbook(FEXCEL)

    table = data.sheets()[0]

    nrows, ncols = table.nrows, table.ncols

    res_dic = {}

    for i in range(0, nrows):

        l = table.row_values(i)

        dbid, area_code, ref_area_type_code, city, district, address, city_street, name_, BDpoi_list = l

        if dbid == 'dbid':

            continue

        if city not in target_city_list:

            continue

        if city not in res_dic:

            res_dic[city] = {}

        if district not in res_dic[city]:

            res_dic[city][district] = {}

        if name_ not in res_dic[city][district]:

            res_dic[city][district][name_] = []

        if BDpoi_list.find(BDpoi_list_tag) == -1:

            ll = dbid, area_code, ref_area_type_code, city, district, address, city_street, name_, BDpoi_list, '', '', ''

            res_dic[city][district][name_].append(ll)

        else:

            addr_ = '%s%s%s%s' % (city, district, address, city_street)

            chk_name_lsit, cmp_list, sorted_ratio_seqratio_res_dic = [name_, addr_], BDpoi_list.split(

                BDpoi_list_tag), {}

            for ii in cmp_list:

                if len(ii) == 0:

                    continue

                cmp_, BD_name, BD_addr = ['', ''], '', ''

                cmp_one = ii.split(BDpoi_list_tagb)

                if len(cmp_one) == 2:

                    # format data -fair

                    BD_name, BD_addr = cmp_[0], cmp_[1] = cmp_one[0], cmp_one[1].replace(city, '').replace(district, '')

                else:

                    BD_name = cmp_[0] = cmp_one[0]

                ratio_res, seqratio_res = Le.ratio(name_, BD_name), Le.seqratio(chk_name_lsit, cmp_)

                ratio_seqratio_res = weight_ratio * ratio_res + weight_seqratio * seqratio_res

                ll = dbid, area_code, ref_area_type_code, city, district, address, city_street, name_, BDpoi_list, BD_name, BD_addr, ratio_seqratio_res, ratio_res, seqratio_res

                if ratio_seqratio_res not in sorted_ratio_seqratio_res_dic:

                    sorted_ratio_seqratio_res_dic[ratio_seqratio_res] = []

                sorted_ratio_seqratio_res_dic[ratio_seqratio_res].append(ll)

            sorted_seqratio_res_list = sorted(sorted_ratio_seqratio_res_dic)

            for ratio_seqratio_res in sorted_seqratio_res_list:

                lll = sorted_ratio_seqratio_res_dic[ratio_seqratio_res]

                for vl in lll:

                    res_dic[city][district][name_].append(vl)

    wb = Workbook()

    worksheet = wb.active

    file_title_str = ' dbid, area_code, ref_area_type_code, city, district, address, city_street, name_, BDpoi_list, BD_name, BD_addr, ratio_seqratio_res, ratio_res, seqratio_res'

    file_title_l = file_title_str.replace(' ', '').split(',')

    worksheet.append(file_title_l)

    for city in res_dic:

        for district in res_dic[city]:

            for name_ in res_dic[city][district]:

                l = res_dic[city][district][name_]

                for ll in l:

                    worksheet.append(ll)

    localtime_ = time.strftime("%y%m%d%H%M%S", time.localtime())

    file_name = '%s%s%s' % (source_name, '-Levenshtein', localtime_)

    file_name_save = '%s%s' % (file_name, '.xlsx')

    wb.save(file_name_save)

    wb = Workbook()

    worksheet = wb.active

    file_title_str = ' dbid, area_code, ref_area_type_code, city, district, address, city_street, name_,BDpoi_list,max_BD_name, max_BD_addr, max_ratio_seqratio_res, ratio_res, seqratio_res'

    file_title_l = file_title_str.replace(' ', '').split(',')

    worksheet.append(file_title_l)

    for city in res_dic:

        for district in res_dic[city]:

            for name_ in res_dic[city][district]:

                l = res_dic[city][district][name_]

                lll = l[-1]

                worksheet.append(lll)

    localtime_ = time.strftime("%y%m%d%H%M%S", time.localtime())

    file_name = '%s%s%s' % (file_name, '-Levenshtein-ordered', localtime_)

    file_name_save = '%s%s' % (file_name, '.xlsx')

    wb.save(file_name_save)

main_()
from openpyxl import Workbook

import xlrd

import time

import Levenshtein as Le

target_city_list = ['深圳市']

BDpoi_list_tag, BDpoi_list_tagb = '|-|', '|--|'

source_name = 'JMTool任务_csv_py_wholeCSV_住宅小区-加百度170826152533'

FEXCEL = '%s%s' % (source_name, '.xlsx')

weight_ratio, weight_seqratio = 0.7, 0.3

def main_():

    global source_name

    data = xlrd.open_workbook(FEXCEL)

    table = data.sheets()[0]

    nrows, ncols = table.nrows, table.ncols

    res_dic = {}

    for i in range(0, nrows):

        l = table.row_values(i)

        dbid, area_code, ref_area_type_code, city, district, address, city_street, name_, name_reduction, BDpoi_list = l

        if dbid == 'dbid':

            continue

        if city not in target_city_list:

            continue

        if city not in res_dic:

            res_dic[city] = {}

        if district not in res_dic[city]:

            res_dic[city][district] = {}

        if name_ not in res_dic[city][district]:

            res_dic[city][district][name_] = []

        if BDpoi_list.find(BDpoi_list_tag) == -1:

            ll = dbid, area_code, ref_area_type_code, city, district, address, city_street, name_, name_reduction, BDpoi_list, '', '', ''

            res_dic[city][district][name_].append(ll)

        else:

            addr_ = '%s%s%s%s' % (city, district, address, city_street)

            chk_name_lsit, cmp_list, sorted_ratio_seqratio_res_dic = [name_reduction, addr_], BDpoi_list.split(

                BDpoi_list_tag), {}

            for ii in cmp_list:

                if len(ii) == 0:

                    continue

                cmp_, BD_name, BD_addr = ['', ''], '', ''

                cmp_one = ii.split(BDpoi_list_tagb)

                if len(cmp_one) == 2:

                    # format data -fair

                    BD_name, BD_addr = cmp_[0], cmp_[1] = cmp_one[0], cmp_one[1].replace(city, '').replace(district, '')

                else:

                    BD_name = cmp_[0] = cmp_one[0]

                ratio_res, seqratio_res = Le.ratio(name_reduction, BD_name), Le.seqratio(chk_name_lsit, cmp_)

                ratio_seqratio_res = weight_ratio * ratio_res + weight_seqratio * seqratio_res

                ll = dbid, area_code, ref_area_type_code, city, district, address, city_street, name_, name_reduction, BDpoi_list, BD_name, BD_addr, ratio_seqratio_res, ratio_res, seqratio_res

                if ratio_seqratio_res not in sorted_ratio_seqratio_res_dic:

                    sorted_ratio_seqratio_res_dic[ratio_seqratio_res] = []

                sorted_ratio_seqratio_res_dic[ratio_seqratio_res].append(ll)

            sorted_seqratio_res_list = sorted(sorted_ratio_seqratio_res_dic)

            for ratio_seqratio_res in sorted_seqratio_res_list:

                lll = sorted_ratio_seqratio_res_dic[ratio_seqratio_res]

                for vl in lll:

                    res_dic[city][district][name_].append(vl)

    wb = Workbook()

    worksheet = wb.active

    file_title_str = 'dbid, area_code, ref_area_type_code, city, district, address, city_street, name_, name_reduction, BDpoi_list, BD_name, BD_addr, ratio_seqratio_res, ratio_res, seqratio_res'

    file_title_l = file_title_str.replace(' ', '').split(',')

    worksheet.append(file_title_l)

    for city in res_dic:

        for district in res_dic[city]:

            for name_ in res_dic[city][district]:

                l = res_dic[city][district][name_]

                for ll in l:

                    worksheet.append(ll)

    localtime_ = time.strftime("%y%m%d%H%M%S", time.localtime())

    file_name = '%s%s%s' % (source_name, '-Levenshtein', localtime_)

    file_name_save = '%s%s' % (file_name, '.xlsx')

    wb.save(file_name_save)

    wb = Workbook()

    worksheet = wb.active

    file_title_str = 'dbid, area_code, ref_area_type_code, city, district, address, city_street, name_, name_reduction,BDpoi_list,max_BD_name, max_BD_addr, max_ratio_seqratio_res, ratio_res, seqratio_res'

    file_title_l = file_title_str.replace(' ', '').split(',')

    worksheet.append(file_title_l)

    for city in res_dic:

        for district in res_dic[city]:

            for name_ in res_dic[city][district]:

                l = res_dic[city][district][name_]

                lll = l[-1]

                worksheet.append(lll)

    localtime_ = time.strftime("%y%m%d%H%M%S", time.localtime())

    file_name = '%s%s%s' % (file_name, '-Levenshtein-ordered', localtime_)

    file_name_save = '%s%s' % (file_name, '.xlsx')

    wb.save(file_name_save)

main_()
算法调参 weight_ratio, weight_seqratio的更多相关文章
- annoy ANN算法 调参
search_k serach_k越大,越准确,但是要在时间和准确率之间取个trade off During the query it will inspect up to search_k node ...
- CatBoost算法和调参
欢迎关注博主主页,学习python视频资源 sklearn实战-乳腺癌细胞数据挖掘(博主亲自录制视频) https://study.163.com/course/introduction.htm?co ...
- k-近邻算法采用for循环调参方法
//2019.08.02下午#机器学习算法中的超参数与模型参数1.超参数:是指机器学习算法运行之前需要指定的参数,是指对于不同机器学习算法属性的决定参数.通常来说,人们所说的调参就是指调节超参数.2. ...
- 调参、最优化、ml算法(未完成)
最优化方法 调参方法 ml算法 梯度下降gd grid search lr 梯度上升 随机梯度下降 pca 随机梯度下降sgd 贝叶斯调参 lda 牛顿算法 knn 拟牛顿算法 kmeans ...
- scikit-learn随机森林调参小结
在Bagging与随机森林算法原理小结中,我们对随机森林(Random Forest, 以下简称RF)的原理做了总结.本文就从实践的角度对RF做一个总结.重点讲述scikit-learn中RF的调参注 ...
- scikit-learn 梯度提升树(GBDT)调参小结
在梯度提升树(GBDT)原理小结中,我们对GBDT的原理做了总结,本文我们就从scikit-learn里GBDT的类库使用方法作一个总结,主要会关注调参中的一些要点. 1. scikit-learn ...
- word2vec参数调整 及lda调参
一.word2vec调参 ./word2vec -train resultbig.txt -output vectors.bin -cbow 0 -size 200 -window 5 -neg ...
- 漫谈PID——实现与调参
闲话: 作为一个控制专业的学生,说起PID,真是让我又爱又恨.甚至有时候会觉得我可能这辈子都学不会pid了,但是经过一段时间的反复琢磨,pid也不是很复杂.所以在看懂pid的基础上,写下这篇文章,方便 ...
- hyperopt自动调参
hyperopt自动调参 在传统机器学习和深度学习领域经常需要调参,调参有些是通过通过对数据和算法的理解进行的,这当然是上上策,但还有相当一部分属于"黑盒" hyperopt可以帮 ...
随机推荐
- 为什么实现Serializbale接口就能够进行序列化?
从所周知,Serializbale接口是个空的接口,并没有定义任何方法.那么问题来了,为什么需要序列化的接口只要实现Serializbale接口就能够进行序列化? 这要从序列化过程的源码说起.举个例子 ...
- [转载]JAVA调用Shell脚本
FROM:http://blog.csdn.net/jj12345jj198999/article/details/11891701 在实际项目中,JAVA有时候需要调用C写出来的东西,除了JNI以外 ...
- 关于web后门权限防删的一个新思路
见土司有一帖子 具体看下面连接 https://www.t00ls.net/thread-26444-1-2.html 这是php的 其实IIS也有类似的 这是MSF生成的一个ASPX执行shellc ...
- 【DB2】db2命令Export与Import
环境准备 1.新建表 qinys@Linux:~> db2 "create table tb1(id int,dt timestamp,name varchar(100))" ...
- 51单片机 | A/D转换器实现数字电压表实例
———————————————————————————————————————————— ADC0809 - - - - - - - - - - - - - - - - - - - - - - - - ...
- centos安装pip Xvfb Selenium
pip安装命令: python -V wget https://bootstrap.pypa.io/get-pip.py python get-pip.py Xvfb安装命令: yum install ...
- 正则化--Lambda
模型开发者通过以下方式来调整正则化项的整体影响:用正则化项的值乘以名为 lambda(又称为正则化率)的标量.也就是说,模型开发者会执行以下运算: $$\text{minimize(Loss(Data ...
- 【转】.NET(C#):浅谈程序集清单资源和RESX资源 关于单元测试的思考--Asp.Net Core单元测试最佳实践 封装自己的dapper lambda扩展-设计篇 编写自己的dapper lambda扩展-使用篇 正确理解CAP定理 Quartz.NET的使用(附源码) 整理自己的.net工具库 GC的前世与今生 Visual Studio Package 插件开发之自动生
[转].NET(C#):浅谈程序集清单资源和RESX资源 目录 程序集清单资源 RESX资源文件 使用ResourceReader和ResourceSet解析二进制资源文件 使用ResourceM ...
- svn client命令
经常使用svn命令说明 1.从SVN仓库中检索出代码到工作拷贝: # svn checkout https://svn.sinaapp.com/appname [workcopy] 当中workcop ...
- Mongodb基本操作入门,增删改查和索引
主要进程 mongod.exe为启动数据库实例的进程. mongo是一个与mongod进程进行交互的JavaScript shell进程,它提供了一些交互的接口函数用户对数据库的管理. 基本命令 sh ...