
Hadoop 2.x简介
Hadoop 2.0产生背景
- Hadoop1.0中HDFS和MapReduce在高可用、扩展性等方面存在问题
- HDFS存在的问题
- NameNode单点故障,难以应用于在线场景
- NameNode压力过大,且内存受限,影响系统扩展性
- MapReduce存在的问题
- JobTracker访问压力大,影响系统扩展性
- 难以支持除MapReduce之外的计算框架,比如Spark 、Storm等
MapReduce是离线计算框架,计算时间会比较长
Spark是内存计算框架,更快
Storm是流计算框架,可实时获取计算结果
Hadoop 1.x 与Hadoop 2.x
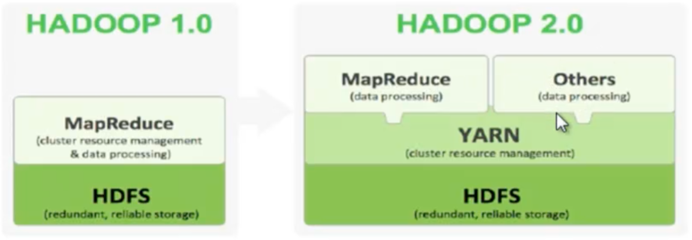
- Hadoop 2.x由HDFS、MapReduce和YARN三个分支构成
- HDFS : NN Federation、HA;
- MapReduce : 运行在YARN上的MR
- YARN : 资源管理系统(内存、CPU资源)
Federation把元数据分成两个独立的NameNode去工作。
YARN知道任何一台机器的使用情况,在执行任务的时候,首先去YARN上申请,YARN 分配到某台机器上去执行,可做到资源不浪费
HDFS存储的数据可由MapReduce进行计算,也可以由其它的计算框架计算
HDFS 2.x优点
- 解决HDFS 1.0中单点故障和内存受限问题
- 解决单点故障
- HDFS HA : 通过主备NameNode解决(只有一个NameNode正常工作,其它都是备用)
- 如果主NameNode发生故障,则切换到备NameNode上
- 解决内存受限问题
- HDFS Federation(联邦)
- 水平扩展,支持多个NameNode
- 每个NameNode分管一部分目录(相互独立)
- 所有NameNode共享所有DataNode存储资源
- 2.x仅是架构上发生了变化,使用方式不变
- 对HDFS使用者透明
- HDFS 1.X中的命令和API仍可以使用
Hadoop 2.x简介的更多相关文章
- Hadoop开发环境简介(转)
1.Hadoop开发环境简介 1.1 Hadoop集群简介 Java版本:jdk-6u31-linux-i586.bin Linux系统:CentOS6.0 Hadoop版本:hadoop-1.0.0 ...
- Hadoop发展历史简介
简介 本篇文章主要介绍了Hadoop系统的发展历史以及商业化现状, 科普文. 如果你喜欢本博客,请点此查看本博客所有文章:http://www.cnblogs.com/xuanku/p/index.h ...
- Hadoop体系架构简介
今天跟一个朋友在讨论hadoop体系架构,从当下流行的Hadoop+HDFS+MapReduce+Hbase+Pig+Hive+Spark+Storm开始一直讲到HDFS的底层实现,MapReduce ...
- 二十六、Hadoop学习笔记————Hadoop Yarn的简介复习
1. 介绍 YARN(Yet Another Resource Negotiator)是一个通用的资源管理平台,可为各类计算框架提供资源的管理和调度. 之前有提到过,Yarn主要是为了减轻Hadoop ...
- Hadoop mapreduce框架简介
传统hadoop MapReduce架构(老架构) 从上图中可以清楚的看出原 MapReduce 程序的流程及设计思路: 1.首先用户程序 (JobClient) 提交了一个 job,job ...
- Hadoop主要生态系统简介
Hadoop的起源 Doug Cutting是Hadoop之父 ,起初他开创了一个开源软件Lucene(用Java语言编写,提供了全文检索引擎的架构,与Google类似),Lucene后来面临与Goo ...
- hadoop(十一)HDFS简介和常用命令介绍
HDFS背景 随着数据量的增大,在一个操作系统中内存不了了,就需要分配到操作系统的的管理磁盘中,但是不方便管理者维护,迫切需要一种系统来管理多态机器上的文件,这就是分布式文件管理系统. HDFS的概念 ...
- hadoop学习笔记(一):hadoop生态系统及简介
一.hadoop1.x的生态系统 HBase:实时分布式数据库 相当于关系型数据库,数据放在文件中,文件就放在HDFS中.因此HBase是基于HDFS的关系型数据库.实时性:延迟非常低,实时性高. 举 ...
- 【hadoop】——window下elicpse连接hadoop集群基础超详细版
1.Hadoop开发环境简介 1.1 Hadoop集群简介 Java版本:jdk-6u31-linux-i586.bin Linux系统:CentOS6.0 Hadoop版本:hadoop-1.0.0 ...
随机推荐
- Hibernate学习之二级缓存
© 版权声明:本文为博主原创文章,转载请注明出处 二级缓存 - 二级缓存又称“全局缓存”.“应用级缓存” - 二级缓存中的数据可适用范围是当前应用的所有会话 - 二级缓存是可插拔式缓存,默认是EHCa ...
- 浅谈BloomFilter【上】基本概念和实现原理
在日常生活中.包括在设计计算机软件时,我们常常要推断一个元素是否在一个集合中. 比方在字处理软件中,须要检查一个英语单词是否拼写正确(也就是要推断 它是否在已知的字典中).在 FBI. ...
- poj3411--Paid Roads(bfs+状压)
题目链接:id=3411">点击打开链接 题目大意:有n个点.m条有向边,经过边须要一个花费,a b c p q代表 a到b的一条道路,假设经过这条边之前经过c点,那么须要p的花费,否 ...
- java中高级写法
1.低级写法: if (null != redisCacheService.get(MediaConstants.GUANGDIANTONG_YOUMI + CommonConstants.PLUS ...
- 《Lucene in Action第二版》学习总结---如何在Windows下编译luceneinAction2Edition源码包
1. 下载此源码包,位置是: www.manning.com/hatcher3,得到:lia2e.tar.gz,然后解压缩得到目录:lia2e,为了以后能辨识,我将此目录改名为:luceneinAct ...
- LeetCode78:Subsets
Given a set of distinct integers, nums, return all possible subsets. Note: Elements in a subset must ...
- UFLDL深度学习笔记 (四)用于分类的深度网络
UFLDL深度学习笔记 (四)用于分类的深度网络 1. 主要思路 本文要讨论的"UFLDL 建立分类用深度网络"基本原理基于前2节的softmax回归和 无监督特征学习,区别在于使 ...
- diamond源码阅读-目录监控
PathNode(Path)StandardWatchEventKind(WatchEvent)Watchable(WatchKey WatchService WatchEvent)WatchKey( ...
- requestFullscreen实现全屏展示
requestFullscreen实现全屏展示. var fullContainer = document.getElementById('fullScreenContainer'); //先把元素展 ...
- Linux进程间通信(IPC)机制总览
Linux进程间通信 Ø 管道与消息队列 ü 匿名管道,命名管道 ü 消息队列 Ø 信号 ü 信号基础 ü 信号应用 Ø 锁与信号灯 ü 记录锁 ü 有名信号灯 ü 无名信号灯(基 ...