
spark java wordCount实例
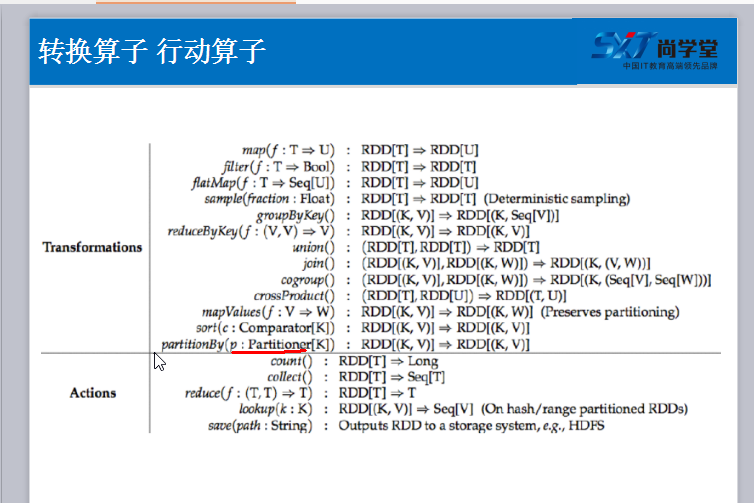
1. 算子
package com.test;

import java.util.Arrays;

import java.util.List;

import org.apache.spark.SparkConf;

import org.apache.spark.api.java.JavaPairRDD;

import org.apache.spark.api.java.JavaRDD;

import org.apache.spark.api.java.JavaSparkContext;

import org.apache.spark.api.java.function.FlatMapFunction;

import org.apache.spark.api.java.function.Function2;

import org.apache.spark.api.java.function.PairFunction;

import org.apache.spark.api.java.function.VoidFunction;

import scala.Tuple2;

public class Test {

    private static final int Function2 = 0;

    public static void main(String[] args) {

        SparkConf sparkConf = new SparkConf()

                .setAppName("Test")

                .setMaster("local");

        JavaSparkContext sc = new JavaSparkContext(sparkConf);

        JavaRDD linesRdd = sc.textFile("/home/test/a.txt");

        /**

         * FlatMapFunction 中的2个String   分别代表输入参数类型和输出参数类型

         */

        JavaRDD<String> wordsRDD = linesRdd.flatMap(new FlatMapFunction<String, String>(){

            private static final long serialVersionUID = 1L;

            @Override

            public Iterable<String> call(String line) throws Exception {

                /**

                 * 参数 line 就代表 linesRDD中的每一条记录

                 */

                List<String> list = Arrays.asList(line.split(" "));

                return list;

            }

        });

        /**

         * 要将每一个单词计数为1

         * wordsRDD 是一个非 K V 格式的Rdd,

         * 在java api 中要返回一个K V 格式的rdd, 必须使用 mapToPair 方法

         * return 结果就是一个 K V 格式

         */

        JavaPairRDD<String, Integer> pairRDD = wordsRDD.mapToPair(new PairFunction<String, String, Integer>() {

            private static final long serialVersionUID = 1L;

            @Override

            public Tuple2<String, Integer> call(String word) throws Exception {

                return new Tuple2<String, Integer>(word, 1);

            }

        });

        /**

         * 使用reduceByKey 进行聚合操作

         * 1. 进行 groupByKey 将相同的 key 分割到一个组里去, 然后通过传入的函数对主内的数据进行聚合

         * call 方法将会自动将个数循环相加

         */

        JavaPairRDD<String, Integer> resultRdd = pairRDD.reduceByKey(new Function2<Integer, Integer, Integer>() {

            private static final long serialVersionUID = 1L;

            @Override

            public Integer call(Integer v1, Integer v2) throws Exception {

                return v1+v2;

            }

        });

        /**

         * 按照单词出现的次数进行排序,   应为排序需要对 v 值(出现个数)进行排序, 所以需要将 K V, 进行调换,  因为sortByKey只对key能进行排序

         * 先使用 mapToPair 来调换位置

         * sortByKey 进行排序

         * 再使用 mapToPair 来调换位置

         */

        resultRdd.mapToPair(new PairFunction<Tuple2<String,Integer>, Integer, String>() {

            private static final long serialVersionUID = 1L;

            @Override

            public Tuple2<Integer, String> call(Tuple2<String, Integer> tuple) throws Exception {

                return new Tuple2<Integer, String>(tuple._2,tuple._1);

            }

        }).sortByKey().mapToPair(new PairFunction<Tuple2<Integer,String>, String, Integer>() {

            private static final long serialVersionUID = 1L;

            @Override

            public Tuple2<String, Integer> call(Tuple2<Integer, String> tuple) throws Exception {

                return new Tuple2<String, Integer>(tuple._2, tuple._1);

            }

        }).foreach(new VoidFunction<Tuple2<String,Integer>>() {

            private static final long serialVersionUID = 1L;

            @Override

            public void call(Tuple2<String, Integer> tuple) throws Exception {

                System.out.println(tuple);

            }

        });

    }

}
jar包 链接:https://pan.baidu.com/s/1UDp81G8tY7IgwJatlT_1Vg 密码:yj06
spark java wordCount实例的更多相关文章
- 初试spark java WordCount
初始环境:OS X 10.10.5 准备:boot2docker 进入boot2docker后安装 docker-spark 地址: https://github.com/sequenceiq/do ...
- 梯度迭代树(GBDT)算法原理及Spark MLlib调用实例(Scala/Java/python)
梯度迭代树(GBDT)算法原理及Spark MLlib调用实例(Scala/Java/python) http://blog.csdn.net/liulingyuan6/article/details ...
- 编写Spark的WordCount程序并提交到集群运行[含scala和java两个版本]
编写Spark的WordCount程序并提交到集群运行[含scala和java两个版本] 1. 开发环境 Jdk 1.7.0_72 Maven 3.2.1 Scala 2.10.6 Spark 1.6 ...
- 1.spark的wordcount解析
一.Eclipse(scala IDE)开发local和cluster (一). 配置开发环境 要在本地安装好java和scala. 由于spark1.6需要scala 2.10.X版本的.推荐 2 ...
- wordcount实例
scala的wordcount实例 package com.wondersgroup.myscala import scala.actors.{Actor, Future} import scala. ...
- Hadoop3 在eclipse中访问hadoop并运行WordCount实例
前言: 毕业两年了,之前的工作一直没有接触过大数据的东西,对hadoop等比较陌生,所以最近开始学习了.对于我这样第一次学的人,过程还是充满了很多疑惑和不解的,不过我采取的策略是还是先让环 ...
- [转] 用SBT编译Spark的WordCount程序
问题导读: 1.什么是sbt? 2.sbt项目环境如何建立? 3.如何使用sbt编译打包scala? [sbt介绍 sbt是一个代码编译工具,是scala界的mvn,可以编译scala,java等,需 ...
- spark (java API) 在Intellij IDEA中开发并运行
概述:Spark 程序开发,调试和运行,intellij idea开发Spark java程序. 分两部分,第一部分基于intellij idea开发Spark实例程序并在intellij IDEA中 ...
- 用SBT编译Spark的WordCount程序
问题导读: 1.什么是sbt? 2.sbt项目环境如何建立? 3.如何使用sbt编译打包scala? sbt介绍 sbt是一个代码编译工具,是scala界的mvn,可以编译scala,java等,需要 ...
随机推荐
- Makefile 调试
一.简介 GNU make 提供了若干可以协助调试的内置函数以及命令行选项. 用来调试makefile 的一个最好方法就是加入调试挂钩以及使用具保护的编程技术,让你能够在事情出错时恢复原状. 二.ma ...
- grid search
sklearn.metrics.make_scorer(score_func, greater_is_better=True, needs_proba=False, needs_threshold=F ...
- Vue.js路由组件
1.如果在创建项目中,没有自动安装vue router,那就自行安装.cnpm install vue-router --save vue-router两种模式 hash模式和history模式. 默 ...
- jQuery 2.1.4版本的源码分析
jQuery 2.1.4版本的源码分析 jquery中获取元素的源码分析 jQuery.each({// 获取当前元素的父级元素 parent: function(elem) { var parent ...
- CentOS7下源码包方式安装rabbitmq
1.先安装erlang http://www.cnblogs.com/justphp/p/6093880.html 2.下载rabbitmq rpm包: wget http://www.rabbitm ...
- python 字符串,元组, 列表,字典之间的转换
#-*-coding:utf-8-*- #1.字典 dict = {'name': 'Zara', 'age': 7, 'class': 'First'} #字典转为字符串,返回:<type ' ...
- Java web 三层架构 模拟图
- NAO机器人
NAO机器人是Aldebaran Robotics公司研制的一款人工智能机器人.它拥有着讨人喜欢的外形,并具备有一定程度的人工智能和约一定程度的情感智商并能够和人亲切的互动. 教学研究类/NAO机器人 ...
- 通过fork函数创建进程的跟踪,分析linux内核进程的创建
作者:吴乐 山东师范大学 <Linux内核分析>MOOC课程http://mooc.study.163.com/course/USTC-1000029000 一.实验过程 1.打开gdb, ...
- OkHttp3的简单使用(一)
一.导入 1)gradle方式: compile 'com.squareup.okhttp3:okhttp:3.8.0'(okhttp 最新版) compile 'com.squareup.okio: ...