
数据科学:Pandas 和 Series 的 describe() 方法
一、Pandas 和 Series 的 describe() 方法
1)功能
功能:对数据中每一列数进行统计分析;(以“列”为单位进行统计分析)
- 默认只先对“number”的列进行统计分析;
一列数据全是“number”
- count:一列的元素个数;
- mean:一列数据的平均值;
- std:一列数据的均方差;(方差的算术平方根,反映一个数据集的离散程度:越大,数据间的差异越大,数据集中数据的离散程度越高;越小,数据间的大小差异越小,数据集中的数据离散程度越低)
- min:一列数据中的最小值;
- max:一列数中的最大值;
- 25%:一列数据中,前 25% 的数据的平均值;
- 50%:一列数据中,前 50% 的数据的平均值;
- 75%:一列数据中,前 75% 的数据的平均值;
一列数据: “categorical”、“categorical” + “number”:
- count:一列数据的元素个数;
- unique:一列数据中元素的种类;
- top:一列数据中出现频率最高的元素;
- freq:一列数据中出现频率最高的元素的个数;
一列数据:object(如时间序列)
- first:开始时间;
- last:结束时间;
2)实例及参数使用:Series 数据类型
number
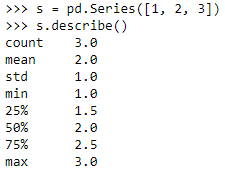
categorical

object(统称为 “string” 类)

3)实例及参数使用:DataFrame 数据类型
(一)默认只处理 number
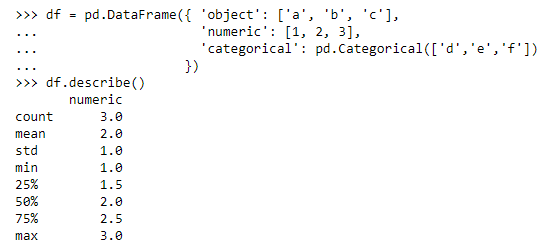
(二)分析整个 DataFrame 数据:include = 'all'

(三)指定统计分析 DataFrame 中的某一列

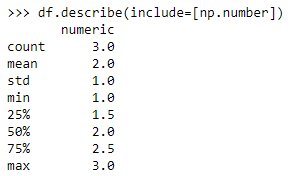
(四)只分析所有的 “number” 列
- 也可以是:df.describe(include=['number'])
(五)只分析所有 “category” 列

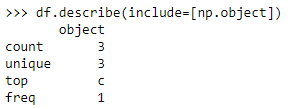
(六)只统计所有 “object” 列
(七)分析除了 “number” 列的所有列
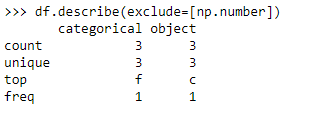
(八)分析除了 “object” 列的所有列

4)与 loc、sort 的配合使用
- df.describe(include=['number']).loc[['min', 'max', 'mean', 'std']].T.sort_values('max')
- 只对数据的“min”、“max”、“mean”、“std”进行分析,并将分析的结果转置后,以“max”的大小对每行进行排序;(默认从小到大)
数据科学:Pandas 和 Series 的 describe() 方法的更多相关文章
- 读书笔记一、pandas之series
转自 # 直接传入一组数据 from pandas import Series, DataFrame obj = Series([4, 2, 3]) obj 0 4 1 2 2 3 dtype: in ...
- (数据科学学习手札131)pandas中的常用字符串处理方法总结
本文示例代码及文件已上传至我的Github仓库https://github.com/CNFeffery/DataScienceStudyNotes 1 简介 在日常开展数据分析的过程中,我们经常需要对 ...
- Python数据科学手册-Pandas:数值运算方法
Numpy 的基本能力之一是快速对每个元素进行运算 Pandas 继承了Numpy的功能,也实现了一些高效技巧. 对于1元运算,(函数,三角函数)保留索引和列标签 对于2元运算,(加法,乘法),Pan ...
- pandas学习(常用数学统计方法总结、读取或保存数据、缺省值和异常值处理)
pandas学习(常用数学统计方法总结.读取或保存数据.缺省值和异常值处理) 目录 常用数学统计方法总结 读取或保存数据 缺省值和异常值处理 常用数学统计方法总结 count 计算非NA值的数量 de ...
- (数据科学学习手札69)详解pandas中的map、apply、applymap、groupby、agg
*从本篇开始所有文章的数据和代码都已上传至我的github仓库:https://github.com/CNFeffery/DataScienceStudyNotes 一.简介 pandas提供了很多方 ...
- Python 数据科学系列 の Numpy、Series 和 DataFrame介绍
本課主題 Numpy 的介绍和操作实战 Series 的介绍和操作实战 DataFrame 的介绍和操作实战 Numpy 的介绍和操作实战 numpy 是 Python 在数据计算领域里很常用的模块 ...
- python pandas ---Series,DataFrame 创建方法,操作运算操作(赋值,sort,get,del,pop,insert,+,-,*,/)
pandas 是基于 Numpy 构建的含有更高级数据结构和工具的数据分析包 pandas 也是围绕着 Series 和 DataFrame 两个核心数据结构展开的, 导入如下: from panda ...
- (数据科学学习手札07)R在数据框操作上方法的总结(初级篇)
上篇我们了解了Python中pandas内封装的关于数据框的常用操作方法,而作为专为数据科学而生的一门语言,R在数据框的操作上则更为丰富精彩,本篇就R处理数据框的常用方法进行总结: 1.数据框的生成 ...
- pandas中Series对象下的str所拥有的方法(df["xx"].str)
在使用pandas的时候,经常要对DataFrame的某一列进行操作,一般都会使用df["xx"].str下的方法,但是都有哪些方法呢?我们下面来罗列并演示一下.既然是df[&qu ...
随机推荐
- JumpGame,JumpGame2
JumpGame:给定一个非负整数数组,开始在第一个位置,每个位置上的数字代表最大可以跳跃的步数,判断能不能跳到最后一个位置. 例如:A=[2,3,1,1,4],在位置0处,可以跳一步到位置1,位置1 ...
- numpy数组各种乘法
In [34]: a Out[34]: array([[1, 4], [5, 6]]) In [35]: b Out[35]: array([[4, 1], [2, 2]]) In [36]: np. ...
- Pandas稀疏数据
当任何匹配特定值的数据(NaN/缺失值,尽管可以选择任何值)被省略时,稀疏对象被“压缩”. 一个特殊的SparseIndex对象跟踪数据被“稀疏”的地方. 这将在一个例子中更有意义. 所有的标准Pan ...
- Angularjs注入拦截器实现Loading效果
angularjs作为一个全ajax的框架,对于请求,如果页面上不做任何操作的话,在结果烦回来之前,页面是没有任何响应的,不像普通的HTTP请求,会有进度条之类. 什么是拦截器? $httpProvi ...
- flask学习(二):认识web
url详解: URL是Uniform Resource Locator 的简写,统一资源定位符 一个URL由以下及几部分组成: scheme://host:port/path/?query-strin ...
- mysql数据库(一):建表与新增数据
一. 学习目标 理解什么是数据库,什么是表 怎样创建数据库和表(create) 怎样往表里插入数据(insert) 怎样修改表里的数据(update) 怎样删除数据库,表以及数据(delete) 二. ...
- 通过使用scrapy爬取某学校全网
通过遍历全网url 实现爬取全网内容 忽略“.doc"等文件网页暂不处理,只爬取整个页面,不做清洗 spider.py # -*- coding: utf-8 -*- import scra ...
- Easyui 行编辑
之前没用过,突然用了的时候手忙脚乱的感觉 找了官方文档也好 百度了一大堆东西 表示个人脑袋跟不上思路 直接铺上简化的 以后自己 找起来也方便 以下代码已经执行 应该不会再错了 <tab ...
- LeetCode OJ:Simplify Path(简化路径)
Given an absolute path for a file (Unix-style), simplify it. For example,path = "/home/", ...
- L130
Trump Administration Backs Asian-Americans in Harvard CaseThe United States Justice Department on Th ...