
python爬虫1
1 网页结构
html:超文本标记语言------->类似人的鼻子耳朵,长在那里,大体骨架就是那个样子
css:层叠样式表------->这个是外观的深化,比如贴个双眼皮,橙色眼睛。。。
js:动态脚本语言----->人的技能,跳舞rap
学习网站:w3cshool
2 requests使用
(1)开发环境使用pycharm
(2)爬虫基本原理
request---->向服务器发送访问的请求
responce---->服务器收到用户请求以后,会验证请求的有效性然后向用户发送响应的内容。客户端收到响应并显示出来。
(3)get post请求方式
get:
post:
使用有道翻译网页作为案例,http://fanyi.youdao.com/,按F12进入开发者模式,单击network,此时为空。
在输入框中输入"中国你好"单击翻译
单击network---->XHR找到翻译数据
查看请求方式为post,并可以加那个headers中的URL复制出来,因为post需要自己构建请求头
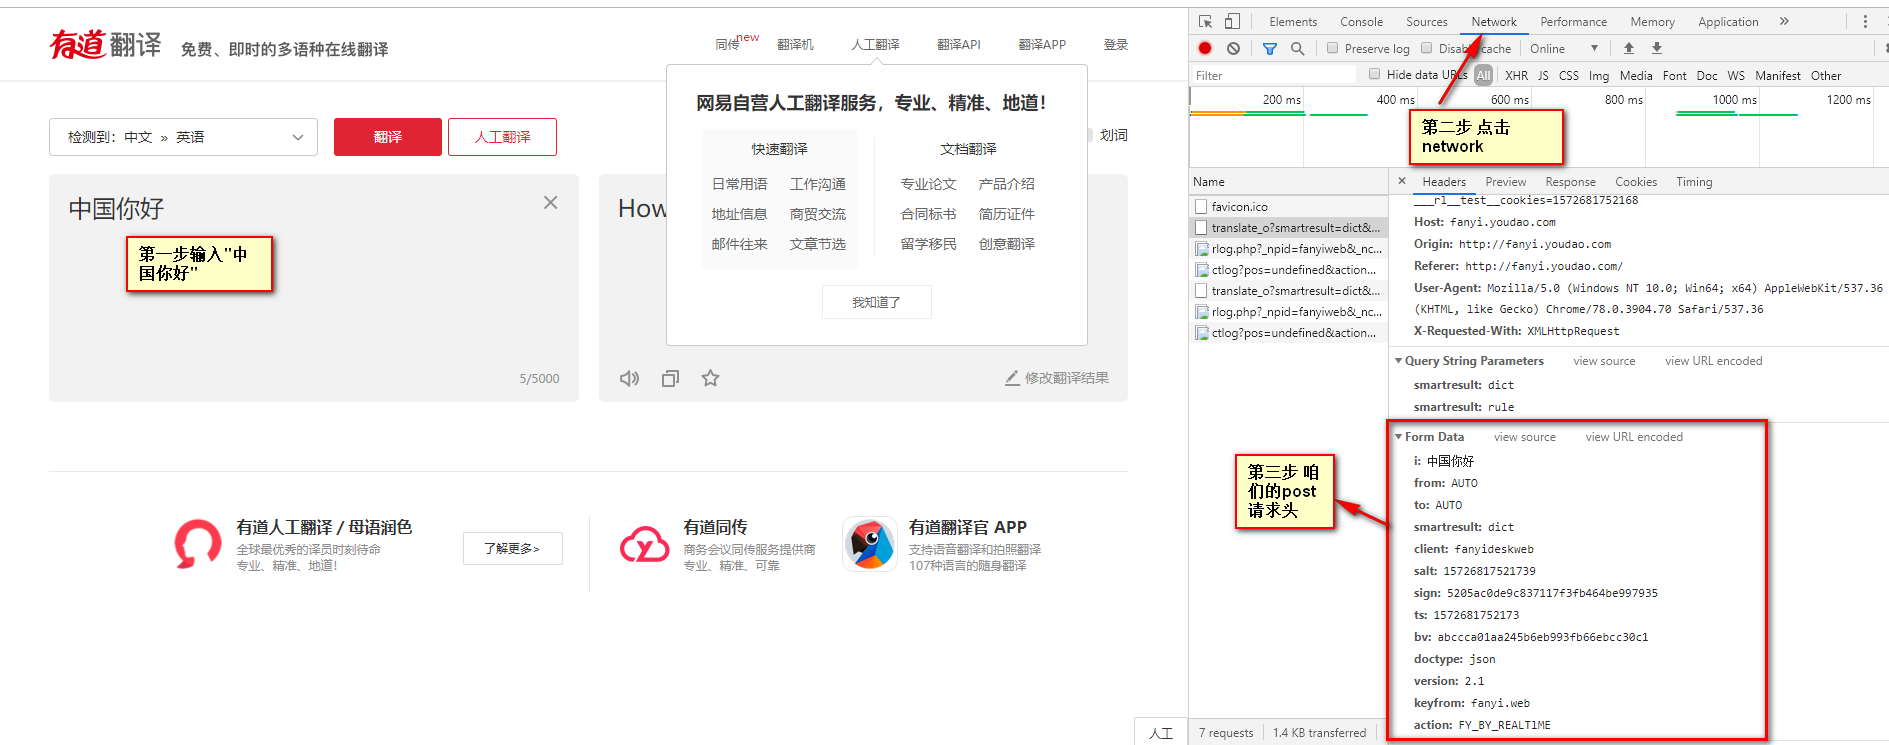
使用request.post抓取有道翻译的结果
 import requests

 import json

 def get_translate_date(word=None):

     url='http://fanyi.youdao.com/translate?smartresult=dict&smartresult=rule'

     Form_data = {'i':word, 'from':'AUTO','to': 'AUTO','smartresult': 'dict', 'client':'fanyideskweb',

                     'salt':'','sign':'78181ebbdcb38de9b4a3f4cd1d38816b','doctype':'json',

                     'version': '2.1','keyfrom':'fanyi.web','action':'FY_BY_CLICKBUTTION','typoResult':'false'}

     response = requests.post(url, data=Form_data)                # 请求表单数据

     content = json.loads(response.text)   # 将JSON格式字符串转字典

     print(content)

     print(content['translateResult'][0][0]['tgt'])             # 打印翻译后的数据

 if __name__ == '__main__':

     get_translate_date('中国你好')
3 使用beautiful soup解析网页
通过requests可以抓取网页源码并解析提取数据,beautiful soup被移植到bs4库中,也就是安装它需要先安装bs4.官方中文文档https://beautifulsoup.readthedocs.io/zh_CN/v4.4.0/
(1)打开网页
(2)筛选路径soup.select()
随便选择一句话----->右击检查(右侧弹出开发者界面)----->右击左边高亮数据------>选择copy----->选择copy selector
(3)引入re库
https://docs.python.org/zh-cn/3/library/re.html re中文官网
(4)最终代码
 import  requests

 from bs4 import BeautifulSoup

 import re

 url="http://www.cntour.cn/"

 strhtml=requests.get(url)

 soup=BeautifulSoup(strhtml.text,'lxml')# 通过lxml解析后转换为树形结构,每个节点都是对象

 data=soup.select("#main > div > div.mtop.firstMod.clearfix > div.centerBox > ul.newsList > li > a")

 print(data)

 for item in data:

     result={

         'title':item.get_text(),#连接在<a>标签中用get_text

         'link':item.get('href'),#在<a>href属性用get

         'ID':re.findall('\d+',item.get('href'))#\d表示匹配数字 +表示匹配前一个字符1次或者多次

     }

     print(result)
(5)最后结果
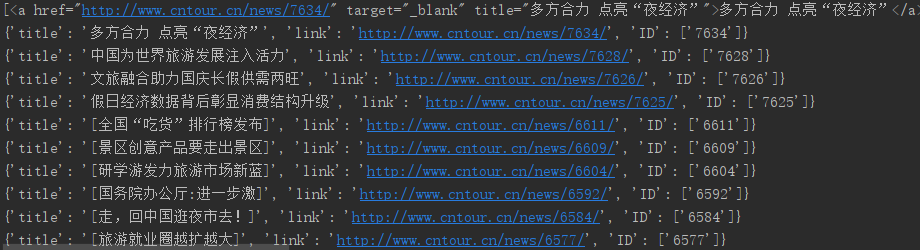
完事!
python爬虫1的更多相关文章
- Python 爬虫模拟登陆知乎
在之前写过一篇使用python爬虫爬取电影天堂资源的博客,重点是如何解析页面和提高爬虫的效率.由于电影天堂上的资源获取权限是所有人都一样的,所以不需要进行登录验证操作,写完那篇文章后又花了些时间研究了 ...
- python爬虫成长之路(一):抓取证券之星的股票数据
获取数据是数据分析中必不可少的一部分,而网络爬虫是是获取数据的一个重要渠道之一.鉴于此,我拾起了Python这把利器,开启了网络爬虫之路. 本篇使用的版本为python3.5,意在抓取证券之星上当天所 ...
- python爬虫学习(7) —— 爬取你的AC代码
上一篇文章中,我们介绍了python爬虫利器--requests,并且拿HDU做了小测试. 这篇文章,我们来爬取一下自己AC的代码. 1 确定ac代码对应的页面 如下图所示,我们一般情况可以通过该顺序 ...
- python爬虫学习(6) —— 神器 Requests
Requests 是使用 Apache2 Licensed 许可证的 HTTP 库.用 Python 编写,真正的为人类着想. Python 标准库中的 urllib2 模块提供了你所需要的大多数 H ...
- 批量下载小说网站上的小说(python爬虫)
随便说点什么 因为在学python,所有自然而然的就掉进了爬虫这个坑里,好吧,主要是因为我觉得爬虫比较酷,才入坑的. 想想看,你可以批量自动的采集互联网上海量的资料数据,是多么令人激动啊! 所以我就被 ...
- python 爬虫(二)
python 爬虫 Advanced HTML Parsing 1. 通过属性查找标签:基本上在每一个网站上都有stylesheets,针对于不同的标签会有不同的css类于之向对应在我们看到的标签可能 ...
- Python 爬虫1——爬虫简述
Python除了可以用来开发Python Web之后,其实还可以用来编写一些爬虫小工具,可能还有人不知道什么是爬虫的. 一.爬虫的定义: 爬虫——网络爬虫(又被称为网页蜘蛛,网络机器人,在FOAF社区 ...
- Python爬虫入门一之综述
大家好哈,最近博主在学习Python,学习期间也遇到一些问题,获得了一些经验,在此将自己的学习系统地整理下来,如果大家有兴趣学习爬虫的话,可以将这些文章作为参考,也欢迎大家一共分享学习经验. Pyth ...
- [python]爬虫学习(一)
要学习Python爬虫,我们要学习的共有以下几点(python2): Python基础知识 Python中urllib和urllib2库的用法 Python正则表达式 Python爬虫框架Scrapy ...
- python爬虫学习(1) —— 从urllib说起
0. 前言 如果你从来没有接触过爬虫,刚开始的时候可能会有些许吃力 因为我不会从头到尾把所有知识点都说一遍,很多文章主要是记录我自己写的一些爬虫 所以建议先学习一下cuiqingcai大神的 Pyth ...
随机推荐
- springboot+mybatisplus进行整合并且使用逆向工程
首先引入maven依赖:这是整合mybatisplus时,进行逆向工程时候需要引入的依赖 <!--mybaitsplus start--> <dependency> <g ...
- 解决PHP处理图片时内存占用过高问题
用过GD库的同学可能都知道,使用imagecreatetruecolor()函数创建一个真彩色的画布是第一步.但是,如果画布的宽高超过平常的宽高,会带来极大的内存消耗.比如,一个9600×4800的画 ...
- AVL树的旋转
平衡二叉树在进行插入操作的时候可能出现不平衡的情况,AVL树即是一种自平衡的二叉树,它通过旋转不平衡的节点来使二叉树重新保持平衡,并且查找.插入和删除操作在平均和最坏情况下时间复杂度都是O(log n ...
- windows串口编程Win32,PComm串口开发
https://blog.csdn.net/u011430225/article/details/51496456 https://blog.csdn.net/eit520/article/detai ...
- circus && web comsole docker-compose 独立部署web console 的一个bug
如果直接使用以下的docker-compose 文件部署会有通过多播通信获取endpoint 异常的问题(circus 在stats endpoint 获取少了一个c) 这个问题是部分网络情况下会出现 ...
- urql 高度可自定义&&多功能的react graphql client
urql 是一个很不错的graphql client,使用简单,功能强大,通过exchanges 实现了完整的自定义特性 通过urql 的exchanges 我们可以实现灵活的cache策略 参考资料 ...
- 如何在Unity中开发Leap Motion桌面版(Non-VR)APP
最近因需要,翻出几年前的Leapmotion感测器,准备用Unity3D做个互动APP,于是连上官网下载SDK.等下载下来一安装调试,瞬间傻眼,居然要求VR设备.我们Lab倒是不缺VR,有几套VIVE ...
- 【luoguP2997】[USACO10NOV]旗帜Banner
题目链接 长和宽的gcd(x,y)=1,就没有中间结点,一种线段有两种方向,暴力统计一下就好了 注意x=0或y=0时的线段只有一种方向 #include<iostream> #includ ...
- mysql count() 函数,对结果统计计数
mysql> ; +----------+------------+-----+---------------------+ | name_new | transactor | pid | or ...
- [USACO5.1]二维凸包模板
传送门 Description 求\(n\)个点凸包的周长 Solution 计算几何打暴力必备 Code #include<bits/stdc++.h> #define reg re ...