
GhostVLAD for set-based face recognition
GhostVLAD for set-based face recognition 中提到了文章解决的是template-based face recognition。
VLAD: vector of locally aggregated descriptors. 由Jegou et al.在2010年提出,其核心思想是aggregated(积聚),主要应用于图像检索领域。
文章的3个贡献:
- 提出一种网络来聚合并embed网络输出的面部特征向量至一个compact的固定长度的表示。
- 提出一个新奇的GhostVLAD层,其中包含ghost clusters,不对聚合做贡献。文中展示了一种高质量的自动加权方式来使得高质量的图像比低质量的图像贡献更多。并且这个ghost clusters可以提高网络能力来解决比较差质量的图像。
- 文中探索了特征维度,簇的数目,不同训练技术对识别性能的影响。最后作者在IJB-B数据集上远超sota的identification和cerification指标。
那么这种set(template) based face recognition的难处何在?在于集合里的人脸可能有不同的姿态,表情,光照,甚至质量的差异也很大。如果我给low-quality和high-quality一样的weight,那肯定会hurt performance。所以网络应该更关注于informative ones。
比较set之间的相似性一个直接的做法就是我将每个subject的所有人脸特征都存储起来,然后比较两个subject的每一对图像,这么做是非常耗存储和时间。因此聚合方法能够产生compact template representation。更重要的是,从image set获取的representation应当更加具有判别性。同一subject的template descriptors应当互相close,反之则far apart。尽管一些工作利用average pooling和max pooling可以聚合到一个比较compact的template representation,本文寻找一种更好的方案。本文灵感来源于图像检索中的编码方法:Fisher Vector encoding和T-embedding 增加从related和unrelated图像块提取到的描述子的可分性。于是作者也在利用了一种相似的encoding:NetVLAD来设计网络。作者拓展NetVLAD结构to include ghost clusters。将这些低质量人脸视为ghost clusters。尽管没有明确对template里的faces进行加权,这种特性自动会出现。即低质量人脸会contribute less。网络以端到端的方式训练,仅用identity-level labels。在IJB-A,IJB-B上面都有很大提升。
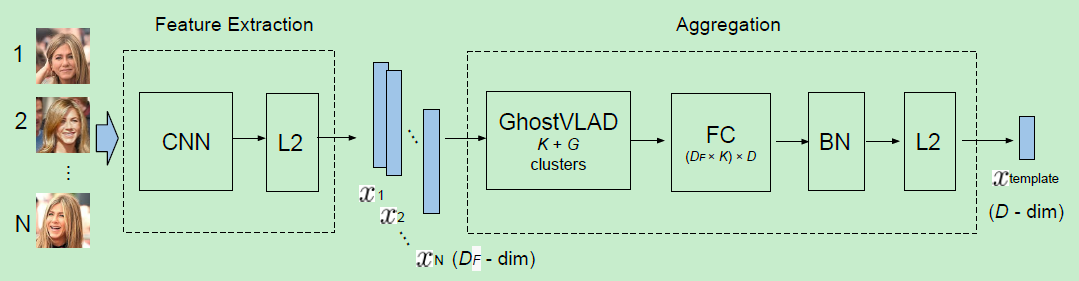
大致结构如上图:对一个template中的每个图片提取特征,然后利用GhostVLAD层来聚合这些descriptors到单一固定长度的vectors。最后的D维template描述子由FC层来削减维度,并附有BN和L2正则。
这个网络应该有如下性质:
- 输入任意数量图像,输出固定长度的template descriptor来表征输入的image set
- 输出的template descriptor应当是compact的,或低维,使得存储较小便于更快的template comparisions。
- 输出的template descriptor应当是discriminative的,使得同一subject的templates之间的相似性大于与其他不同subjects之间的相似性。(内聚性)
上面三条性质的实现方案分别如下:
- 利用一个修改后的NetVLAD层:GhostVLAD来聚合人脸描述子
- 通过一个trained layer实现维度缩减
- 因为整个网络end-to-end被训练,并且因为GhostVLAD层能够down-weight低质量图像的contribution,所以可以实现discriminative
本文的核心部件:GhostVLAD:NetVLAD with ghost clusters
这是个可训练的aggregation layer。给定N个DF维的面部向量,计算一个单一的DF乘K维的输出。它基于NetVLAD层实现了一个编码过程,类似于VLAD encoding。所以是可微可训练的。这个NetVLAD已被证实比average和max pooling的效果要好。这里简要回顾一下论文NetVLAD(NetVLAD: CNN architecture for weakly supervised place recognition)。
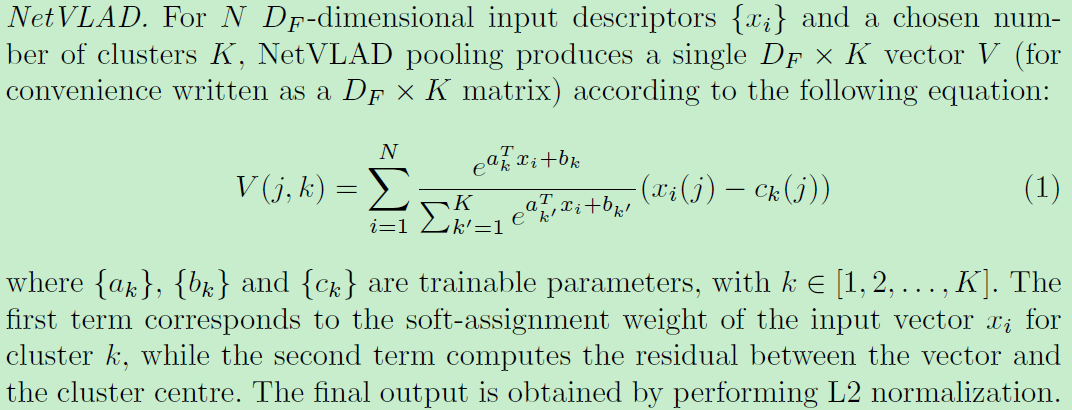
作者拓展NetVLAD with "ghost" clusters为GhostVLAD。即作者在原有的K个类簇中额外的加了G个“ghost”类簇来形成soft assignments。

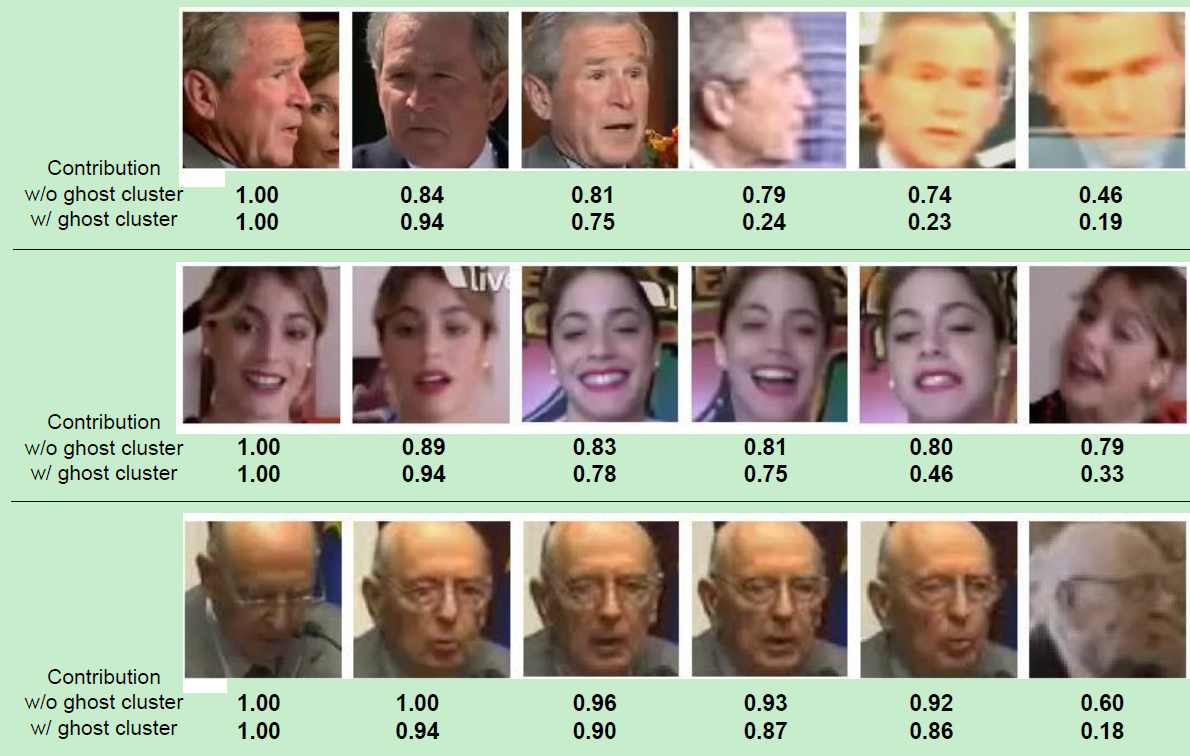
使用ghost clusters的一个直觉就是使得网络更容易调整template中的每个face example。这通过assigning examples to be ignored to the ghost clusters来实现的。例如对于一个highly blurry的人脸图像,将会被很大程度上assigned to a ghost cluster,使得它在non-ghost的clusters的权重就会趋近于0。那这样就使得它对于template representation的贡献是可忽略不计的。
一些训练细节:
为了perform set-based training,重复在线采样属于同一identity的固定数目的图像。
测试细节:
对于IJB-A和IJB-B做“1:1 face verification”和“1:N face identification”。
- 1:1 face verification的目的是决定两个templates是否属于同一人。通过设定templates之间的相似性阈值实现。验证性能由ROC曲线评估,也就是验证true accept rates(TAR)和false accept rates(FAR)的trade off。
- 1:N identification的做法是对于probe set的templates,要对给定的gallery中所有templates做评价。模型的评价方法有:true positive identification rate(TPIR)和false positive identification rate(FPIR)以及Rank-N。
结果:明显对低质量图像降低了权重。
论文:A Good Practice Towards Top Performance of Face Recognition: Transferred Deep Feature Fusion
A template refers to a collection of all media (images and/or video frames) of an interested face captured under different conditions that can be utilized as a combined single
representation for matching task.
GhostVLAD for set-based face recognition的更多相关文章
- Improved RGB-D-T based Face Recognition 论文笔记
本文将基于深度学习的卷积神经网络(CNN)应用于基于RGB-D-T的多模态人脸识别问题. 此外,引入了基于CNN的识别模块与各种纹理特征(LBP,HOG,HAAR,HOGOM)的后期融合,在基准RGB ...
- Activity Recognition行为识别
暑假听了computer vision的一个Summer School,里面Jason J. Corso讲了他们运用Low-Mid-High层次结构进行Video Understanding 和 Ac ...
- Recent papers on Action Recognition | 行为识别最新论文
CVPR2019 1.An Attention Enhanced Graph Convolutional LSTM Network for Skeleton-Based Action Recognit ...
- {ICIP2014}{收录论文列表}
This article come from HEREARS-L1: Learning Tuesday 10:30–12:30; Oral Session; Room: Leonard de Vinc ...
- 深入浅出QOS详解(转)
QOS学习笔记 (工作时间之余,总结了这些,累的食指快脱节了,现在还在恢复中,为的就是让文章质量再提高点,希望对大家有帮助!文章太长,为方便,我附件上文章原文.) QOS,服务质量.顾名思义,就是为了 ...
- (zhuan) Speech and Natural Language Processing
Speech and Natural Language Processing obtain from this link: https://github.com/edobashira/speech-l ...
- "Regressing Robust and Discriminative 3D Morphable Models with a very Deep Neural Network" 解读
简介:这是一篇17年的CVPR,作者提出使用现有的人脸识别深度神经网络Resnet101来得到一个具有鲁棒性的人脸模型. 原文链接:https://www.researchgate.net/publi ...
- ECCV 2014 Results (16 Jun, 2014) 结果已出
Accepted Papers Title Primary Subject Area ID 3D computer vision 93 UPnP: An optimal O(n) soluti ...
- CVPR 2017 Paper list
CVPR2017 paper list Machine Learning 1 Spotlight 1-1A Exclusivity-Consistency Regularized Multi-View ...
随机推荐
- 项目Beta冲刺(团队)——05.25(3/7)
项目Beta冲刺(团队)--05.25(3/7) 格式描述 课程名称:软件工程1916|W(福州大学) 作业要求:项目Beta冲刺(团队) 团队名称:为了交项目干杯 作业目标:记录Beta敏捷冲刺第3 ...
- ajax jsonp函数调用
jsonp数据 jsonpHandler({name:"liujinyu",age:"24"}) ajax调用 $.ajax({ type:'GET', ...
- HTTP权威指南 目录
diyi部分 HTTP:Web的基础 第1章 HTTP概述 31.1 HTTP——因特网的多媒体信使 41.2 Web客户端和服务器 41.3 资源 51.3.1 媒体类型 61.3.2 URI 71 ...
- (13)使用python+flask实现树莓派的WEB控制
https://blog.csdn.net/qq_34803821/article/details/86240096 如果你想在网页上点击按钮,并且让树莓派接收到响应,并做响应的处理,实现网页上与树莓 ...
- (4)给树莓派安装中文输入法Fcitx及Google拼音输入法
sudo apt-get install fcitx fcitx-googlepinyin fcitx-module-cloudpinyin fcitx-sunpinyin 安装完毕,重启即可.
- spark学习收集
spark优化: http://www.cnblogs.com/hark0623/p/5533803.html 董西成学生写的经验分享(很详细很强大) spark官网 API http://spark ...
- UFUN 函数 UF_DISP (UF_DISP_create_image ) (如何把显示部件部分截图放到指定的文件夹中)
//此函数功能是输入工作部件的tag,返回工作部件的路径 static string path_name(tag_t path_tag) { ]=""; //得到工作部件的路径 U ...
- luogu_3645: 雅加达的摩天楼
雅加达的摩天楼 题意描述: 有\(N\)座摩天楼,从左到右依次编号为\(0\)到\(N-1\). 有\(M\)个信息传递员,编号依次为\(0\)到\(M-1\).编号为i的传递员最初在编号为\(B_i ...
- SDOI 2014 向量集
[SDOI2014]向量集 题目描述 维护一个向量集合,在线支持以下操作: - "A x y (|x|,|y| < =10^8)":加入向量(x,y); - " Q ...
- [Beta阶段]发布说明
小小易校园微信小程序发布说明 第二版小小易校园小程序发布啦~ 打开微信,点击右上角➕,选择扫一扫,扫描以下二维码即可进入小程序: 版本功能: 上一版功能请参见[Alpha阶段]发布说明. 当前版本的更 ...