
python scrapy版 极客学院爬虫V2
python scrapy版 极客学院爬虫V2
1 基本技术 使用scrapy
2 这个爬虫的难点是 Request中的headers和cookies 尝试过好多次才成功(模拟登录),否则只能抓免费课程
3文件树如下
│ jike.json 存储json文件
│ run.py 运行爬虫
└─jkscrapy
│ items.py 设置字段
│ pipelines.py 处理字段
│ settings.py 基本设置
│ init.py
└─spiders
jkspiders.py 爬虫
jkspiders.pyc
init.py
coding:utf-8
from jkscrapy.items import JkscrapyItem
from scrapy.http import Request
import re
from scrapy.spiders import BaseSpider
from scrapy.selector import Selector
from jkscrapy.settings import *
import sys
reload(sys)
sys.setdefaultencoding("utf-8")
爬虫
class jikespider(BaseSpider):
name = "jike"
baseurl = "http://www.jikexueyuan.com/course/"
starturls = ["http://www.jikexueyuan.com/"]
allowed_domains = ["www.jikexueyuan.com", "search.jikexueyuan.com", "jikexueyuan.com"]
def __init(self):
self.headers = headers
self.cookies = cookies
pass
爬虫 重写 BaseSpider parse
-1、在首页中获取标签及课程对应的地址
-2、eghttp://www.jikexueyuan.com/course/python/
def parse(self, response):
s_total = Selector(text=response.body).xpath(
'//*[@id="pager"]/div[1]/div[1]/ul/li/div/div/div/dl/dd/a/@href').extract()
if len(s_total) > 0:
for page in s_total:
yield Request(page, callback=self.get_course_pages,headers=self.headers,cookies=self.cookies)
else:
pass
爬虫 get_course_pages 获取课程连接
-1、scrapy Selector xpath 获取课程地址
-2、eg http://www.jikexueyuan.com/course/1860.html
def get_course_pages(self, response):
x_couses = Selector(text=response.body).xpath('//*[@id="changeid"]/ul/li/div[1]/a')
for x in x_couses:
try:
href = x.select('@href').extract()[0]
title = x.select('img/@title').extract()[0]
yield Request(href, callback=self.get_course_detail,headers=self.headers,cookies=self.cookies)
except:
pass
爬虫 get_course_detail获取课程
-1、scrapy Selector xpath 获取课程地址
-2、eg http://www.jikexueyuan.com/course/271_3.html?ss=1
def get_course_detail(self, response):
d_couses = Selector(text=response.body).xpath('//*[@id="pager"]/div[3]/div[2]/div[2]/ul/li/div/h2/a')
for d in d_couses:
try:
href = d.select('@href').extract()[0]
print(href)
title = d.select('text()').extract()[0]
# print(" %s %s" % (href, title))meta ={}meta["href"]= hrefmeta["title"]= titleyieldRequest(href, callback=self.get_down_urls, meta={"meta": meta},headers=self.headers,cookies=self.cookies)except:pass
爬虫 get_down_urls获取课程下地址
-1、正则 获取课程下载地址,这个是调用flash播放地址 尝试过很多方法 最后发现正则可以
-2、eg http://cv3.jikexueyuan.com/201509071527/df51514a02286dac0b30245eaa4dd166/html5/course_mob/01/video/c271b_03_h264_sd_960_540.mp4
def get_down_urls(self, response):
meta = response.meta["meta"]
course_down = re.findall(r'source src="(.*?)"', response.body, re.S)
item = JkscrapyItem()
if course_down:
item["course_id"] = meta["href"]
item["course_name"] = meta["title"]
item["course_path"] = course_down[0]
yield item
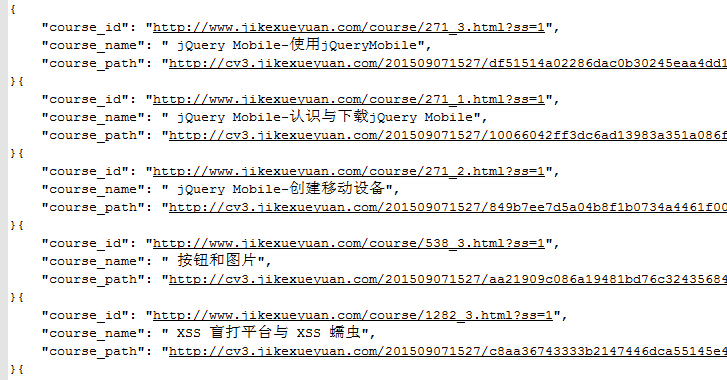
爬虫为了测试简要的存储为json 结果只存储了几个字段,可以根据需要进行调整共爬取了4500多条
python scrapy版 极客学院爬虫V2的更多相关文章
- python极客学院爬虫V1
定向爬取极客学院视频,原本只有年费VIP只能下载,经过分析,只要找个免费体验VIP即可爬取所有视频 涉及的基本技术:python xpath 正则 com+ 通过python调用迅雷从组件,实现自动创 ...
- 基于requests实现极客学院课程爬虫
背景 本文主要是为了完成极客学院课程<Python 单线程爬虫>中讲师布置的实战作业. 开发环境 操作系统:windows 10 Python :Python 2.7 IDE:PyChar ...
- scrapy爬取极客学院全部课程
# -*- coding: utf-8 -*- # scrapy爬取极客学院全部课程 import scrapy from pyquery import PyQuery as pq from jike ...
- maven介绍 极客学院
来自极客学院 Apache Maven 是一套软件工程管理和整合工具.基于工程对象模型(POM)的概念,通过一个中央信息管理模块,Maven 能够管理项目的构建.报告和文档. Maven - 概述 M ...
- 【极客学院出品】Cocos2d-X系列课程之九-BOX2D物理引擎
Cocos2d-x 是时下最热门的手游引擎,在国内和国外手机游戏开发使用的份额各自是70%和25%,在App Store的top10中,有7个是用它开发的. 本节课程为Cocos2d-x系列课程之九, ...
- 【极客学院-idea教程】
极客学院idea教程: http://whudoc.qiniudn.com/2016/IntelliJ-IDEA-Tutorial/index.html
- 极客学院年VIP卡原价260的F码,200出售
F码是中国最大的IT职业在线教育平台——极客学院推出的VIP时间兑换码,凭此可在极客学院官网兑换年VIP,畅享平台上所有IT技术课程. 购买请点击 http://www.bejson.com/othe ...
- 极客学院免费VIP
[手快福利]用我的链接注册极客学院,你我都能免费得30天VIP!6500+编程开发视频教程随便学,还能下载资料和源码 http://e.jikexueyuan.com/invite/index.htm ...
- Ubuntu linux下部署golang配置环境,极客学院 无闻讲的安装配置是错的,折腾我好几遍,真是有点坑
开始按极客学院无闻讲的做,弄了几遍都不行,最后发现是错的,别人告诉我这是mac下的virtualbox是这样的,不管怎样,被坑的不浅. 虽然sudo apt install golang-go 就能安 ...
随机推荐
- Yii2初谈
Yii2发布有两个月时间了,一直没有去仔细关注过. 今天在回顾PSR标准时,稍稍扫了一眼Yii2.它的命名风格还是一如既往的与Zend那种既首字母大写又还要下划线连接的很二的命名风格格格不入.其实我看 ...
- static关键字详解
首先,要了解一下这些东西的存放位置 堆区: 1.存储的全部是对象,每个对象都包含一个与之对应的class的信息.(class的目的是得到操作指令) 2.jvm只有一个堆区(heap)被所有线程共享,堆 ...
- jinfo命令的使用
jinfo命令 该命令可以打印出java进程的配置信息:包括jvm参数,系统属性等用法: jinfo [ option ] pid jinfo [ option ] executable core j ...
- c#事务用法
ado.net2.0的SqlTransaction使用方法 /////ado.net1.0中使用Transacation(事务) string connectionString = "dat ...
- 改写百度云推送SDK,PHP PEAR 包:Services_Baidu_Push
iPhone使用apple push很方便,而Android很多厂商删除了google push,而且google在大陆连不上,所以要用别的办法. Android常见的推送服务商有:极光推送(http ...
- T3 - 构建大型 Web 应用的 JavaScript 框架
T3 是一个用于构建大型 Web 应用程序的客户端 JavaScript 框架.T3 和大多数的 JavaScript 框架不同.它的意思是一小部分的整体架构,它允许你建立可扩展的客户端代码.T3 应 ...
- 赞!jsPDF – 基于 HTML5 的强大 PDF 生成工具
jsPDF 是一个基于 HTML5 的客户端解决方案,用于生成各种用途的 PDF 文档.使用方法很简单,只要引入 jsPDF 库,然后调用内置的方法就可以了.浏览器兼容性: IE 10, Firefo ...
- C#添加dll引用后,添加命名空间出错的解决方案
原因:类库dll的目标框架与项目的目标框架不一致造成的,右键单击项目project--〉属性 ---〉Application选项卡下有“目标框架”Target Framewiork, 遇到的是类库的 ...
- Basic Virus's Infection & Variation [Python]
Learn from here Initial #!/usr/bin/python2.7 #MAGIC_STRING_skd83749872 import os import __main__ imp ...
- ORA-03113解决方法
场景: 碰到ORA-00257归档日志写满的解决方法这篇日志当中描述的归档日志写满的情况. 此时我想将数据库切换到非归档模式,参考如何启动或关闭oracle的归档(ARCHIVELOG)模式进行操作, ...