
探索HashMap源码 一行一行解析 jdk1.7版本
今天我们来说一说,HashMap的源码到底是个什么?
面试大厂这方面一定会经常问到,很重要的。以jdk1.7 为标准 先带着大家过一遍
是由数组、链表组成 ,
数组的优点是:每个元素有对应下标,从 0开始,相互对应的值 所以它查询快,增删慢
链表的优点是:一个一个元素相互指向, 所以它查询慢,增删快,为什么快呢 举例如果删除,就会直接根据指向找到对应元素修改一下对应指向,并对元素进行回收。
jdk1.8时出现了红黑树的概念
红黑树:参考博客:http://www.cnblogs.com/skywang12345/p/3245399.html
导读!!! 请先过一遍眼熟
先来了解一下什么是HashCode(哈希码)
哈希算法将任意长度的二进制值映射为固定长度的较小二进制值,这个小的二进制值称为哈希值。哈希值是一段数据唯一且极其紧凑的数值表示形式。如果散列一段明文而且哪怕只更改该段落的一个字母,随后的哈希都将产生不同的值。要找到散列为同一个值的两个不同的输入,在计算上是不可能的。
hashcode返回的数值可以做一个比较器一般情况下如果hashCode相同则equals应该也判定相等就像MD5一样可以理解成某块具体的地址有一一对应的映射关系
· HashMap 存储值是根据你所传入的 对应键的哈希码经过比较判断 而确定了键应该所在的位置。 有时候计算出来的哈希码会出现哈希冲突,为了解决这个问题,在jdk1.8中开发者在你对应哈希值一致的键上 设置了链表对应指向,而转换成链表之后 ,设置在最快查询时间内可查询8个元素,但是在对应指向到第9个元素之后会在底层直接转换为红黑树结构, 红黑树有自动变色及排序功能,保证查询时,时间不会很长。时间和空间的概念下文有说明。
HashMap 是Map的实现类,进入源码后,来看源码上面的注释
jdk1.7HashMap源码上的注释(下附翻译)
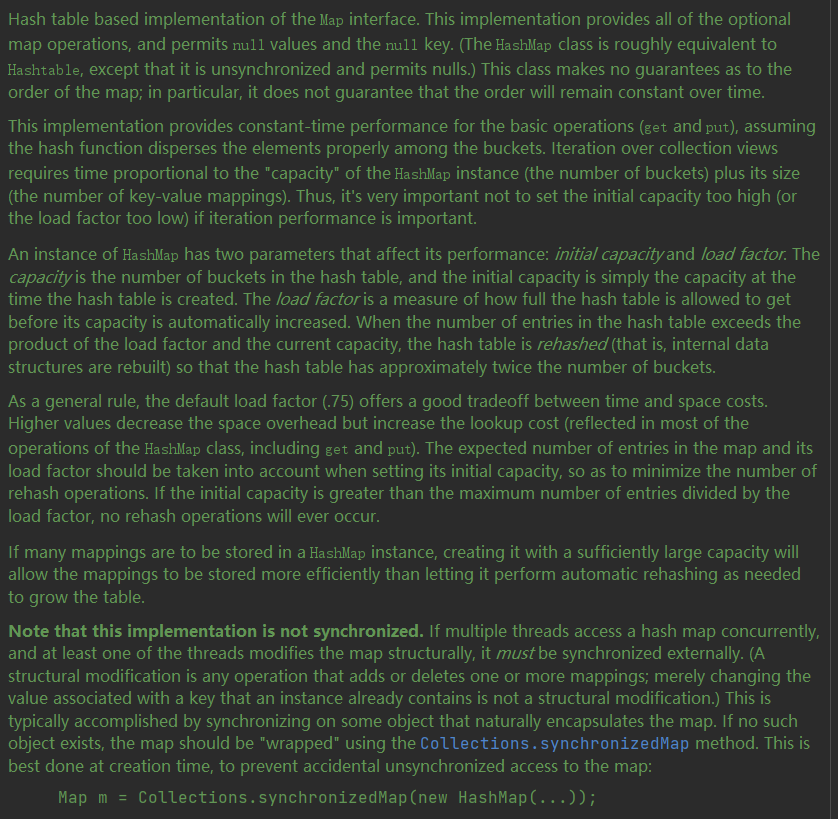
在这里我帮大家翻译了一下。帮助大家理解
基于哈希表实现的Map接口。这个实现提供了所有可选的map操作,并允许空值和空键。(HashMap类大致相当于Hashtable,除了它是非同步的,并且允许为空。)这个类不保证映射的顺序;特别是,它不能保证顺序随时间保持不变。
这个实现为基本操作(get和put)提供了固定时间的性能,假设散列函数将元素适当地分散在桶中。遍历集合视图所需的时间与HashMap实例的“容量”(桶的数量)加上它的大小(键值映射的数量)成比例。因此,如果迭代性能很重要,那么不要将初始容量设置得过高(或负载因子设置得过低)是非常重要的。
HashMap实例有两个影响其性能的参数:初始容量和负载因子。容量是哈希表中的桶数,初始容量就是创建哈希表时的容量。负载因子是衡量散列表容量自动增加之前允许其达到的满度。当哈希表中的条目数量超过负载因子和当前容量的乘积时,将对哈希表进行重新哈希(即重建内部数据结构),以便哈希表的桶数量大约是当前的两倍。
作为一般规则,默认负载系数(.75)提供了时间和空间成本之间的良好权衡。较高的值会减少空间开销,但会增加查找成本(反映在HashMap类的大多数操作中,包括get和put)。在设置映射的初始容量时,应该考虑映射中预期的条目数量及其负载因子,以减少重新散列操作的数量。如果初始容量大于最大条目数除以负载因子,则不会发生重新散列操作。
如果要在一个HashMap实例中存储许多映射,那么创建一个容量足够大的HashMap实例将使映射的存储更加有效,而不是让它根据需要执行自动重新散列以增加表。
注意,这个实现不是同步的。如果多个线程并发地访问一个散列映射,并且至少有一个线程在结构上修改了该映射,则必须从外部同步该映射。(结构修改是任何添加或删除一个或多个映射的操作;仅仅更改与实例中已经包含的键相关联的值不是结构修改。)这通常是通过对某个自然封装了映射的对象进行同步来实现的。如果不存在这样的对象,则应该使用集合“包装”映射。synchronizedMap方法。这最好在创建时完成,以防止意外的非同步访问映射:
Map m =集合。synchronizedMap(新HashMap(…));
这个类的所有“集合视图方法”返回的迭代器都是快速失败的:如果在迭代器创建之后的任何时候映射被结构上修改,除了通过迭代器自己的remove方法,迭代器将抛出ConcurrentModificationException。因此,在面对并发修改时,迭代器会快速而清晰地失败,而不是在未来不确定的时间冒着任意、不确定性行为的风险。
请注意,不能保证迭代器的快速失败行为,因为一般来说,在出现非同步并发修改时,不可能做出任何硬保证。快速失败迭代器会尽可能地抛出ConcurrentModificationException。因此,编写依赖于此异常来保证其正确性的程序是错误的:迭代器的快速失败行为只能用于检测错误。
哇呀呀呀 这个翻译真长啊 ,不知道大家看完了没有
我们再来一行一行解读:
static final int DEFAULT_INITIAL_CAPACITY = 1 << 4; // aka 16
// 这里是定义的默认初始值大小   1向左移4     得到的二进制的值是16.容量必须是2的幂次方   那为什么是16呢 还是因为太小的话需要一直扩充容量
太大如果使用不了,还会占内存
 static final int MAXIMUM_CAPACITY = 1 << 30;
  // 这是定义容量的最大值。
static final float DEFAULT_LOAD_FACTOR = 0.75f;
// 定义的默认负载因子的大小,至于为什么是0.75 而不是0.25或者其他数字 下方源码处有注释
这里我的理解是 :它是一个通用的规则,这个默认的负载因子是一种介于对控制时间与空间成本很好的一个权衡 太高的值不是最好,但是太低了也不行,这是一些数学专家在大量计算中得到的值。
负载因子过高,例如为1,虽然减少了空间开销,提高了空间利用率,但同时也增加了查询时间成本;
负载因子过低,例如0.5,虽然可以减少查询时间成本,但是空间利用率很低,同时提高了rehash操作的次数。
所以用的就是0.75。
 static final Entry<?,?>[] EMPTY_TABLE = {};
// Entry 表示是值,默认生成空的一张表   这里生成的表不会直接初始化  它第一次初始化的时间是第一次put 元素的时候
下面会再次介绍到
transient int size;
// 定义的int 类型的动态长度
int threshold;
// int 定义的阈值;容量与负载因子的乘积;
final float loadFactor;
//负载系数
transient int modCount;
// 定义动态的修改次数,这里是为了记录元素被修改的次数。
举个例子:我正在修改这个对应下标为5的元素内容,我还没有完成修改 这个时候另外一个人 也想要修改该内容,他网络快,修改完成之后 这个次数会动态加一,
我们可以看到之后在所有对元素操作的方法内 都会有modCount++, 都会进行+1操作,所以我开始进入修改得到我当前的修改次数为5,我还没有完成+1 操作,
他就完成了加1 ,我再次要进行加1 操作时 发现这个时候modCount 的值为6  ,这时候程序直接就会报出并发修改异常。
static final int ALTERNATIVE_HASHING_THRESHOLD_DEFAULT = Integer.MAX_VALUE;
// 默认的哈希阈值是integer 的最大值
上方是源码内所定义的常量。
接下来我们看一下方法
先看构造函数 里面提供的有三种构造
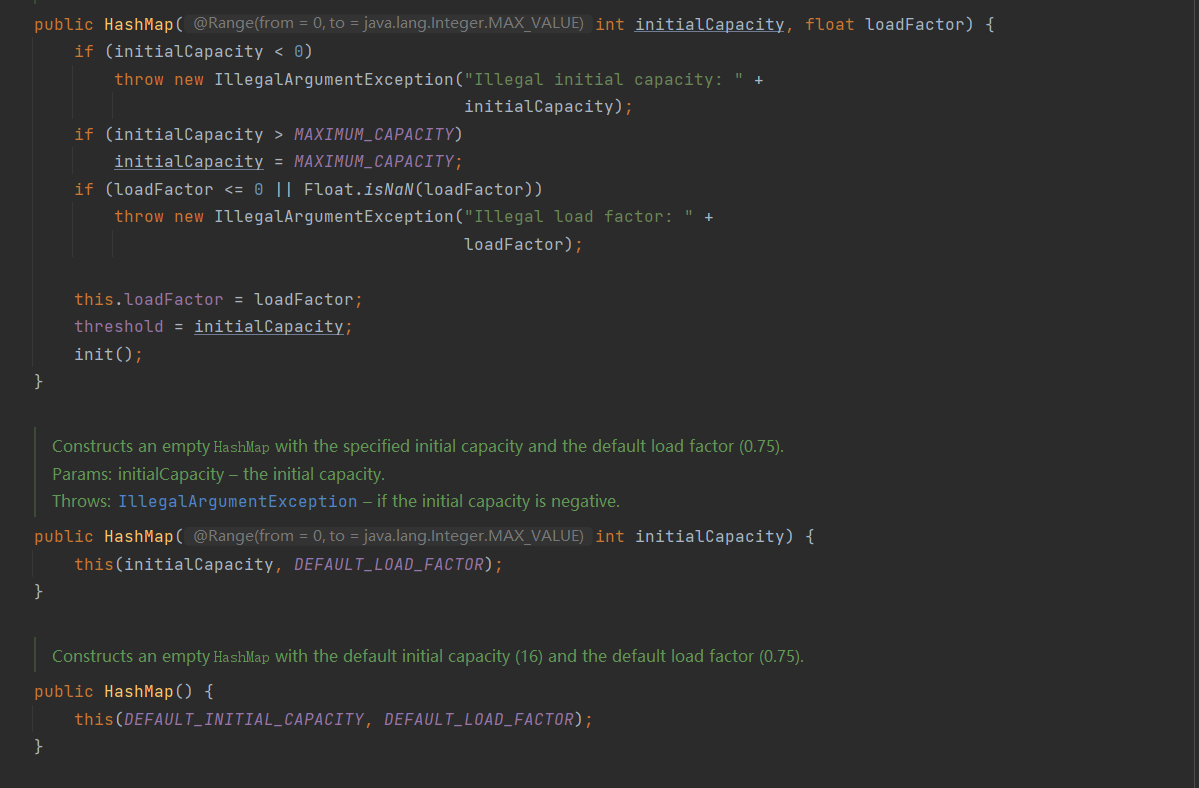
第一个构造传入两个参数,都是在实例化的时候由你来直接定义,一个是容量大小,一个是负载因子;
第二个构造传入一个参数,传入的是容量大小,从0开始,到integer的最大值。 使用默认的负载因子;
第三个构造为无参构造,直接使用的是默认的容量大小(16) 和负载因子(0.75)。
接着看 这里是我们调的put 放入元素的方法
方法体内第一步 我们就来判断这个表是不是空表
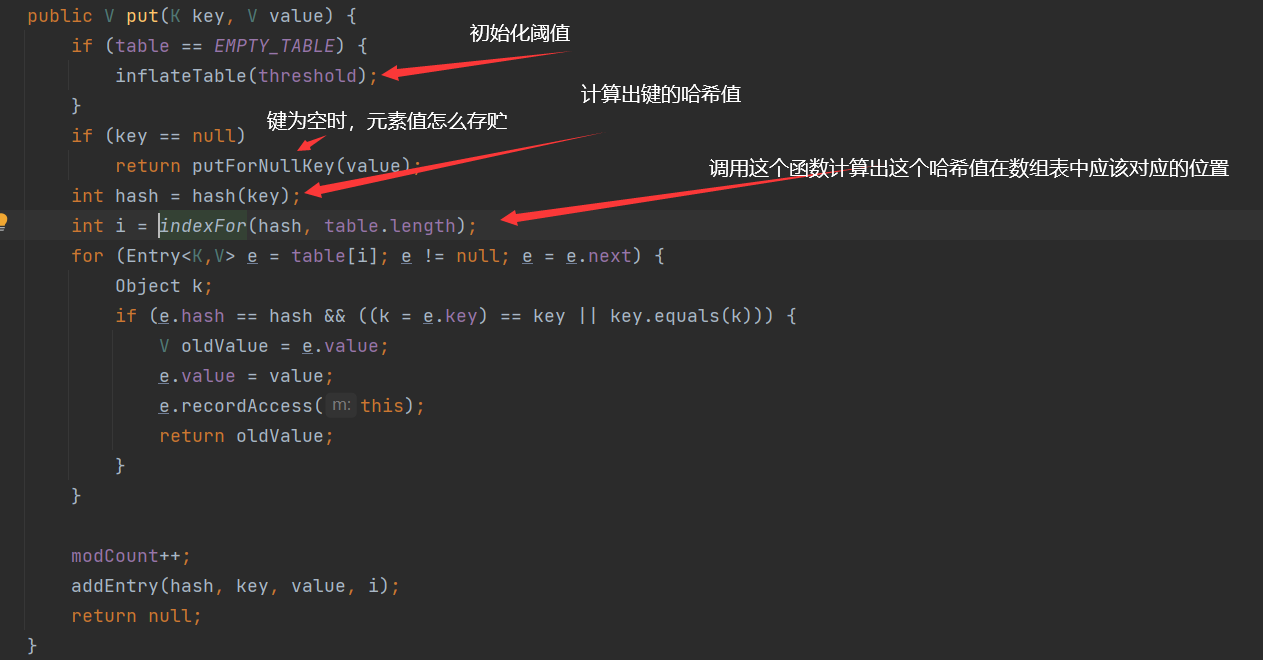
看好咱们倒数第三行 modCount ++;这里就出现了+1 修改次数。
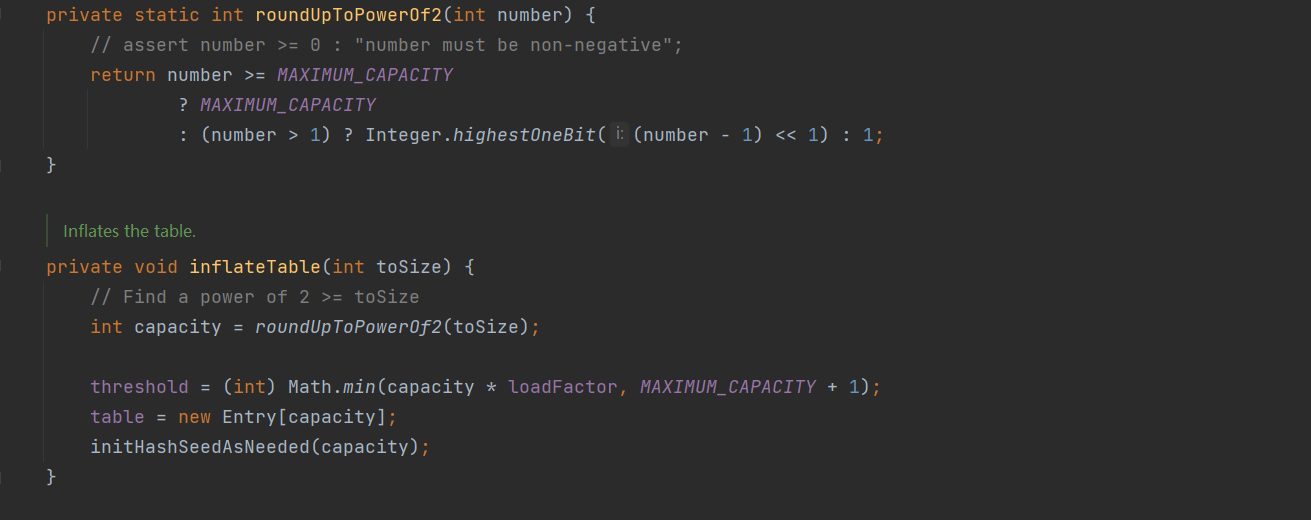
如果为空就调用下图内的方法
roundUpPowerOf2 这里是向上对2转换幂;
这里有一个 number -1 , 原因是因为构造方法中可以让用户自定义容量大小,但是进来后也会向上转成2的幂。当然,如果本身就是2的幂,那么就不会转换了,但是我们可以看到在源码里 有-1 的操作,目的就是为了防止把正确容量也翻一倍。比如定义的32 正好是2 的幂次方,向上对2 转幂 正好就是64,这种情况不是我们想要的。所以每次对应的数值-1 再进行幂转换,可以很大程度少占用内存。这样做更为科学
这里是放入键为空的值是怎么来放的 ,由于HashMap 为键值对形式,为空的键只能有一个,
那么有重复的空键来进入存贮时,进入这个方法 会直接进行新旧元素值替换,保留新值,返回旧值
如果键为空的对应元素没有值,则会直接放在为 0 的下标处

private V putForNullKey(V value) {

        for (Entry<K,V> e = table[0]; e != null; e = e.next) {

            if (e.key == null) {

                V oldValue = e.value;

                e.value = value;

                e.recordAccess(this);

                return oldValue;

            }

        }

        modCount++;

        addEntry(0, null, value, 0);

        return null;

    }
Hash
这个函数确保hashCodes的差异仅为在每个位上的常数倍数有界碰撞数(默认负载系数约为8)。
final int hash(Object k) {

        int h = hashSeed;

        if (0 != h && k instanceof String) {

            return sun.misc.Hashing.stringHash32((String) k);

        }

        h ^= k.hashCode();

        // This function ensures that hashCodes that differ only by

        // constant multiples at each bit position have a bounded

        // number of collisions (approximately 8 at default load factor).

        h ^= (h >>> 20) ^ (h >>> 12);

        return h ^ (h >>> 7) ^ (h >>> 4);

    }
indexFor
作为2的幂次方。我们就必须保证下标函数均匀区分
下标函数,这里的长度必须是2 的非零次幂方   ,length -1,长度-1 确保 & 下来的值 因为0和任何数与都是0,
我们还记得刚刚16 -1 =15  用二进制表示 01111 正好与 下来还是本身 这样就能保证分的均匀,也能保证不越界
static int indexFor(int h, int length) {

        // assert Integer.bitCount(length) == 1 : "length must be a non-zero power of 2";

        return h & (length-1);

    }
来看扩容机制
扩容机制
void addEntry(int hash, K key, V value, int bucketIndex) {
      //判断如果元素个数大于了阈值  并且 当前元素要去的键下标的位置不为空,那么它就扩容,扩容到原来表大小的2倍  始终遵循 2进制的规则

    if ((size >= threshold) && (null != table[bucketIndex])) {

        resize(2 * table.length);

        hash = (null != key) ? hash(key) : 0;

        bucketIndex = indexFor(hash, table.length);

    }

    createEntry(hash, key, value, bucketIndex);

}
下图是扩容机制内调用的方法
将此映射的内容重新散列到一个容量更大的新数组中。当此映射中的键数达到其阈值时,将自动调用此方法。如果当前容量为MAXIMUM_CAPACITY,此方法不会调整map的大小,但将threshold设置为Integer.MAX_VALUE。这有防止未来调用的效果。
参数:
newCapacity—新的容量,必须是2的幂;必须大于当前容量,除非当前容量是MAXIMUM_CAPACITY(在这种情况下值无关)。
void resize(int newCapacity) {

        Entry[] oldTable = table;

        int oldCapacity = oldTable.length;

        if (oldCapacity == MAXIMUM_CAPACITY) {

            threshold = Integer.MAX_VALUE;

            return;

        }


        Entry[] newTable = new Entry[newCapacity];
    //这里的方法调的是下方的转移元素方法。

        transfer(newTable, initHashSeedAsNeeded(newCapacity));

        table = newTable;

        threshold = (int)Math.min(newCapacity * loadFactor, MAXIMUM_CAPACITY + 1);

    }
把之前的所有元素全部转移到新表内,如果哈希码一样,则会进行重新哈希
void transfer(Entry[] newTable, boolean rehash) {

        int newCapacity = newTable.length;

        for (Entry<K,V> e : table) {

            while(null != e) {

                Entry<K,V> next = e.next;
          //重新对键进行哈希

                if (rehash) {

                    e.hash = null == e.key ? 0 : hash(e.key);

                }

                int i = indexFor(e.hash, newCapacity);

                e.next = newTable[i];

                newTable[i] = e;

                e = next;

            }

        }

    }
再来看删除元素
开发者封装了一个方法,传入键参数 根据键来删除对应元素值
 public V remove(Object key) {

        Entry<K,V> e = removeEntryForKey(key);

        return (e == null ? null : e.value);

    }

    /**

     * Removes and returns the entry associated with the specified key

     * in the HashMap.  Returns null if the HashMap contains no mapping

     * for this key.

     */

    final Entry<K,V> removeEntryForKey(Object key) {

        if (size == 0) {

            return null;

        }

        int hash = (key == null) ? 0 : hash(key);

        int i = indexFor(hash, table.length);

        Entry<K,V> prev = table[i];

        Entry<K,V> e = prev;

        while (e != null) {

            Entry<K,V> next = e.next;

            Object k;
       //  由于是元素存贮有链表指向,所以这里判断键的哈希码 也会同时比较该下标键之后的元素内容是否一样

            if (e.hash == hash &&

                ((k = e.key) == key || (key != null && key.equals(k)))) {

                modCount++;

                size--;

                if (prev == e)

                    table[i] = next;

                else

                    prev.next = next;

                e.recordRemoval(this);

                return e;

            }

            prev = e;

            e = next;

        }

        return e;

    }
Clear
这里是清空所有元素,代码也很简单,把所有数组内容填充为空,并把元素大小改为0
public void clear() {

        modCount++;

        Arrays.fill(table, null);

        size = 0;

    }
containValue 遍历查找是否包含某一个值
传入一个元素值判断是否为空,为空就返回true    ,遍历当前整个表中的对象元素,如果包含返回true  ,否则返回false。
public boolean containsValue(Object value) {

        if (value == null)

            return containsNullValue();

        Entry[] tab = table;

        for (int i = 0; i < tab.length ; i++)

            for (Entry e = tab[i] ; e != null ; e = e.next)

                if (value.equals(e.value))

                    return true;

        return false;

    }
containsNullValue() 是否包含空值
for循环进行元素遍历,如果含有空值,返回true   否则为false
private boolean containsNullValue() {

        Entry[] tab = table;

        for (int i = 0; i < tab.length ; i++)

            for (Entry e = tab[i] ; e != null ; e = e.next)

                if (e.value == null)

                    return true;

        return false;

    }
以上就是我对HashMap源码的理解,如有其他看法 欢迎在评论区 留言 互相交流。
真刺激 告辞!
探索HashMap源码 一行一行解析 jdk1.7版本的更多相关文章
- HashMap源码阅读与解析
目录结构 导入语 HashMap构造方法 put()方法解析 addEntry()方法解析 get()方法解析 remove()解析 HashMap如何进行遍历 一.导入语 HashMap是我们最常见 ...
- HashMap源码分析(基于JDK1.6)
在Java集合类中最常用的除了ArrayList外,就是HashMap了.本文尽自己所能,尽量详细的解释HashMap的源码.一山还有一山高,有不足之处请之处,定感谢指定并及时修正. 在看Hash ...
- 源码分析系列1:HashMap源码分析(基于JDK1.8)
1.HashMap的底层实现图示 如上图所示: HashMap底层是由 数组+(链表)+(红黑树) 组成,每个存储在HashMap中的键值对都存放在一个Node节点之中,其中包含了Key-Value ...
- HashMap源码__tableSizeFor方法解析
tableSizeFor(int cap)方法返回不小于指定参数cap的最小2的整数次幂,具体是怎么实现的呢?看源码! /** * Returns a power of two size for th ...
- HashMap源码深度剖析,手把手带你分析每一行代码,包会!!!
HashMap源码深度剖析,手把手带你分析每一行代码! 在前面的两篇文章哈希表的原理和200行代码带你写自己的HashMap(如果你阅读这篇文章感觉有点困难,可以先阅读这两篇文章)当中我们仔细谈到了哈 ...
- [java源码解析]对HashMap源码的分析(二)
上文我们讲了HashMap那骚骚的逻辑结构,这一篇我们来吹吹它的实现思想,也就是算法层面.有兴趣看下或者回顾上一篇HashMap逻辑层面的,可以看下HashMap源码解析(一).使用了哈希表得“拉链法 ...
- HashMap 源码详细分析(JDK1.8)
一.概述 本篇文章我们来聊聊大家日常开发中常用的一个集合类 - HashMap.HashMap 最早出现在 JDK 1.2中,底层基于散列算法实现.HashMap 允许 null 键和 null 值, ...
- 【Java深入研究】9、HashMap源码解析(jdk 1.8)
一.HashMap概述 HashMap是常用的Java集合之一,是基于哈希表的Map接口的实现.与HashTable主要区别为不支持同步和允许null作为key和value.由于HashMap不是线程 ...
- JDK1.8 HashMap源码
序言 触摸本质才能永垂不朽 HashMap底层是基于散列算法实现,散列算法分为散列再探测和拉链式.HashMap 则使用了拉链式的散列算法,并在JDK 1.8中引入了红黑树优化过长的链表.数据结构示意 ...
随机推荐
- Unity3D学习笔记2——绘制一个带纹理的面
目录 1. 概述 2. 详论 2.1. 网格(Mesh) 2.1.1. 顶点 2.1.2. 顶点索引 2.2. 材质(Material) 2.2.1. 创建材质 2.2.2. 使用材质 2.3. 光照 ...
- 22、oracle子查询
22.1.什么是子查询: 1.子查询就是在一条sql语句中嵌入select语句: 2.子查询可区分为关联子查询和非关联子查询,他们和主查询之间的执行顺序和关系是不同的: 22.2.关联子查询: 1.说 ...
- 非静态的字段、方法或属性“System.Web.UI.Page.ClientScript.get”要求对象引用
解决Response.Write("<script>alert('修改失败,请稍后再试!');</script>");布局错误的问题 在后台CS代码(不是C ...
- keycloak~管理平台的查询bug与自定rest中文检索
对于keycloak来说,它的管理平台在它的源码中的admin-client中,它会定义相关的rest接口规范:在我们使用keycloak管理平台时,其中有一个组的查询,在我们查询中文组时,它是不支持 ...
- Python中的json学习
p.p1 { margin: 0; font: 14px ".PingFang SC"; color: rgba(53, 53, 53, 1) } p.p2 { margin: 0 ...
- get和post两种表单提交方式的区别
今天看到一篇博客谈论get和post区别,简单总结一下https://www.cnblogs.com/logsharing/p/8448446.html 要说两者的区别,接触过web开发的人基本上都能 ...
- Java8实战——自己的总结
java8 介绍 java8是2014年3月份,由Oracle发布的一个版本,又称之为jdk1.8,是现再我们在学习和工作中用的最多的一个版本. 在jdk1.8中,java8以添加非常多的新特 ...
- Socket 编程介绍
Socket 编程发展 Linux Socket 编程领域,为了处理大量连接请求场景,需要使用非阻塞 I/O 和复用.select.poll 和 epoll 是 Linux API 提供的 I/O 复 ...
- python使用笔记009--小练习
1.密码生成器 1 ''' 2 1.写一个生产密码的程序,输入几,就产生几条密码,密码产生的不重复. 3 要求密码:长度6-12,密码必须包含 大写字母.小写字母.数字 4 产生完密码后存到一个文件里 ...
- python得到当前版本号
import sys print(sys.winver) 3.7 # 导入sys模块的argv,winver成员,并为其指定别名v.wv from sys import argv as v, winv ...