
MySQL中的联表查询与子查询
- 0.准备数据
- 1.内连接:INNER JOIN
- 2.左连接:LEFT JOIN
- 3.右连接:RIGHT JOIN
- 4.USING子句
- 扩展知识点:
- 0.表别名的使用:
- 1.group by的用法
- 2.子查询
- 1)不相关子查询
- 2)相关子查询
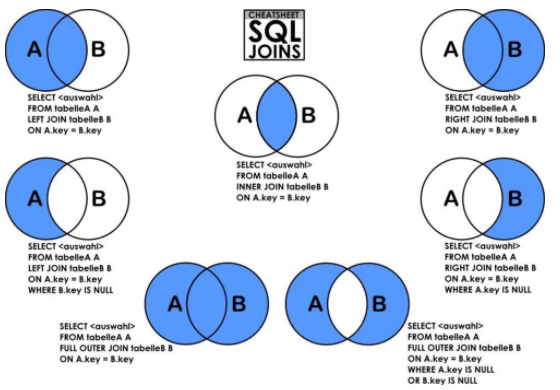
JOIN的含义就如英文单词“join”一样,连接两张表,语法如下所示:
SELECT * FROM A INNER|LEFT|RIGHT JOIN B ON condition
JOIN 按照功能大致分为如下三类:
INNER JOIN(内连接,或等值连接):取得两个表中存在连接匹配关系的记录。
LEFT JOIN(左连接):取得左表(A)完全记录,即是右表(B)并无对应匹配记录。
RIGHT JOIN(右连接):与 LEFT JOIN 相反,取得右表(B)完全记录,即是左表(A)并无匹配对应记录。
注意:mysql不支持Full join,不过可以通过UNION 关键字来合并 LEFT JOIN 与 RIGHT JOIN来模拟FULL join
0.准备数据
|
表
|
表数据
|
命令
|
|---|---|---|
| blog 记录文章名与文章类型 |
|
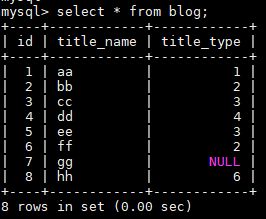
create table blog( id INT primary key auto_increment, title_name varchar(40), title_type int ); insert into blog values(0,'aa',1),(0,'bb',2),(0,'cc',3),(0,'dd',4),(0,'ee',3),(0,'ff',2),(0,'gg',default),(0,'hh',6); |
| blog_type 记录文章类型 |
|
create table blog_type( id INT primary key auto_increment, name varchar(40) ); insert into blog_type values(0,'C'),(0,'PYTHON'),(0,'JAVA'),(0,'HTML'),(0,'C++'); |

1.内连接:INNER JOIN
内连接INNER JOIN/JOIN是最常用的连接操作。从数学的角度讲就是求两个表的交集:
- select * from blog inner join blog_type on blog.title_type=blog_type.id;
- select * from blog join blog_type on blog.title_type=blog_type.id;
- select * from blog,blog_type where blog.title_type=blog_type.id;
输出结果:

2.左连接:LEFT JOIN
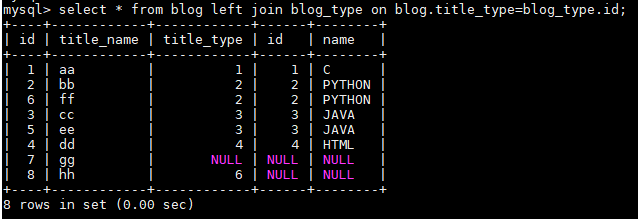
左连接LEFT JOIN的含义就是求两个表的交集外加左表剩下的数据,左连接从左表(A)产生一套完整的记录,与匹配的记录(右表(B)) .如果没有匹配,右侧将包含null。
- select * from blog left join blog_type on blog.title_type=blog_type.id;
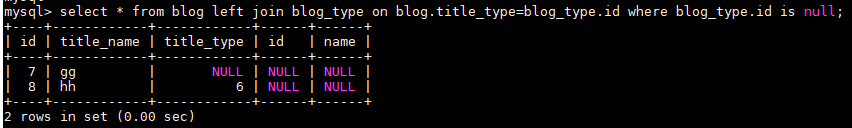
如果想只从左表(A)中产生一套记录,但不包含右表(B)的记录,可以通过设置where语句来执行,如下:
- select * from blog left join blog_type on blog.title_type=blog_type.id where blog_type.id is null;
3.右连接:RIGHT JOIN
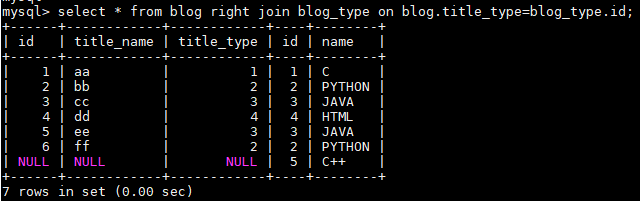
同理右连接RIGHT JOIN就是求两个表的交集外加右表剩下的数据。
select * from blog right join blog_type on blog.title_type=blog_type.id;
4.USING子句
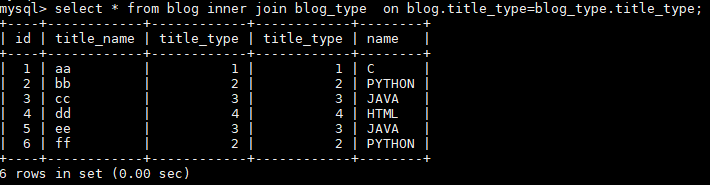
MySQL中连接SQL语句中,ON子句的语法格式为:table1.column_name = table2.column_name。当模式设计对联接表的列采用了相同的命名样式时,就可以使用 USING 语法来简化 ON 语法,格式为:USING(column_name)。 所以,USING的功能相当于ON,区别在于USING指定一个属性名用于连接两个表,而ON指定一个条件。另外,SELECT *时,USING会去除USING指定的列,而ON不会。实例如下。
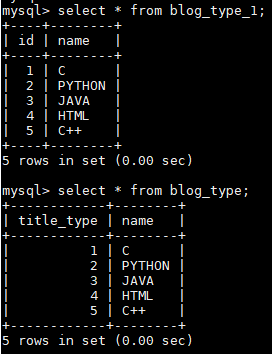
create table blog_type_1 as select * from blog_type;
alter table blog_type drop id;
alter table blog_type add title_type int not null primary key auto_increment first;
|
mysql
|
结果
|
|---|---|
|
select * from blog inner join blog_type on blog.title_type=blog_type.title_type; |
|
|
select * from blog join blog_type using(title_type); USING会去除USING指定的列 |
|

join中改善性能的一些注意点:来自https://www.cnblogs.com/fudashi/p/7506877.html
- 小表驱动大表能够减少内循环的次数从而提高连接效率。
- 在被驱动表建立索引能够提高连接效率
- 优先选择驱动表的属性进行排序能够提高连接效率
扩展知识点:
0.表别名的使用:
对单表做简单的别名查询通常是无意义的。一般是对一个表要当作多个表来操作,或者是对多个表进行操作时,才设置表别名。
1.group by的用法
2.子查询
嵌套在其它查询中的查询称之为子查询或内部查询,包含子查询的查询称之为主查询或外部查询
1)不相关子查询
内部查询的执行独立于外部查询,内部查询仅执行一次,执行完毕后将结果作为外部查询的条件使用
一般在子查询中,程序先运行在嵌套在最内层的语句,再运行外层。因此在写子查询语句时,可以先测试下内层的子查询语句是否输出了想要的内容,再一层层往外测试,增加子查询正确率。否则多层的嵌套使语句可读性很低。
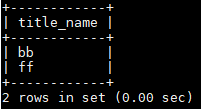
举栗:想要从数据库中获取文章类型是Python的文章列表
|
A
|
B
|
|---|---|
|
select title_name from blog where title_type= (select id from blog_type_1 where name='PYTHON');
|
select title_name from blog A join blog_type_1 B on A.title_type=B.id where B.name='PYTHON';
|
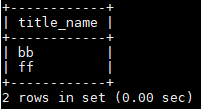
分步执行:
获取id: select id from blog_type_1 where name='PYTHON';---->id=2
获取文章列表:select title_name from blog where title_type=2;-→title name=(bb,ff)
联合查询:
子查询的方式:select title_name from blog where title_type=(select id from blog_type_1 where name='PYTHON');
联表查询的方式:select title_name from blog A join blog_type_1 B on A.title_type=B.id where B.name='PYTHON';
2)相关子查询
内部查询的执行依赖于外部查询的数据,外部查询每执行一次,内部查询也会执行一次。每一次都是外部查询先执行,取出外部查询表中的一个元组,将当前元组中的数据传递给内部查询,然后执行内部查询。
根据内部查询执行的结果,判断当前元组是否满足外部查询中的where条件,若满足则当前元组是符合要求的记录,否则不符合要求。然后,外部查询继续取出下一个元组数据,执行上述的操作,直到全部元组均被处理完毕。
举栗:从历史最好记录的表中获取各个指标最新时间的值
表数据:
蓝色框框中的fr指标数据是重复的,预期想要获取各个指标最新时间的指标值
|
相关子查询
|
联表查询
|
|---|---|
| select * from test_best_history_for_storm_largescale t where date =(select max(date) from test_best_history_for_storm_largescale where fr=t.fr and area="largescale_fuji") and area="largescale_fuji"; | select * from test_best_history_for_storm_largescale A join (select max(date) date,fr from test_best_history_for_storm_largescale where area='largescale_fuji' group by fr)B on A.date=B.date and A.fr=B.fr and A.area='largescale_fuji'; |
|
|
p.p1 { margin: 0; font: 16px Menlo; color: rgba(0, 0, 0, 1) }
span.s1 { font-variant-ligatures: no-common-ligatures }
MySQL中的联表查询与子查询的更多相关文章
- MySQL学习笔记——多表连接和子查询
多表连接查询 # 返回的是两张表的乘积 SELECT * FROM tb_emp,tb_dept SELECT COUNT(*) FROM tb_emp,tb_dept # 标准写法,每个数据库都能这 ...
- MySQL中的DML、DQL和子查询
一.MySQL中的DML语句 1.使用insert插入数据记录: INSERT INTO `myschool`.`student` (`studentNo`, `loginPwd`, `student ...
- MySQL多表查询之外键、表连接、子查询、索引
MySQL多表查询之外键.表连接.子查询.索引 一.外键: 1.什么是外键 2.外键语法 3.外键的条件 4.添加外键 5.删除外键 1.什么是外键: 主键:是唯一标识一条记录,不能有重复的,不允许为 ...
- MySQL开发——【联合查询、多表连接、子查询】
联合查询 所谓的联合查询就是将满足条件的结果进行拼接在同一张表中. 基本语法: select */字段 from 数据表1 union [all | distinct] select */字段 fro ...
- MySQL之多表查询一 介绍 二 多表连接查询 三 符合条件连接查询 四 子查询 五 综合练习
MySQL之多表查询 阅读目录 一 介绍 二 多表连接查询 三 符合条件连接查询 四 子查询 五 综合练习 一 介绍 本节主题 多表连接查询 复合条件连接查询 子查询 首先说一下,我们写项目一般都会建 ...
- mysql数据库之联表查询
表准备: 这次我们用到5张表: class表: student表: score表: course表: teacher表: 表结构模型: 我们针对以下需求分析联表查询: 1.查询所有的课程的名称以及对应 ...
- php mysql 多表查询之子查询语句
所谓子查询语句,就是先通过一个语句来查询出一个结果,然后再通过一个查询语句从这个结果中再次查询.子查询语句一般有以下3种.下面以一个案例来做讲解. 案例:查询[例1]中每个分类下的最新的那一条商品信息 ...
- MYSQL - 外键、约束、多表查询、子查询、视图、事务
MYSQL - 外键.约束.多表查询.子查询.视图.事务 关系 创建成绩表scores,结构如下 id 学生 科目 成绩 思考:学生列应该存什么信息呢? 答:学生列的数据不是在这里新建的,而应该从学生 ...
- mysql多表连接和子查询
文章实例的数据表,来自上一篇博客<mysql简单查询>:http://blog.csdn.net/zuiwuyuan/article/details/39349611 MYSQL的多表连接 ...
随机推荐
- python3 ftplib模块连接FTP
from ftplib import FTP_TLS import os import re class MyFtp(FTP_TLS): """继承FTP类"& ...
- linux中级之防火墙的数据传输过程
网络数据传输过程 netfilter在数据包必须经过且可以读取规则的位置,共设有5个控制关卡.这5个关卡处的检查规则分别放在5个规则链中(有的叫钩子函数(hook functions).也就是说5条链 ...
- json字符串和字典的区别
json字符串和字典的区别: json: (JavaScript Object Notation)的首字母缩写,字面的意思是(javascript对象表示法),这里说的json指的是类似于javasc ...
- Spring的三种注入
在学习Spring的过程中,其中一个很重要的就是依赖注入DI,在此总结一下 注入方式有三种: 一.构造器注入 二.Set方式注入(重点) 三.扩展方式注入 构造器注入: a.默认使用无参构造函数创建对 ...
- 元素定位工具ChroPath - Chrome浏览器插件
一 ChroPath的作用 可以自动识别元素定位表达式,对于系统需要定位元素多时,可使用这种方法减轻定位工作量,但需要验证 二 ChroPath的安装 下载ChroPath -> 在谷歌浏览器访 ...
- 从简单示例看对象的创建过程, 为什么双重检查的单例模式,分析Volatile关键字不能少
编译指令 :javac Test.java 反编译指令: javap -v Test 代码 public class ObjectTest { int m = 8; public static voi ...
- windows10环境下gcc环境变量的配置
1.首先打开控制面板-系统和安全-系统-高级系统设置,打开环境变量 2.在用户变量里找到Path,点击编辑,点击新建,找到Qt的tools安装目录并将目录复制进去保存,我的目录是C:\Qt\Qt5.9 ...
- centos7 安装 bbr加速
脚本安装 1 查看内核版本 # [root@os]# uname -a Linux os 3.10.0-1127.13.1.el7.x86_64 x86_64 x86_64 x86_64 GNU/Li ...
- 【逆向实战】ES文件浏览器未授权访问漏洞(CVE-2019-6447)具体分析及利用
/作者:Kali_MG1937 CSDN博客号:ALDYS4 QQ:3496925334 未经许可,禁止转载/ 漏洞简介 CVE-2019-6447是Android端上的一个知名软件:ES文件浏览器的 ...
- 【工具解析】瑞士军刀bettercap2.X_解析_第二期_内网钓鱼(嗅探)工具编写
/文章作者:Kali_MG1937 CNBLOG博客:ALDYS4 QQ:3496925334/ 第一期: https://www.cnblogs.com/aldys4/p/14877783.html ...