
Spark SQL里concat_ws和collect_set的作用
concat_ws: 用指定的字符连接字符串
例如:
连接字符串:
concat_ws("_", field1, field2),输出结果将会是:“field1_field2”。
数组元素连接:
concat_ws("_", [a,b,c]),输出结果将会是:"a_b_c"。
collect_set: 把聚合的数据组合成一个数组,一般搭配group by 使用。
例如有下表T_course;
| id | name | course |
| 1 | zhang san | Chinese |
| 2 | zhang san | Math |
| 3 | zhang san | English |
spark.sql("select name, collect_set(course) as course_set from T_course group by name");
结果是:
| name | course_set |
| zhang san | [Chinese,Math,English] |
贴上套牌车项目代码:
public class TpcCompute2 {

    public static void main(String[] args) {

        SparkSession spark = SparkSession.builder().enableHiveSupport().appName("TpcCompute2").master("local").getOrCreate();

        JavaSparkContext sc = new JavaSparkContext(spark.sparkContext());

        sc.setLogLevel("ERROR");

        //hphm,id,tgsj,lonlat&

        spark.udf().register("getTpc", new ComputeUDF(), DataTypes.StringType);

        spark.sql("use traffic");

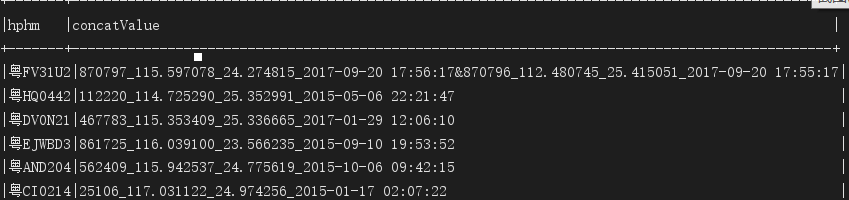
        spark.sql("select hphm,concat_ws('&',collect_set(concat_ws('_',id,kk_lon_lat,tgsj))) as concatValue from t_cltgxx t where t.tgsj>'2015-01-01 00:00:00' group by hphm").show(false);

        Dataset<Row> cltgxxDF =

                spark.sql("select hphm,concatValue from (select hphm,getTpc(concat_ws('&',collect_set(concat_ws('_',id,kk_lon_lat,tgsj)))) as concatValue from t_cltgxx t where t.tgsj>'2015-01-01 00:00:00' group by hphm) where concatValue is not null");

        cltgxxDF.show();

        //创建集合累加器

        CollectionAccumulator<String> acc = sc.sc().collectionAccumulator();

        cltgxxDF.foreach(new ForeachFunction<Row>() {

            @Override

            public void call(Row row) throws Exception {

                acc.add(row.getAs("concatValue"));

            }

        });

        List<String> values = acc.value();

        for (String id : accValues) {

            System.out.println("accValues: " + id);

            Dataset<Row> resultDF = spark.sql("select hphm,clpp,clys,tgsj,kkbh from t_cltgxx where id in (" + id.split("_")[] + "," + id.split("_")[] + ")");

            resultDF.show();

            Dataset<Row> resultDF2 = resultDF.withColumn("jsbh", functions.lit(new Date().getTime()))

                    .withColumn("create_time", functions.lit(new Timestamp(new Date().getTime())));

            resultDF2.show();

            resultDF2.write()

                    .format("jdbc")

                    .option("url","jdbc:mysql://lin01.cniao5.com:3306/traffic?characterEncoding=UTF-8")

                    .option("dbtable","t_tpc_result")

                    .option("user","root")

                    .option("password","")

                    .mode(SaveMode.Append)

                    .save();

    }

}
spark.sql语句输出样式:
Spark SQL里concat_ws和collect_set的作用的更多相关文章
- 第三篇:Spark SQL Catalyst源码分析之Analyzer
/** Spark SQL源码分析系列文章*/ 前面几篇文章讲解了Spark SQL的核心执行流程和Spark SQL的Catalyst框架的Sql Parser是怎样接受用户输入sql,经过解析生成 ...
- Spark SQL Catalyst源代码分析之Analyzer
/** Spark SQL源代码分析系列文章*/ 前面几篇文章解说了Spark SQL的核心运行流程和Spark SQL的Catalyst框架的Sql Parser是如何接受用户输入sql,经过解析生 ...
- 第九篇:Spark SQL 源码分析之 In-Memory Columnar Storage源码分析之 cache table
/** Spark SQL源码分析系列文章*/ Spark SQL 可以将数据缓存到内存中,我们可以见到的通过调用cache table tableName即可将一张表缓存到内存中,来极大的提高查询效 ...
- 整理对Spark SQL的理解
Catalyst Catalyst是与Spark解耦的一个独立库,是一个impl-free的运行计划的生成和优化框架. 眼下与Spark Core还是耦合的.对此user邮件组里有人对此提出疑问,见m ...
- 转】 Spark SQL UDF使用
原博文出自于: http://blog.csdn.net/oopsoom/article/details/39401391 感谢! Spark1.1推出了Uer Define Function功能,用 ...
- Spark SQL CLI 实现分析
背景 本文主要介绍了Spark SQL里眼下的CLI实现,代码之后肯定会有不少变动,所以我关注的是比較核心的逻辑.主要是对照了Hive CLI的实现方式,比較Spark SQL在哪块地方做了改动,哪些 ...
- spark sql的agg函数,作用:在整体DataFrame不分组聚合
.agg(expers:column*) 返回dataframe类型 ,同数学计算求值 df.agg(max("age"), avg("salary")) df ...
- 【原】Learning Spark (Python版) 学习笔记(三)----工作原理、调优与Spark SQL
周末的任务是更新Learning Spark系列第三篇,以为自己写不完了,但为了改正拖延症,还是得完成给自己定的任务啊 = =.这三章主要讲Spark的运行过程(本地+集群),性能调优以及Spark ...
- 【转载】Spark SQL之External DataSource外部数据源
http://blog.csdn.net/oopsoom/article/details/42061077 一.Spark SQL External DataSource简介 随着Spark1.2的发 ...
随机推荐
- idea操作maven时控制台中文显示乱码/maven项目启动方式
在idea中通过maven启动项目时,在前台显示数据库信息,没有中文乱码问题,在控制台中mybatis显示数据库的信息,中文显示乱码. 在程序中用 System.out.println 输出中文的时候 ...
- Ansible入门笔记(2)之常用模块
目录 Ansible常用模块 1.1.Ansible Ad-hoc 1.2.Ansible的基础命令 1.3.常用模块 Ansible常用模块 1.1.Ansible Ad-hoc 什么事ad-hoc ...
- pyppeteer进阶技巧
记录一下在使用pyppeteer过程中慢慢发现的一些稍微高级一点的用法. 一.拦截器简单用法 拦截器作用于单个Page,即浏览器中的一个标签页.每初始化一个Page都要添加一下拦截器.拦截器实际上是 ...
- Linux无法免密登录的原因
一.免密登录的方法 下面操作是把/root/.ssh/id_dsa.pub文件内容追加到192.168.7.100系统中的/root/.ssh/authorized_keys文件中 # 创建并发送密钥 ...
- Flask-Script Manager
Flask Script扩展提供向Flask插入外部脚本的功能,包括运行一个开发用的服务器,一个定制的Python shell,设置数据库的脚本,cronjobs,及其他运行在web应用之外的命令行任 ...
- redis windows下载地址
https://github.com/MicrosoftArchive/redis/tags
- Beta冲刺阶段博客集合
Beta冲刺阶段博客集合 课程名称:软件工程1916|W(福州大学) 团队名称: 云打印 作业要求: 项目Beta冲刺(团队) 作业目标:作业集合 团队队员 队员学号 队员姓名 个人博客地址 备注 2 ...
- SHOI2017 分手是祝愿
分手是祝愿 有
- linux中/dev/null与2>&1讲解
首先先来看下几种标识的含义: /dev/null 表示空设备文件 0 表示stdin标准输入 1 表示stdout标准输出 2 表示stderr标准错误 先看/dev/null command > ...
- 15、Python面向对象基础
和其它编程语言相比,Python 在尽可能不增加新的语法和语义的情况下加入了类机制. Python中的类提供了面向对象编程的所有基本功能:类的继承机制允许多个基类,派生类可以覆盖基类中的任何方法,方法 ...