
python爬虫入门---第二篇:获取2019年中国大学排名
我们需要爬取的网站:最好大学网
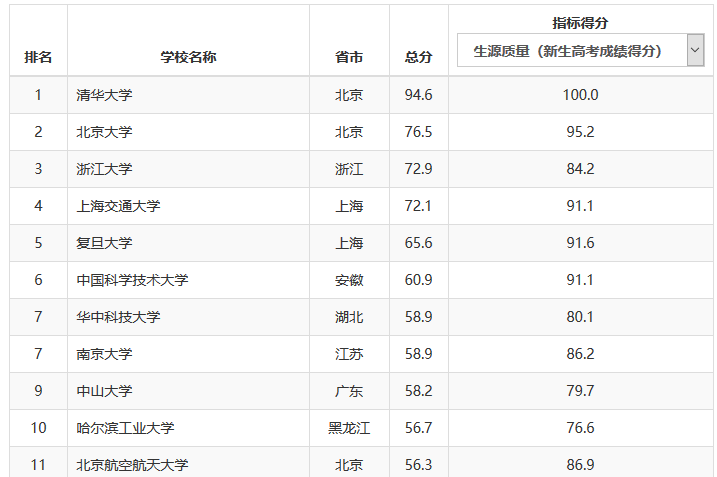
我们需要爬取的内容即为该网页中的表格部分:
该部分的html关键代码为:
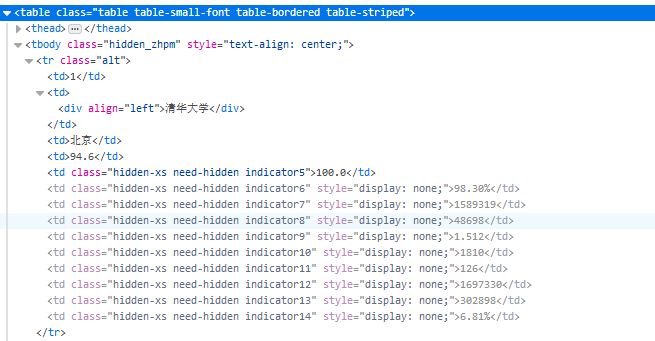
其中整个表的标签为<tbody>标签,每行的标签为<tr>标签,每行中的每个单元格的标签为<td>标签,而我们所需的内容即为每个单元格中的内容。
因此编写程序的大概思路就是先找到整个表格的<tbody>标签,再遍历<tbody>标签下的所有<tr>标签,最后遍历<tr>标签下的所有<td>标签,
我们用二维列表来存储所有的数据,其中二维列表中的每个列表用于存储一行中的每个单元格数据,即<tr>标签下的所有<td>标签中的所有字符串。
代码如下;
import requests

from bs4 import BeautifulSoup

import bs4

def get_html_text(url):

    '''返回网页的HTML代码'''

    try:

        res = requests.get(url, timeout = 6)

        res.raise_for_status()

        res.encoding = res.apparent_encoding

        return res.text

    except:

        return ''

def fill_ulist(ulist, html):

    '''将我们所需的数据写入一个列表ulist'''

    #解析HTML代码,并获得解析后的对象soup

    soup = BeautifulSoup(html, 'html.parser')

    #遍历得到第一个<tbody>标签

    tbody = soup.tbody

    #遍历<tbody>标签的孩子,即<tbody>下的所有<tr>标签及字符串

    for tr in tbody.children:

        #排除字符串

        if isinstance(tr, bs4.element.Tag):

            #使用find_all()函数找到tr标签中的所有<td>标签

            u = tr.find_all('td')

            #将<td>标签中的字符串内容写入列表ulist

            ulist.append([u[0].string, u[1].string, u[2].string, u[3].string])

def display_urank(ulist):

    '''格式化输出大学排名'''

    tplt = "{:^5}\t{:{ocp}^12}\t{:{ocp}^5}\t{:^5}"

    #方便中文对其显示,使用中文字宽作为站字符,chr(12288)为中文空格符

    print(tplt.format("排名", "大学名称", "省市", "总分", ocp = chr(12288)))

    for u in ulist:

        print(tplt.format(u[0], u[1], u[2], u[3], ocp = chr(12288)))

def write_in_file(ulist, file_path):

    '''将大学排名写入文件'''

    tplt = "{:^5}\t{:{ocp}^12}\t{:{ocp}^5}\t{:^5}\n"

    with open(file_path, 'w') as file_object:

        file_object.write('软科中国最好大学排名2019版:\n\n')

        file_object.write(tplt.format("排名", "大学名称", "省市", "总分", ocp = chr(12288)))

        for u in ulist:

            file_object.write(tplt.format(u[0], u[1], u[2], u[3], ocp = chr(12288)))

def main():

    '''主函数'''

    ulist = []

    url = 'http://www.zuihaodaxue.cn/zuihaodaxuepaiming2019.html'

    file_path = 'university rankings.txt'

    html = get_html_text(url)

    fill_ulist(ulist, html)

    display_urank(ulist)

    write_in_file(ulist, file_path)

main()
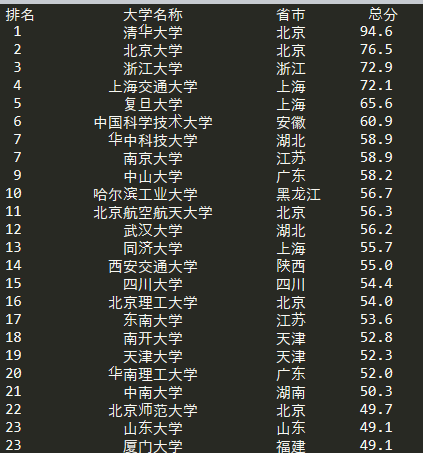
打印显示:
python爬虫入门---第二篇:获取2019年中国大学排名的更多相关文章
- Python爬虫入门案例:获取百词斩已学单词列表
百词斩是一款很不错的单词记忆APP,在学习过程中,它会记录你所学的每个单词及你答错的次数,通过此列表可以很方便地找到自己在记忆哪些单词时总是反复出错记不住.我们来用Python来爬取这些信息,同时学习 ...
- python爬虫入门---第一篇:获取某一网页所有超链接
这是一个通过使用requests和BeautifulSoup库,简单爬取网站的所有超链接的小爬虫.有任何问题欢迎留言讨论. import requests from bs4 import Beauti ...
- 2.Python爬虫入门二之爬虫基础了解
1.什么是爬虫 爬虫,即网络爬虫,大家可以理解为在网络上爬行的一直蜘蛛,互联网就比作一张大网,而爬虫便是在这张网上爬来爬去的蜘蛛咯,如果它遇到资源,那么它就会抓取下来.想抓取什么?这个由你来控制它咯. ...
- Python爬虫入门二之爬虫基础了解
1.什么是爬虫 爬虫,即网络爬虫,大家可以理解为在网络上爬行的一直蜘蛛,互联网就比作一张大网,而爬虫便是在这张网上爬来爬去的蜘蛛咯,如果它遇到资源,那么它就会抓取下来.想抓取什么?这个由你来控制它咯. ...
- 转 Python爬虫入门二之爬虫基础了解
静觅 » Python爬虫入门二之爬虫基础了解 2.浏览网页的过程 在用户浏览网页的过程中,我们可能会看到许多好看的图片,比如 http://image.baidu.com/ ,我们会看到几张的图片以 ...
- Python爬虫入门有哪些基础知识点
1.什么是爬虫 爬虫,即网络爬虫,大家可以理解为在网络上爬行的一直蜘蛛,互联网就比作一张大网,而爬虫便是在这张网上爬来爬去的蜘蛛咯,如果它遇到资源,那么它就会抓取下来.想抓取什么?这个由你来控制它咯. ...
- Python爬虫入门(二)之Requests库
Python爬虫入门(二)之Requests库 我是照着小白教程做的,所以该篇是更小白教程hhhhhhhh 一.Requests库的简介 Requests 唯一的一个非转基因的 Python HTTP ...
- Python开发【第二篇】:初识Python
Python开发[第二篇]:初识Python Python简介 Python前世今生 python的创始人为吉多·范罗苏姆(Guido van Rossum).1989年的圣诞节期间,吉多·范罗苏 ...
- Python爬虫入门教程 43-100 百思不得姐APP数据-手机APP爬虫部分
1. Python爬虫入门教程 爬取背景 2019年1月10日深夜,打开了百思不得姐APP,想了一下是否可以爬呢?不自觉的安装到了夜神模拟器里面.这个APP还是比较有名和有意思的. 下面是百思不得姐的 ...
随机推荐
- Word中带圈数字
写论文时常常要求输入带圈数字,先在Word中输入代码,选中代码后按Alt+X(然后再粘贴到Excel中) 符号 代码⓪ 24ea① 2460② 2461③ 2462④ 2463⑤ 2464⑥ 2465 ...
- 「LOJ2000~2023」各省省选题选做
「LOJ2000~2023」各省省选题选做 「SDOI2017」数字表格 莫比乌斯反演. 「SDOI2017」树点涂色 咕咕咕. 「SDOI2017」序列计数 多项式快速幂. 我们将超过 \(p\) ...
- 移动端IM开发者必读(一):通俗易懂,理解移动网络的“弱”和“慢”
本系列文章引用了腾讯技术专家樊华恒<海量之道系列文章之弱联网优化>的部分章节,感谢原作者. 1.前言 随着移动互联网的高速发展,移动端IM以移动网络作为物理通信载体早已深入人心,这其中的成 ...
- linux上面是否有安装redis,redis启动
1.进入/usr/local/src目录,下载redis # cd /usr/local/src# wget http://download.redis.io/releases/redis-4.0.6 ...
- Spring Bean 的生命周期,如何被管理的?
定义 Bean是一个被实例化,组装,并通过Spring IOC容器(BeanFactory和ApplicationContext容器)所管理的对象. 作用域 Spring支持五个作用域,分别是sing ...
- F#周报2019年第17期
新闻 .NET版本的Apache Spark Apache Spark预览版介绍 F# Apache Spark示例 微软Build 2019大会(5月6日至8日) Rider用于F#的解决方案内的重 ...
- docker 安全
由于容器运行在主机上,且与主机共用一套内核,因此在容器的安全使用上会涉及到容器本身以及主机的安全加固,如针对系统调用,系统资源,远程访问等都需要进行安全方面的考量. docker官网给出了简单的一些建 ...
- 团队作业4——beta阶段冲刺
Deadline: 2018-12-16 22:00PM,以博客提交至班级博客时间为准 提交: (a) 项目课堂演示: (b) 1篇冲刺准备+5篇冲刺随笔,: (c) 1篇用户使用用报告: (d) 1 ...
- ThreadLocalMap里Entry为何声明为WeakReference?
Java里,每个线程都有自己的ThreadLocalMap,里边存着自己私有的对象.Map的Entry里,key为ThreadLocal对象,value即为私有对象T.在spring MVC中,常用T ...
- netty源码解解析(4.0)-9 ChannelPipleline的默认实现-链表管理
io.netty.channel.DefaultChannelPipeline implements ChannelPipleline DefaultChannelPiple给出了ChannelP ...