
scrapy简单分布式爬虫
经过一段时间的折腾,终于整明白scrapy分布式是怎么个搞法了,特记录一点心得。
虽然scrapy能做的事情很多,但是要做到大规模的分布式应用则捉襟见肘。有能人改变了scrapy的队列调度,将起始的网址从start_urls里分离出来,改为从redis读取,多个客户端可以同时读取同一个redis,从而实现了分布式的爬虫。就算在同一台电脑上,也可以多进程的运行爬虫,在大规模抓取的过程中非常有效。
准备:
1、windows一台(从:scrapy)
2、linux一台(主:scrapy\redis\mongo)
ip:192.168.184.129
3、python3.6
linux下scrapy的配置步骤:
、安装python3.

    yum install openssl-devel -y   解决pip3不能使用的问题(pip is configured with locations that require TLS/SSL, however the ssl module in Python is not available)

    下载python软件包,Python-3.6..tar.xz,解压后

      ./configure --prefix=/python3

      make

      make install

    加上环境变量:

      PATH=/python3/bin:$PATH:$HOME/bin

      export PATH

    安装完成后,pip3默认也已经安装完成了(安装前需要先yum gcc)

  、安装Twisted

    下载Twisted-17.9..tar.bz2,解压后 cd Twisted-17.9., python3 setup.py install

  、安装scrapy

    pip3 install scrapy

    pip3 install scrapy-redis

  、安装redis

    见博文redis安装与简单使用

    错误:You need tcl 8.5 or newer in order to run the Redis test

      、wget http://downloads.sourceforge.net/tcl/tcl8.6.1-src.tar.gz

      、tar -xvf tcl8.6.1-src.tar.gz

      、cd tcl8.6.1/unix ; make; make install

    cp /root/redis-3.2.11/redis.conf /etc/
    启动:/root/redis-3.2.11/src/redis-server /etc/redis.conf &

  、pip3 install redis

  、安装mongodb

    参考菜鸟教程:http://www.runoob.com/mongodb/mongodb-linux-install.html
    启动:# mongod --bind_ip 192.168.184.129 &

  、pip3 install pymongo
windows上scrapy的部署步骤:
、安装wheel

        pip install wheel

    、安装lxml

        https://pypi.python.org/pypi/lxml/4.1.0

    、安装pyopenssl

        https://pypi.python.org/pypi/pyOpenSSL/17.5.0

    、安装Twisted

        https://www.lfd.uci.edu/~gohlke/pythonlibs/

    、安装pywin32

        https://sourceforge.net/projects/pywin32/files/

    、安装scrapy

        pip install scrapy
部署代码:
我以美剧天堂的电影爬取为简单例子,说一下分布式的实现,代码linux和windows上各放一份,配置一样,两者可同时运行爬取。
只列出需要修改的地方:
settings
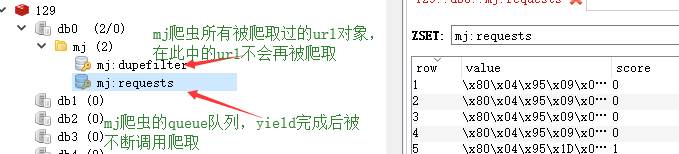
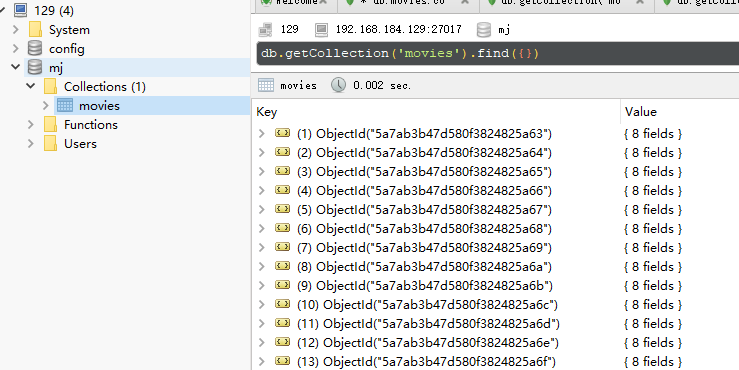
设置爬取数据的存储数据库(mongodb),指纹和queue存储的数据库(redis)
ROBOTSTXT_OBEY = False  # 禁止robot

CONCURRENT_REQUESTS =   # scrapy调试queue的最大并发,默认16

ITEM_PIPELINES = {

   'meiju.pipelines.MongoPipeline': ,

}

MONGO_URI = '192.168.184.129'  # mongodb连接信息

MONGO_DATABASE = 'mj'

SCHEDULER = "scrapy_redis.scheduler.Scheduler" # 使用scrapy_redis的调度

DUPEFILTER_CLASS = "scrapy_redis.dupefilter.RFPDupeFilter"  # 在redis库中去重(url)

# REDIS_URL = 'redis://root:kongzhagen@localhost:6379'  # 如果redis有密码,使用这个配置

REDIS_HOST = '192.168.184.129'  #redisdb连接信息

REDIS_PORT =

SCHEDULER_PERSIST = True  # 不清空指纹
piplines
存储到MongoDB的代码
import pymongo

class MeijuPipeline(object):

    def process_item(self, item, spider):

        return item

class MongoPipeline(object):

    collection_name = 'movies'

    def __init__(self, mongo_uri, mongo_db):

        self.mongo_uri = mongo_uri

        self.mongo_db = mongo_db

    @classmethod

    def from_crawler(cls, crawler):

        return cls(

            mongo_uri=crawler.settings.get('MONGO_URI'),

            mongo_db=crawler.settings.get('MONGO_DATABASE', 'items')

        )

    def open_spider(self, spider):

        self.client = pymongo.MongoClient(self.mongo_uri)

        self.db = self.client[self.mongo_db]

    def close_spider(self, spider):

        self.client.close()

    def process_item(self, item, spider):

        self.db[self.collection_name].insert_one(dict(item))

        return item
items
数据结构
import scrapy

class MeijuItem(scrapy.Item):

    movieName = scrapy.Field()

    status = scrapy.Field()

    english = scrapy.Field()

    alias = scrapy.Field()

    tv = scrapy.Field()

    year = scrapy.Field()

    type = scrapy.Field()
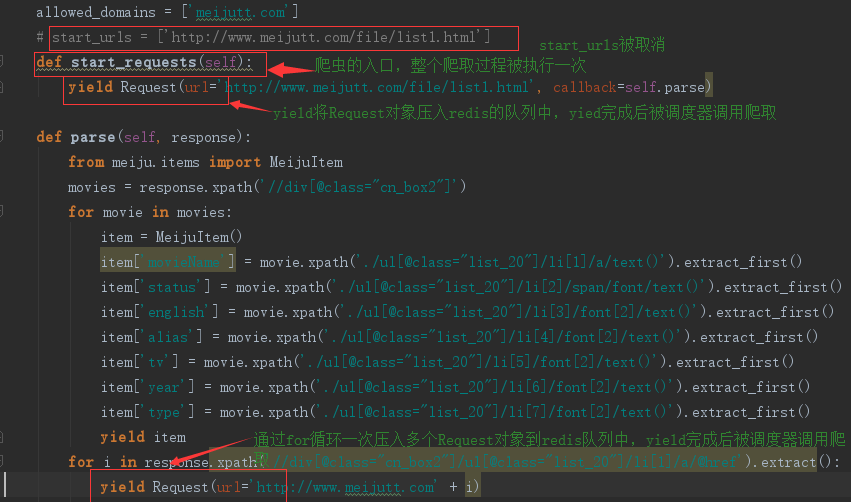
爬虫脚本mj.py
# -*- coding: utf- -*-

import scrapy

from scrapy import Request

class MjSpider(scrapy.Spider):

    name = 'mj'

    allowed_domains = ['meijutt.com']

    # start_urls = ['http://www.meijutt.com/file/list1.html']

    def start_requests(self):

        yield Request(url='http://www.meijutt.com/file/list1.html', callback=self.parse)

    def parse(self, response):

        from meiju.items import MeijuItem

        movies = response.xpath('//div[@class="cn_box2"]')

        for movie in movies:

            item = MeijuItem()

            item['movieName'] = movie.xpath('./ul[@class="list_20"]/li[1]/a/text()').extract_first()

            item['status'] = movie.xpath('./ul[@class="list_20"]/li[2]/span/font/text()').extract_first()

            item['english'] = movie.xpath('./ul[@class="list_20"]/li[3]/font[2]/text()').extract_first()

            item['alias'] = movie.xpath('./ul[@class="list_20"]/li[4]/font[2]/text()').extract_first()

            item['tv'] = movie.xpath('./ul[@class="list_20"]/li[5]/font[2]/text()').extract_first()

            item['year'] = movie.xpath('./ul[@class="list_20"]/li[6]/font[2]/text()').extract_first()

            item['type'] = movie.xpath('./ul[@class="list_20"]/li[7]/font[2]/text()').extract_first()

            yield item

        for i in response.xpath('//div[@class="cn_box2"]/ul[@class="list_20"]/li[1]/a/@href').extract():

            yield Request(url='http://www.meijutt.com' + i)

        # next = 'http://www.meijutt.com' + response.xpath("//a[contains(.,'下一页')]/@href")[].extract()

        # print(next)

        # yield Request(url=next, callback=self.parse)
看一下redis中的情况:
看看mongodb中的数据:
scrapy简单分布式爬虫的更多相关文章
- 纯手工打造简单分布式爬虫(Python)
前言 这次分享的文章是我<Python爬虫开发与项目实战>基础篇 第七章的内容,关于如何手工打造简单分布式爬虫 (如果大家对这本书感兴趣的话,可以看一下 试读样章),下面是文章的具体内容. ...
- scrapy进行分布式爬虫
今天,参照崔庆才老师的爬虫实战课程,实践了一下分布式爬虫,并没有之前想象的那么神秘,其实非常的简单,相信你看过这篇文章后,不出一小时,便可以动手完成一个分布式爬虫! 1.分布式爬虫原理 首先我们来看一 ...
- Scrapy 框架 分布式 爬虫
分布式 爬虫 scrapy-redis 实现 原生scrapy 无法实现 分布式 调度器和管道无法被分布式机群共享 环境安装 - pip install scrapy_redis 导包:from sc ...
- 16 Scrapy之分布式爬虫
redis分布式部署 1.scrapy框架是否可以自己实现分布式? - 不可以.原因有二. 其一:因为多台机器上部署的scrapy会各自拥有各自的调度器,这样就使得多台机器无法分配start_urls ...
- scrapy补充-分布式爬虫
spiders 介绍:在项目中是创建爬虫程序的py文件 #1.Spiders是由一系列类(定义了一个网址或一组网址将被爬取)组成,具体包括如何执行爬取任务并且如何从页面中提取结构化的数据. #2.换句 ...
- Python简单分布式爬虫
分布式爬虫采用主从模式.主从模式是指由一台主机作为控制节点,负责管理所有运行网络爬虫的主机(url管理器,数据存储器,控制调度器),爬虫只需要从控制节点哪里接收任务,并把新生成任务提交给控制节点.此次 ...
- 基于scrapy的分布式爬虫抓取新浪微博个人信息和微博内容存入MySQL
为了学习机器学习深度学习和文本挖掘方面的知识,需要获取一定的数据,新浪微博的大量数据可以作为此次研究历程的对象 一.环境准备 python 2.7 scrapy框架的部署(可以查看上一篇博客的简 ...
- 第三百六十五节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的基本查询
第三百六十五节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的基本查询 1.elasticsearch(搜索引擎)的查询 elasticsearch是功能 ...
- 四十四 Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的基本查询
1.elasticsearch(搜索引擎)的查询 elasticsearch是功能非常强大的搜索引擎,使用它的目的就是为了快速的查询到需要的数据 查询分类: 基本查询:使用elasticsearch内 ...
随机推荐
- Python函数——命名空间与闭包
前言 执行以下代码 def my_test(): x = 1 y = x+1 print(x) >> Traceback (most recent call last): File &qu ...
- (转)Linux内核参数之arp_ignore和arp_announce
原文:https://blog.csdn.net/ccy19910925/article/details/79960599 一.arp_ignore和arp_announce介绍 arp_ignore ...
- TCP/IP 笔记 - 地址解析协议
地址解析协议(ARP)提供了一种在IPv4地址和各种网络技术使用的硬件地址之间的映射.ARP仅用于IPv4,IPv6使用邻居发现协议,它被合并入ICMPv6.地址解析是发现两个地址之间的映射关系的过程 ...
- 金山wps面经
前言: 金山wps笔试是好久之前的了,忘记具体几号了.当时在华师参加的宣讲会,然后线下笔试通过了, 昨天(4月2号通知现场面试).今天是在华工酒店进行面试的,一二面一起进行的 一面: 1: 自我介绍 ...
- openssl签署和自签署证书的多种实现方式
openssl系列文章:http://www.cnblogs.com/f-ck-need-u/p/7048359.html 1.采用自定义配置文件的实现方法 1.1 自建CA 自建CA的机制:1.生成 ...
- 使用 libjpeg 库解压数据示例
static int MjpegDecompress( *** ) { struct jpeg_decompress_struct tDInfo; struct jpeg_error_mgr jerr ...
- WPF 使用 Direct2D1 画图入门
本文来告诉大家如何在 WPF 使用 D2D 画图. 本文是一个系列 WPF 使用 Direct2D1 画图入门 WPF 使用 Direct2D1 画图 绘制基本图形 WPF 使用 SharpDX WP ...
- MVC四大筛选器—ActionFilter&ResultedFilter
AuthorizeFilter筛选器 在Action的执行中包括两个重要的部分,一个是Action方法本身逻辑代码的执行,第二个就是Action方法的筛选器的执行. MVC4中筛选器都是以AOP(面向 ...
- SQL SERVER 如何判断是不是年,月最后一天
, SYSDATETIME())) PRINT '不是'; ELSE PRINT '是'; GO , SYSDATETIME())) PRINT '不是'; ELSE PRINT '是'; GO 1. ...
- 【Java基础】4、java中的内部类
内部类的分类:常规内部类.静态内部类.私有内部类.局部内部类.匿名内部类. 实例1:常规内部类 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 2 ...