
webcollector 2.x 爬取搜狗搜索结果页
 /**

  * 使用搜狗搜索检索关键字并爬取结果集的标题

  * @author tele

  *

  */

 public class SougouCrawler extends RamCrawler{

     public SougouCrawler() {

     }

     public SougouCrawler(String keyword,int maxnum) {

         for(int i=1;i<=maxnum;i++) {

             //拼接url

             String url ="https://www.sogou.com/web?query="+keyword+"&s_from=result_up&cid=&page="+ i +"&ie=utf8&p=40040100&dp=1&w=01029901&dr=1";

             CrawlDatum crawlDatum = new CrawlDatum(url).meta("pageNum",i);

             addSeed(crawlDatum);

             addRegex(".*");

         }

     }

     @Override

     public void visit(Page page, CrawlDatums next) {

         String pageNum = page.meta("pageNum");

         Elements results = page.doc().select("div.results div[^class] h3 a");

         for(int i=0;i<results.size();i++) {

             System.out.println("第"+ pageNum +"页第"+ (i+1) +"条结果------" + results.get(i).text());

         }

     }

     public static void main(String[] args) throws Exception {

         String keyword="淘宝";

         SougouCrawler crawler  = new SougouCrawler(keyword,3);

         crawler.setThreads(8);

         Configuration conf = Configuration.copyDefault();

         conf.setExecuteInterval(3000);

         conf.setReadTimeout(5000);

         conf.setWaitThreadEndTime(3000);

         crawler.setConf(conf);

         crawler.start(1);//只有一层

     }

 }
输出截图(部分)
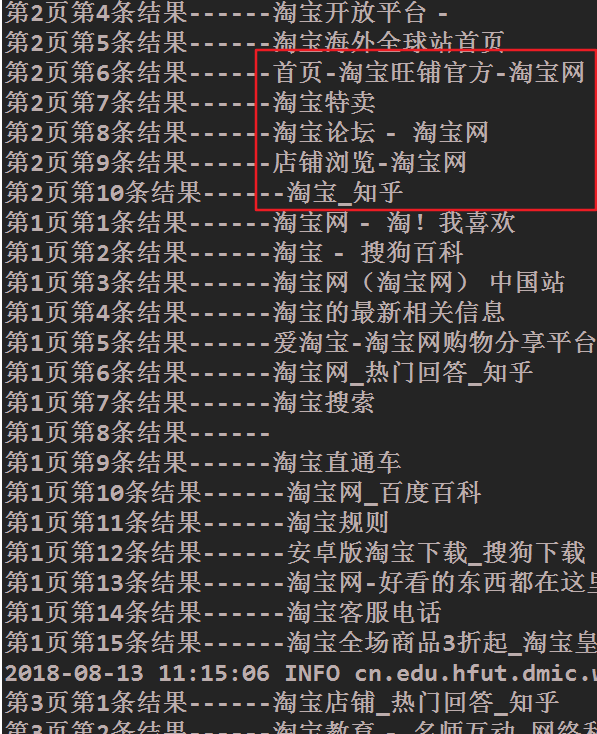
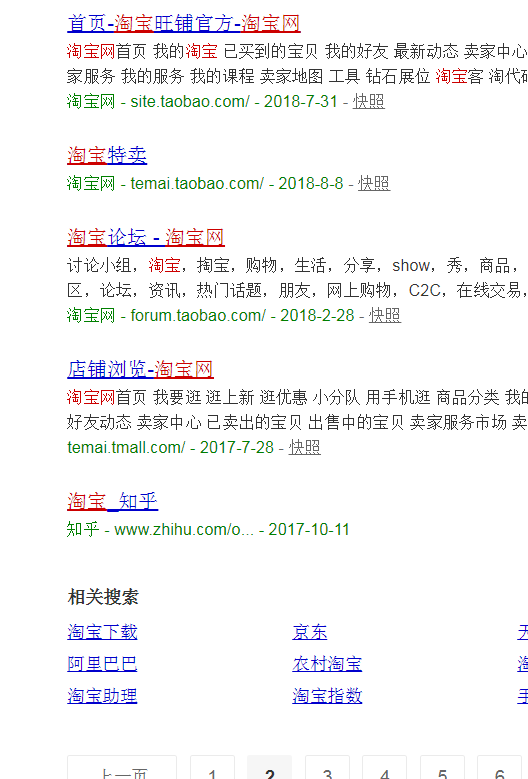
验证第二页数据标题
webcollector 2.x 爬取搜狗搜索结果页的更多相关文章
- 第三百三十节,web爬虫讲解2—urllib库爬虫—实战爬取搜狗微信公众号—抓包软件安装Fiddler4讲解
第三百三十节,web爬虫讲解2—urllib库爬虫—实战爬取搜狗微信公众号—抓包软件安装Fiddler4讲解 封装模块 #!/usr/bin/env python # -*- coding: utf- ...
- 九 web爬虫讲解2—urllib库爬虫—实战爬取搜狗微信公众号—抓包软件安装Fiddler4讲解
封装模块 #!/usr/bin/env python # -*- coding: utf-8 -*- import urllib from urllib import request import j ...
- requests利用selenium,代理Ip,云打码,验证码抠图操作 爬取搜狗微信公众号内容
爬取思路,爬取搜狗微信公众号内容,爬取第一层url时请求太快出现验证码,我这里用的蘑菇云代理,并在程序中我判断什么情况下是否+代理,做到合理运用代理ip.爬取第二层url时验证码出现次数更严重(和第一 ...
- 用scrapy爬取搜狗Lofter图片
用scrapy爬取搜狗Lofter图片 # -*- coding: utf-8 -*- import json import scrapy from scrapy.http import Reques ...
- 用WebCollector制作一个爬取《知乎》并进行问题精准抽取的爬虫(JAVA)
简单介绍: WebCollector是一个无须配置.便于二次开发的JAVA爬虫框架(内核),它提供精简的的API.仅仅需少量代码就可以实现一个功能强大的爬虫. 怎样将WebCollector导入项目请 ...
- python3 爬取搜狗微信的文章
目标地址:http://weixin.sogou.com/weixin? 这个地址是搜狗微信的文章搜索,可以搜索到微信的文章,而我们目标就是这些文章内容 这个url经过测试,当我们没登陆微信只能看到1 ...
- scrapy实战7爬取搜狗微信:
爬取微信热门文章标题,内容,内容地址,微信公众号,公众号地址,发布日期等 如图 源码地址:https://github.com/huwei86/sougouweixin
- 使用php的curl根据关键词爬取百度搜索结果页
http://bbs.csdn.net/wap/topics/390938327 正则表达式匹配Html标签 查找所有的TD区域(最短):<td\s*.*>\s*.*<\/td& ...
- Python爬虫 爬取搜狗搜索到的内容页面
废话不多说,直接上代码 import requests def main(): url='https://www.sogou.com/web' headers={ 'User_Agent':'Mozi ...
随机推荐
- Codeforces Beta Round #16 E. Fish (状压dp)(概率dp)
Codeforces Beta Round #16 (Div. 2 Only) E. Fish 题目链接:## 点击打开链接 题意: 有 \(n\) 条鱼,每两条鱼相遇都会有其中一只吃掉对方,现在给你 ...
- equals、HashCode与实体类的设计
equals和HashCode都是用来去重的,即判断两个对象是否相等.如果是String类则我们直接用.equals()判断,如果是我们自己定义的类,需要有自己的判断方法,重写equals,如果是集合 ...
- SorceTree 与 Bitbucket连接
选择bitbucket,由于bitbucket免费的帐号最多能够8个人一起协同开发.我们项目组人数少于8个,私有仓库也不限制. 经过半个多月的应用,大家感觉也还不错,对个人而言.在家也能訪问代码,对公 ...
- CentOS 7 virt-manager 无法连接本地的hypervisor
OS : CentOS 7 Gnome Desktop 问题描写叙述: CentOS 7 下使用yum install virt-manager之后.使用virt-manager无法连接本地的hype ...
- OC的DES加密,使与java的Cipher类用DES/CBC/PKCS5Padding方式的加密结果同样
问题说明: 近期用到DES加密,而且要与java的Cipher类加密的结果保持一致.没研究过java的Cliper,但工作中Cipher依据DES/CBC/PKCS5Padding加密方式生成了一个字 ...
- Cannot resolve reference to bean 'entityManagerFactory' while setting constructor argument
spring 5.+jpa 配置类出错: 十二月 20, 2018 5:53:01 下午 org.springframework.web.servlet.DispatcherServlet initS ...
- SaltStack快速部署及测试
测试环境:CentOS6.6 X86_64 # cat /etc/hosts 192.168.199.61 Ansible 192.168.199.60 Nginx1 192.168.199.62 N ...
- 9.10 Binder系统_Java实现_hello服务
怎么做?2.1 定义接口: 写IHelloService.aidl文件, 上传, 编译, 得到IHelloService.java 里面有Stub : onTransact, 它会分辨收到数据然后调用 ...
- programming-challenges Crypt Kicker (110204) 题解
我的解答,可是复杂度不是非常惬意,是一个指数级的复杂度.可是測试数据比較弱,还是ac了.在网上找了找.都是brute force的解法,不知道有没有更好的解法. 解答中犯了两个错误,第一个.map&l ...
- 分析Net 内存对象
.Net 内存对象分析 在生产环境中,通过运行日志我们会发现一些异常问题,此时,我们不能直接拿VS远程到服务器上调试,同时日志输出的信息无法百分百反映内存中对象的状态,比如说我们想查看进程中所有的 ...