
Spark Streaming之五:Window窗体相关操作
SparkStreaming之window滑动窗口应用,Spark Streaming提供了滑动窗口操作的支持,从而让我们可以对一个滑动窗口内的数据执行计算操作。每次掉落在窗口内的RDD的数据,会被聚合起来执行计算操作,然后生成的RDD,会作为window DStream的一个RDD。
网官图中所示,就是对每三秒钟的数据执行一次滑动窗口计算,这3秒内的3个RDD会被聚合起来进行处理,然后过了两秒钟,又会对最近三秒内的数据执行滑动窗口计算。所以每个滑动窗口操作,都必须指定两个参数,窗口长度以及滑动间隔,而且这两个参数值都必须是batch间隔的整数倍。
Spark Streaming对滑动窗口的支持,是比Storm更加完善和强大的。

之前有些朋友问:
spark官网图片中: 滑动窗口宽度是3个时间单位,滑动时间是2两个单位,这样的话中间time3的Dstream不是重复计算了吗?
Answer:比如下面这个例子是针对热搜的应用场景,官方的例子也可能是是针对不同的场景给出了的。如果你不想出现重叠的部分,把滑动间隔由2改成3即可
SparkStreaming对滑动窗口支持的转换操作:

示例讲解:
val windowWords = words.window(Seconds( 3 ), Seconds( 1))

2、 countByWindow(windowLength,slideInterval)
val windowWords = words.countByWindow(Seconds( 3 ), Seconds( 1))

val windowWords = words.reduceByWindow(_ + "-" + _, Seconds( 3) , Seconds( 1 ))

val windowWords = pairs.reduceByKeyAndWindow((a:Int , b:Int) => (a + b) , Seconds(3 ) , Seconds( 1 ))

val windowWords = pairs.reduceByKeyAndWindow((a: Int, b:Int ) => (a + b) , (a:Int, b: Int) => (a - b) , Seconds( 3 ), Seconds( 1 ))
下面是演示结果,最终的结果是该3秒长度的窗口中历史上出现过的所有不同单词个数都为0。
一段时间不输入任何信息,看一下最终结果
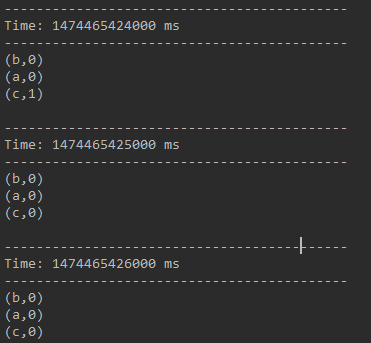
val windowWords = words.countByValueAndWindow(Seconds( 3 ), Seconds( 1))

示例二:热点搜索词滑动统计,每隔10秒钟,统计最近60秒钟的搜索词的搜索频次,并打印出排名最靠前的3个搜索词以及出现次数
Scala版本:
package com.spark.streaming

import org.apache.spark.streaming.Seconds

import org.apache.spark.streaming.StreamingContext

import org.apache.spark.SparkConf

/**

 * @author Ganymede

 */

object WindowHotWordS {

  def main(args: Array[String]): Unit = {

    val conf = new SparkConf().setAppName("WindowHotWordS").setMaster("local[2]")

    //Scala中,创建的是StreamingContext

    val ssc = new StreamingContext(conf, Seconds(5))

    val searchLogsDStream = ssc.socketTextStream("spark1", 9999)

    val searchWordsDStream = searchLogsDStream.map { searchLog => searchLog.split(" ")(1) }

    val searchWordPairDStream = searchWordsDStream.map { searchWord => (searchWord, 1) }

    // reduceByKeyAndWindow

    // 第二个参数,是窗口长度,这是是60秒

    // 第三个参数,是滑动间隔,这里是10秒

    // 也就是说,每隔10秒钟,将最近60秒的数据,作为一个窗口,进行内部的RDD的聚合,然后统一对一个RDD进行后续计算

    // 而是只是放在那里

    // 然后,等待我们的滑动间隔到了以后,10秒到了,会将之前60秒的RDD,因为一个batch间隔是5秒,所以之前60秒,就有12个RDD,给聚合起来,然后统一执行reduceByKey操作

    // 所以这里的reduceByKeyAndWindow,是针对每个窗口执行计算的,而不是针对 某个DStream中的RDD

    // 每隔10秒钟,出来 之前60秒的收集到的单词的统计次数

    val searchWordCountsDStream = searchWordPairDStream.reduceByKeyAndWindow((v1: Int, v2: Int) => v1 + v2, Seconds(60), Seconds(10))

    val finalDStream = searchWordCountsDStream.transform(searchWordCountsRDD => {

      val countSearchWordsRDD = searchWordCountsRDD.map(tuple => (tuple._2, tuple._1))

      val sortedCountSearchWordsRDD = countSearchWordsRDD.sortByKey(false)

      val sortedSearchWordCountsRDD = sortedCountSearchWordsRDD.map(tuple => (tuple._1, tuple._2))

      val top3SearchWordCounts = sortedSearchWordCountsRDD.take(3)

      for (tuple <- top3SearchWordCounts) {

        println("result : " + tuple)

      }

      searchWordCountsRDD

    })

    finalDStream.print()

    ssc.start()

    ssc.awaitTermination()

  }

}
Spark Streaming之五:Window窗体相关操作的更多相关文章
- c# 窗体相关操作(最大化/最小化/关闭/标题栏)
/// <summary> /// 窗体跟随鼠标移动的标记 /// </summary> private bool normalmoving = false; /// < ...
- EXTJS 4.2 资料 控件之Window窗体相关属性的用法
最大化,最小化,是否显示关闭按钮 var win_CommonPicLibMultiple = Ext.create("Ext.window.Window", { title: & ...
- 禁用,移除 WPF window窗体系统操作SystemMenu
public static class SystemMenuManager { [DllImport("user32.dll", EntryPoint = "GetSys ...
- Spark Streaming之一:整体介绍
提到Spark Streaming,我们不得不说一下BDAS(Berkeley Data Analytics Stack),这个伯克利大学提出的关于数据分析的软件栈.从它的视角来看,目前的大数据处理可 ...
- 57、Spark Streaming: window滑动窗口以及热点搜索词滑动统计案例
一.window滑动窗口 1.概述 Spark Streaming提供了滑动窗口操作的支持,从而让我们可以对一个滑动窗口内的数据执行计算操作.每次掉落在窗口内的RDD的数据, 会被聚合起来执行计算操作 ...
- Spark Streaming源码解读之生成全生命周期彻底研究与思考
本期内容 : DStream与RDD关系彻底研究 Streaming中RDD的生成彻底研究 问题的提出 : 1. RDD是怎么生成的,依靠什么生成 2.执行时是否与Spark Core上的RDD执行有 ...
- Apache 流框架 Flink,Spark Streaming,Storm对比分析(二)
本文由 网易云发布. 本文内容接上一篇Apache 流框架 Flink,Spark Streaming,Storm对比分析(一) 2.Spark Streaming架构及特性分析 2.1 基本架构 ...
- spark第六篇:Spark Streaming Programming Guide
预览 Spark Streaming是Spark核心API的扩展,支持高扩展,高吞吐量,实时数据流的容错流处理.数据可以从Kafka,Flume或TCP socket等许多来源获取,并且可以使用复杂的 ...
- Apache 流框架 Flink,Spark Streaming,Storm对比分析(2)
此文已由作者岳猛授权网易云社区发布. 欢迎访问网易云社区,了解更多网易技术产品运营经验. 2.Spark Streaming架构及特性分析 2.1 基本架构 基于是spark core的spark s ...
随机推荐
- 【Git使用】SourceTree+Git简单使用(Windows)(转)
导读: 本人过去Git的可视化工具用的是TortoiseGit,虽然Android Studio也能进行版本管理,但是用下来,感觉SoureTree这款工具是最舒服的(免费的),下面就给大家介绍下我的 ...
- TIDB-cenos7开发环境搭建
1.安装centos7,注意要安装桌面,如果最小化安装,无法使用IDE了 关闭防火墙或者打开4000端口 systemctl stop firewalld.service #停止firewall sy ...
- 使用tpcc-mysql进行性能测试
tpcc-mysql的github地址:https://github.com/Percona-Lab/tpcc-mysql tpcc-mysql源代码进行编译,服务器上需要安装有mysql git c ...
- uva-10391-枚举
题意:对于输入的字符串,判断是否存在一个单词a=b+c 俩种方法,枚举每一个单词进行拼接,复杂度是n*n 枚举每一个单词,对单词进行substr,判断substr出来的是不在map里面 #includ ...
- java 创建简单工厂模式
1.抽象类 package com.zpark.service; /** * 定义一个环境接口,所有省治理环境的方式都实现这个接口,并重写治理环境的方法 * @author tong * */ pub ...
- 如何利用Social Listening从社会化媒体中“提炼”有价值的信息?
本文转自知乎 作者:苏格兰折耳喵 ----------------------------------------------------- 在本文中,笔者将会介绍大数据分析主要的处对象---社会化媒 ...
- C#内存管理和垃圾回收机制
数据类型 垃圾回收机制 一.数据类型 C#中的数据类型分为值类型 (Value type) 和引用类型(reference type), 值 类 型: 所有的值类型都集成自 System.Value ...
- django之setup()
#django包的__init__.py包含setup函数def setup(): """ Configure the settings (this happens as ...
- 64位操作系统(Windows 2008 R2 X64)ASP.NET 调用32位Excel,word 出现401 – 未授权: 由于凭据无效,访问被拒绝。
先确保IIS设置正确,目录权限设置正确. 打开“IIS信息服务管理器”——>选择你发布的网站——>选择功能视图中的“身份验证”——>右键匿名身份验证,选择“编辑”,选择“特定用户“– ...
- Kubernetes的ConfigMap说明
这篇博文,我们来说一说,关于在kubernetes的pod中自定义配置的问题. 我们知道,在几乎所有的应用开发中,都会涉及到配置文件的变更,比如说在web的程序中,需要连接数据库,缓存甚至是队列等等. ...