
对result文件进行数据清洗以及进行可视化
项目源码地址:https://github.com/gayu121/result(项目里操作的数据都是清洗过后的数据)
测试要求:
1、 数据清洗:按照进行数据清洗,并将清洗后的数据导入hive数据库中。
两阶段数据清洗:
(1)第一阶段:把需要的信息从原始日志中提取出来
(2)第二阶段:根据提取出来的信息做精细化操作
(3)hive数据库表结构:
create table data( ip string, time string , day string, traffic bigint,
type string, id string )
2、数据处理:
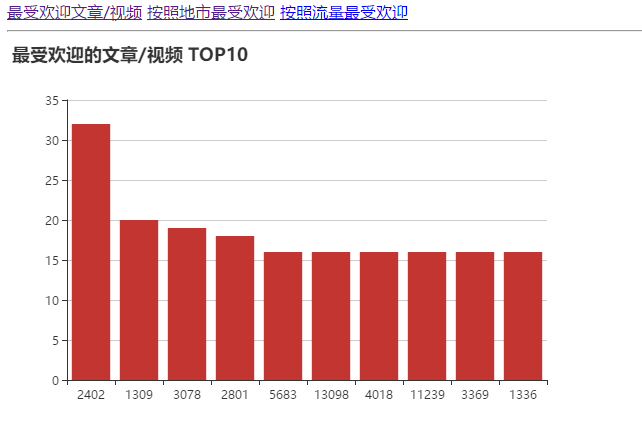
·统计最受欢迎的视频/文章的Top10访问次数 (video/article)
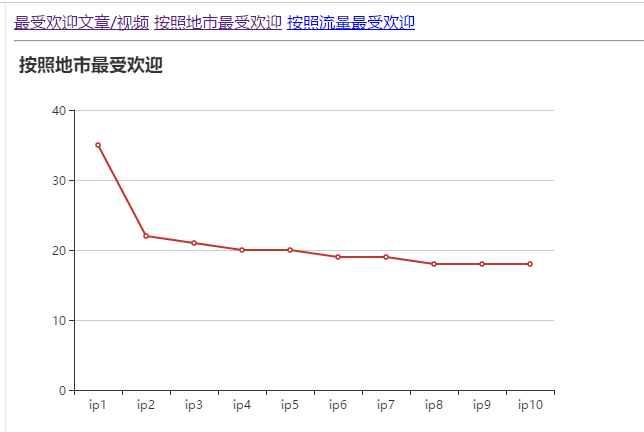
·按照地市统计最受欢迎的Top10课程 (ip)
·按照流量统计最受欢迎的Top10课程 (traffic)
3、数据可视化:将统计结果倒入MySql数据库中,通过图形化展示的方式展现出来。
由于所给的文件是一个TXT文档,数据项之间用逗号隔开,格式如图:
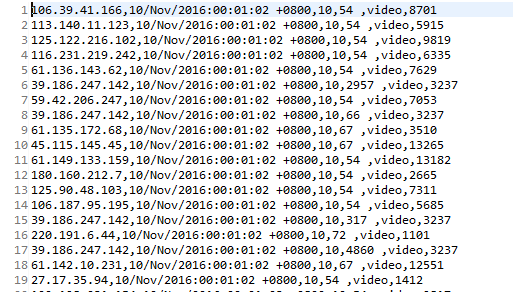
所以需要对数据首先进行清洗,变为用Tab建作为分隔的数据项,在此我弄了很久找不到合适的方法,在同学的指点下使用排序的算法,以id为数据项进行了排序,将数据清洗为要求格式,第二阶段的细化过程也就同理了,在这里附上细化使用的代码
package test3;

import java.io.IOException;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.IntWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.Mapper;

import org.apache.hadoop.mapreduce.Reducer;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.input.TextInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

import org.apache.hadoop.mapreduce.lib.output.TextOutputFormat;

public class Order2 {

    public static class Map extends Mapper<Object , Text , IntWritable,Text >{

        private static Text goods=new Text();

        private static IntWritable num=new IntWritable();

        public void map(Object key,Text value,Context context) throws IOException, InterruptedException{

        String line=value.toString();

        String arr[]=line.split("[\t/:]" );  //主要就是根据这几个特殊字符进行分割,然后按照下面的格式输出到指定文件

        num.set(Integer.parseInt(arr[]));

        goods.set(arr[] + "\t"  + arr[] +"-11-10" +" " + arr[] +":" + arr[]+":" +arr[] +"\t"+ arr[] + "\t" + arr[] + "\t"+arr[] );

        context.write(num,goods);

        }

        }

        public static class Reduce extends Reducer< IntWritable, Text, IntWritable, Text>{

        private static IntWritable result= new IntWritable();

        public void reduce(IntWritable key,Iterable<Text> values,Context context) throws IOException, InterruptedException{

            for(Text val:values){

            context.write(key,val);

            }

        }

            }

            public static void main(String[] args) throws IOException, ClassNotFoundException, InterruptedException{

            Configuration conf=new Configuration();

            Job job =new Job(conf,"OneSort");

            job.setJarByClass(Order.class);

            job.setMapperClass(Map.class);

            job.setReducerClass(Reduce.class);

            job.setOutputKeyClass(IntWritable.class);

            job.setOutputValueClass(Text.class);

            job.setInputFormatClass(TextInputFormat.class);

        job.setOutputFormatClass(TextOutputFormat.class);

            Path in=new Path("hdfs://192.168.43.102:9000/test/res1/part-r-00000");

            Path out=new Path("hdfs://192.168.43.102:9000/test/res2");

            FileInputFormat.addInputPath(job,in);

            FileOutputFormat.setOutputPath(job,out);

            System.exit(job.waitForCompletion(true) ?  : );

            }

            }
然后第二问就是利用一个MapReduce的统计的方法,针对不同的条件进行计数,然后利用排序算法进行排序,这一块儿的代码在项目里都有,感性趣的话可以到github里下载。
然后在可视化是遇到了一些问题,就是对于那个城市的IP(估计是由于字符太长,无法在echarts中显示)可以打印输出就是不能生成表格,所以那些数据项我就用IP1.....代替了。还有一个问题就是在根据字符串循环时老是说我数组越界,然后我就自己写了一个循环,只有10个数据元,就解决了。
以下是可视化的截图(我用了echarts中的三种显示形式):
柱状图:
折线图:
饼状图:

对result文件进行数据清洗以及进行可视化的更多相关文章
- 吴裕雄--天生自然python数据清洗与数据可视化:MYSQL、MongoDB数据库连接与查询、爬取天猫连衣裙数据保存到MongoDB
本博文使用的数据库是MySQL和MongoDB数据库.安装MySQL可以参照我的这篇博文:https://www.cnblogs.com/tszr/p/12112777.html 其中操作Mysql使 ...
- 310实验室OTL问题----将写好的C++文件转换成Python文件,并将数据可视化
如图:文件夹 第一处:optimizer文件夹下的:optimizer.h文件中添加你所写代码的头文件 #include <OTL/Optimizer/Reference-NSGA-II/Re ...
- 在VMD上可视化hdf5格式的分子轨迹文件
技术背景 在处理分子动力学模拟的数据时,不可避免的会遇到众多的大轨迹文件.因此以什么样的格式来存储这些庞大的轨迹数据,也是一个在分子动力学模拟软件设计初期就应该妥善考虑的问题.现有的比较常见的方式,大 ...
- python爬取拉勾网数据并进行数据可视化
爬取拉勾网关于python职位相关的数据信息,并将爬取的数据已csv各式存入文件,然后对csv文件相关字段的数据进行清洗,并对数据可视化展示,包括柱状图展示.直方图展示.词云展示等并根据可视化的数据做 ...
- Hive的存储和MapReduce处理——数据清洗
日期:2019.11.13 博客期:115 星期三 Result文件数据说明: Ip:106.39.41.166,(城市) Date:10/Nov/2016:00:01:02 +0800,(日期) D ...
- 关系网络数据可视化:3. 案例:公司职员关系图表 & 导演演员关系网络可视化
1. 公司职员关系图表 节点和边界数据 节点是指每个节点本身的数据,代表公司职工的名称:属性(Country).分类(Category)和地区(Region,给每个节点定义的属性数据).文件必须是.c ...
- 使用mapreduce清洗简单日志文件并导入hive数据库
Result文件数据说明: Ip:106.39.41.166,(城市) Date:10/Nov/2016:00:01:02 +0800,(日期) Day:10,(天数) Traffic: 54 ,(流 ...
- c++可视化性能测试
阅读前注意 本文所有代码贴出来的目的是帮助大家理解,并非是要引导大家跟写,许多环境问题文件问题没有详细说明,代码也并不全面,达不到跟做的效果.建议直接阅读全文即可,我在最后会给出详细代码地址,对源代码 ...
- 将.dat文件导入数据库
*最近在搞文本分类,就是把一批文章分成[军事].[娱乐].[政治]等等. 但是这个先需要一些样本进行训练,感觉文本分类和"按图索骥"差不多,训练的文章样本就是"图&quo ...
随机推荐
- mysql锁及四种事务隔离级别笔记
前言 数据库是一个共享资源,为了充分利用数据库资源,发挥数据 库共享资源的特点,应该允许多个用户并行地存取数据库.但这样就会产生多个用户程序并 发存取同一数据的情况,为了避免破坏一致性,所以必须提供并 ...
- CPP 设计模式学习
源地址 https://www.ev0l.art/index.php/archives/20/ 备忘录模式 在一个类内部记录另一个类的快照状态的模式.可以再合适的时候跳回复用 设计备忘录的三大步骤: ...
- 通用高效的数据修复方法:Row level repair
导读:随着大数据的进一步发展,NoSQL 数据库系统迅速发展并得到了广泛的应用.其中,Apache Cassandra 是最广泛使用的数据库之一.对于 Cassandra 的优化是大家研究的热点,而 ...
- RabbitMQ远程调用测试用例
RabbitMQ远程调用测试,使用外部机器192.168.174.132上的RabbitMQ,使用之前需要对远程调用进行配置,操作过程见博文“解决RabbitMQ远程不能访问的问题”. SendTes ...
- C语言之函数用法总结
C语言函数概述: 构成C语言程序的基本模块,模块化编程的最小单位. 函数调用的基本方式: 函数调用时的数据传递: 函数调用的过程: 函数原型与函数定义的区别: 函数封装: 1.外界对函数的影响仅限于入 ...
- python 条件判断的三元表达式
示例:求两数中最大者 在JavaScript中代码如下: x = 1; y = 2; console.log(x > y ? x : y) 在python中代码如下: # 条件为真时的返回结果 ...
- 前端笔记7-js3
1.方法: //创建一个对象var obj = {name:"孙悟空",age:18}; //对象的属性也可以是对象 obj.brother = {name:"猪八戒&q ...
- Android权限系统
Android系统为每个应用程序提供了一个安全的运行环境,不同程序间相互隔离,应用程序的数据等私有资源,外界无法访问.这个安全的运行环境由Android的权限系统(可称为沙箱系统)来提供.本文简单记录 ...
- Activiti服务任务(serviceTask)
Activiti服务任务(serviceTask) 作者:Jesai 都有一段沉默的时间,等待厚积薄发 应用场景: 当客户有这么一个需求:下一个任务我需要自动执行一些操作,并且这个节点不需要任何的人工 ...
- Jenkins-k8s-helm-harbor-githab-mysql-nfs微服务发布平台实战
基于 K8S 构建 Jenkins 微服务发布平台 实现汇总: 发布流程设计讲解 准备基础环境 K8s环境(部署Ingress Controller,CoreDNS,Calico/Flannel) 部 ...