
Java爬虫学习(3)之用对象保存新浪微博博文
 package com.mieba;

 import us.codecraft.webmagic.Page;

 import us.codecraft.webmagic.Site;

 import us.codecraft.webmagic.processor.PageProcessor;

 public class SinaPageProcessor implements PageProcessor

 {

     public static final String URL_LIST = "http://blog\\.sina\\.com\\.cn/s/articlelist_1487828712_0_\\d+\\.html";

     public static final String URL_POST = "http://blog\\.sina\\.com\\.cn/s/blog_\\w+\\.html";

     private Site site = Site.me().setTimeOut(10000).setRetryTimes(3).setSleepTime(1000).setCharset("UTF-8").setUserAgent(

             "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_7_2) AppleWebKit/537.31 (KHTML, like Gecko) Chrome/26.0.1410.65 Safari/537.31");;

     @Override

     public Site getSite()

     {

         // TODO Auto-generated method stub

         return site;

     }

     @Override

     public void process(Page page)

     {

         // TODO Auto-generated method stub

         // 列表页

         if (page.getUrl().regex(URL_LIST).match())

         {

             // 从页面发现后续的url地址来抓取

             page.addTargetRequests(page.getHtml().xpath("//div[@class=\"articleList\"]").links().regex(URL_POST).all());

             page.addTargetRequests(page.getHtml().links().regex(URL_LIST).all());

             // 文章页

         } else

         {

             String title = new String();

             String content = new String();

             Article ar = new Article(title, content);

             // 定义如何抽取页面信息,并保存下来

             ar.setTitle(page.getHtml().xpath("//div[@class='articalTitle']/h2/text()").toString());

             ar.setContent(

                     page.getHtml().xpath("//div[@id='articlebody']//div[@class='articalContent']/text()").toString());

             System.out.println("title:"+ar.getTitle());

             System.out.println(ar.getContent());

             page.putField("repo", ar);

 //                    page.putField("date", page.getHtml().xpath("//div[@id='articlebody']//span[@class='time SG_txtc']/text()").regex("\\((.*)\\)"));

         }

     }

 }
 package com.mieba;

 import java.io.FileNotFoundException;

 import java.io.FileWriter;

 import java.io.IOException;

 import java.io.PrintWriter;

 import java.util.Vector;

 import us.codecraft.webmagic.ResultItems;

 import us.codecraft.webmagic.Task;

 import us.codecraft.webmagic.pipeline.Pipeline;

 public class SinaPipeline implements Pipeline

 {

     @Override

     public void process(ResultItems resultItems, Task arg1)

     {

         // TODO Auto-generated method stub

         Article vo = resultItems.get("repo");

         PrintWriter pw = null;

         try

         {

             pw = new PrintWriter(new FileWriter("sina.txt", true));

                 pw.println(vo);

                 pw.flush();

         }catch(FileNotFoundException e) {

             e.printStackTrace();

         }catch (IOException e)

         {

             e.printStackTrace();

         } finally

         {

             pw.close();

         }

     }

 }
 package com.mieba;

 public class Article

 {

 private String title;

 private String content;

 public String getTitle()

 {

     return title;

 }

 public void setTitle(String title)

 {

     this.title = title;

 }

 public String getContent()

 {

     return content;

 }

 public void setContent(String content)

 {

     this.content = content;

 }

 public Article(String title, String content)

 {

     super();

     this.title = title;

     this.content = content;

 }

 @Override

 public String toString()

 {

     return "Article [title=" + title + ", content=" + content + "]";

 }

 }
 package com.mieba;

 import us.codecraft.webmagic.Spider;

 public class Demo

 {

     public static void main(String[] args)

     { // 爬取开始

         Spider

         // 爬取过程

         .create(new SinaPageProcessor())

         // 爬取结果保存

         .addPipeline(new SinaPipeline())

         // 爬取的第一个页面

         .addUrl("http://blog.sina.com.cn/s/articlelist_1487828712_0_1.html")

         // 启用的线程数

         .thread(5).run();

         }

 }
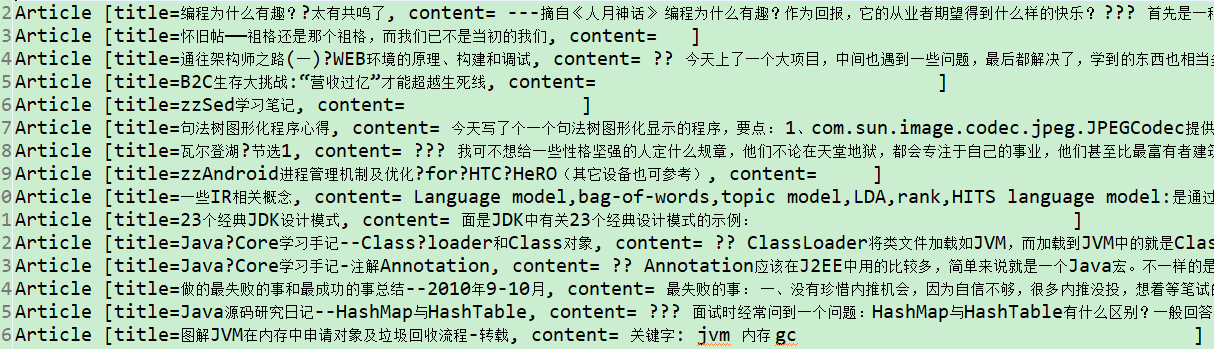
运行结果

爬取到的数据
总结:
关于简单的页面基本可以实现爬取,并且用对象进行存储数据,并最终保存为txt文档。
目前存在的问题,在于一些前端渲染的页面,还找不到url链接去完成相应的爬取,还需要进一步学习模拟登录页面,以获得隐藏的url等数据。
Java爬虫学习(3)之用对象保存新浪微博博文的更多相关文章
- Java爬虫一键爬取结果并保存为Excel
Java爬虫一键爬取结果并保存为Excel 将爬取结果保存为一个Excel表格 官方没有给出导出Excel 的教程 这里我就发一个导出为Excel的教程 导包 因为个人爱好 我喜欢用Gradle所以这 ...
- Java 爬虫学习
Java爬虫领域最强大的框架是JSoup:可直接解析具体的URL地址(即解析对应的HTML),提供了一套强大的API,包括可以通过DOM.CSS选择器,即类似jQuery方式来取出和操作数据.主要功能 ...
- 半途而废的Java爬虫学习经历
最近在面试,发现Java爬虫对于小数据量数据的爬取的应用还是比较广,抽空周末学习一手,留下学习笔记 Java网络爬虫 简单介绍 爬虫我相信大家都应该知道什么,有什么用,主要的用途就是通过程序自动的去获 ...
- 《java JDK7 学习笔记》之对象封装
1.构造函数实现对象初始化流程的封装.方法封装了操作对象的流程.java中还可以使用private封装对象私有数据成员.封装的目的主要就是隐藏对象细节,将对象当做黑箱子进行操作. 2.在java命名规 ...
- Java反射学习-5 - 反射复制对象
通过反射方式复制对象: package cn.tx.reflect; import java.lang.reflect.Constructor; import java.lang.reflect.Fi ...
- Java爬虫学习(2)之用对象保存文件demo(1)
package com.mieba.spider; import java.util.ArrayList; import java.util.List; import java.util.Vector ...
- java web学习总结(十) -------------------HttpServletRequest对象
一.HttpServletRequest介绍 HttpServletRequest对象代表客户端的请求,当客户端通过HTTP协议访问服务器时,HTTP请求头中的所有信息都封装在这个对象中,通过这个对象 ...
- java web学习总结(七) -------------------HttpServletResponse对象(一)
Web服务器收到客户端的http请求,会针对每一次请求,分别创建一个用于代表请求的request对象.和代表响应的response对象.request和response对象即然代表请求和响应,那我们要 ...
- java web 学习十(HttpServletRequest对象1)
一.HttpServletRequest介绍 HttpServletRequest对象代表客户端的请求,当客户端通过HTTP协议访问服务器时,HTTP请求头中的所有信息都封装在这个对象中,通过这个对象 ...
随机推荐
- Jekyll 摘要
在 Windows 上安装 Requirements Permalink Ruby version 2.4.0 or above, including all development headers ...
- opencv图像加文字与运行时间
//获取推断时间 vector<double>layterTimings; double freq = getTickFrequency() / 1000; //得到ms double t ...
- gulp常用插件之gulp-beautify使用
更多gulp常用插件使用请访问:gulp常用插件汇总 gulp-beautify这是一款使用js-beautify进行资产美化插件. 更多使用文档请点击访问gulp-beautify工具官网. 安装 ...
- ovs安装教程
原文链接:https://www.cnblogs.com/goldsunshine/p/10331606.html Open vSwitch系列之二 安装指定版本ovs Open vSwitch系 ...
- HTML/JavaScript实现地图以鼠标为圆心缩放和移动
代码如下 <!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF- ...
- List<SelectListItem> 转为 SelectList
List<SelectListItem> 转为/转换 SelectList SelectList slPayCh = new SelectList(GetPayChannels(),&qu ...
- dva-loading 实践用法
dva 中页面过渡效果封装的很好,下面介绍常用的两个 js 库. 之前对 dva-loading 理解存在误区,认为只要在 index.js 中配置一下就没事了,事实上 dva-loading 只是提 ...
- Fastbin attack
Fastbin Attack 暂时接触到了两种针对堆分配机制中fastbin的攻击方式,double free和house of spirit Double free 基本原理 与uaf是对free之 ...
- Ignatius and the Princess IV HDU - 1029 基础dp
#include<iostream> #include<cstring> #include<cmath> #include<cstdio> #inclu ...
- MySQL8.0.11解压版安装详细教程
1. 从官网下载zip包 官网网址(https://dev.mysql.com/downloads/mysql/) 2. 解压 将压缩包解压到一个目录(后续将此目录作为安装目录),我这里是解压到了D: ...