
Apache Kafka(七)- Kafka ElasticSearch Comsumer
Kafka ElasticSearch Consumer
对于Kafka Consumer,我们会写一个例子用于消费Kafka 数据传输到ElasticSearch。
1. 构造ElasticSearch 基本代码
我们使用如下代码构造一个 Elastic Search Client,并向 ES写入一个index:
import org.apache.http.HttpHost;

import org.apache.http.impl.nio.client.HttpAsyncClientBuilder;

import org.elasticsearch.action.index.IndexRequest;

import org.elasticsearch.action.index.IndexResponse;

import org.elasticsearch.client.RequestOptions;

import org.elasticsearch.client.RestClient;

import org.elasticsearch.client.RestClientBuilder;

import org.elasticsearch.client.RestHighLevelClient;

import org.elasticsearch.common.xcontent.XContentType;

import org.slf4j.Logger;

import org.slf4j.LoggerFactory;

import java.io.IOException;

public class ElasticSearchConsumer {

    public static void main(String[] args) throws IOException {

        Logger logger = LoggerFactory.getLogger(ElasticSearchConsumer.class.getName());

        RestHighLevelClient client = createClient();

        String jsonString = "{\"foo\": \"bar\"}";

        // create an index

        IndexRequest indexRequest = new IndexRequest (

                "kafkademo"

        ).source(jsonString, XContentType.JSON);

        IndexResponse indexResponse = client.index(indexRequest, RequestOptions.DEFAULT);

        String id = indexResponse.getId();

        logger.info(id);

        // close the client

        client.close();

    }

    public static RestHighLevelClient createClient(){

        String hostname = "xxxxx";

        RestClientBuilder builder = RestClient.builder(

                new HttpHost(hostname, 443, "https"))

                .setHttpClientConfigCallback(new RestClientBuilder.HttpClientConfigCallback() {

                    @Override

                    public HttpAsyncClientBuilder customizeHttpClient(HttpAsyncClientBuilder httpAsyncClientBuilder) {

                        return httpAsyncClientBuilder;

                    }

                });

        RestHighLevelClient client = new RestHighLevelClient(builder);

        return client;

    }

}
在 ES 端查看index 以及条目信息:
> curl https://xxx/_cat/indices?v
health status index uuid pri rep docs.count docs.deleted store.size pri.store.size
green open .kibana_1 tQuukokDTbWg9OyQI8Bh4A 1 1 0 0 566b 283b
green open .kibana_2 025DtfBLR3CUexrUkX9x9Q 1 1 0 0 566b 283b
green open kafkademo elXjncvwQPam7dqMd5gedg 5 1 1 0 9.3kb 4.6kb
green open .kibana ZvzR21YqSOi-8nbjffSuTA 5 1 1 0 10.4kb 5.2kb
> curl https://xxx/kafkademo/
{"kafkademo":{"aliases":{},"mappings":{"properties":{"foo":{"type":"text","fields":{"keyword":{"type":"keyword","ignore_above":256}}}}},"settings":{"index":{"creation_date":"1566985949656","number_of_shards":"5","number_of_replicas":"1","uuid":"elXjncvwQPam7dqMd5gedg","version":{"created":"7010199"},"provided_name":"kafkademo"}}}}
2. 向Kafka 生产消息
为了模拟输入到 Kafka 的消息,我们使用一个开源的json-data-generator,github地址如下:
https://github.com/everwatchsolutions/json-data-generator
使用此工具可以很方便地向 Kafka 生产随机的 json数据。
下载此工具后,配置好Kafka broker list地址,启动向Kafka 生产消息:
> java -jar json-data-generator-1.4.0.jar jackieChanSimConfig.json

3. 将消息发往ElasticSearch
在原有Kafka Consumer 的基础上,我们增加以下代码:
// poll for new data

while(true){

    ConsumerRecords<String, String> records =

            consumer.poll(Duration.ofMinutes(100));

    for(ConsumerRecord record : records) {

        // where we insert data into ElasticSearch

        IndexRequest indexRequest = new IndexRequest(

                "kafkademo"

        ).source(record.value(), XContentType.JSON);

        IndexResponse indexResponse = client.index(indexRequest, RequestOptions.DEFAULT);

        String id = indexResponse.getId();

        logger.info(id);

        try {

            Thread.sleep(1000); // introduce a small delay

        } catch (InterruptedException e) {

            e.printStackTrace();

        }

    }

    }
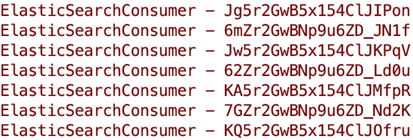
可以看到消息被正常发往ElasticSearch,其中随机字符串为插入ES后的 _id:
Apache Kafka(七)- Kafka ElasticSearch Comsumer的更多相关文章
- Apache Kafka安全| Kafka的需求和组成部分
1.目标 - 卡夫卡安全 今天,在这个Kafka教程中,我们将看到Apache Kafka Security 的概念 .Kafka Security教程包括我们需要安全性的原因,详细介绍加密.有了这 ...
- Apache ZooKeeper在Kafka中的角色 - 监控和配置
1.目标 今天,我们将看到Zookeeper在Kafka中的角色.本文包含Kafka中需要ZooKeeper的原因.我们可以说,ZooKeeper是Apache Kafka不可分割的一部分.在了解Zo ...
- CentOS 7部署Kafka和Kafka集群
CentOS 7部署Kafka和Kafka集群 注意事项 需要启动多个shell脚本交互客户端进行验证,运行中的客户端不要停止. 准备工作: 安装java并设置java环境变量,在`/etc/prof ...
- Spark Streaming + Kafka整合(Kafka broker版本0.8.2.1+)
这篇博客是基于Spark Streaming整合Kafka-0.8.2.1官方文档. 本文主要讲解了Spark Streaming如何从Kafka接收数据.Spark Streaming从Kafka接 ...
- 【Kafka】Kafka集群环境搭建
目录 一.初始环境准备 二.下载安装包并上传解压 三.修改配置文件 四.启动ZooKeeper 五.启动Kafka集群 一.初始环境准备 必须安装了JDK和ZooKeeper,并保证Zookeeper ...
- kafka实战教程(python操作kafka),kafka配置文件详解
kafka实战教程(python操作kafka),kafka配置文件详解 应用往Kafka写数据的原因有很多:用户行为分析.日志存储.异步通信等.多样化的使用场景带来了多样化的需求:消息是否能丢失?是 ...
- Kafka(3)--kafka消息的存储及Partition副本原理
消息的存储原理: 消息的文件存储机制: 前面我们知道了一个 topic 的多个 partition 在物理磁盘上的保存路径,那么我们再来分析日志的存储方式.通过 [root@localhost ~]# ...
- Kafka记录-Kafka简介与单机部署测试
1.Kafka简介 kafka-分布式发布-订阅消息系统,开发语言-Scala,协议-仿AMQP,不支持事务,支持集群,支持负载均衡,支持zk动态扩容 2.Kafka的架构组件 1.话题(Topic) ...
- kafka - Confluent.Kafka
上个章节我们讲了kafka的环境安装(这里),现在主要来了解下Kafka使用,基于.net实现kafka的消息队列应用,本文用的是Confluent.Kafka,版本0.11.6 1.安装: 在NuG ...
随机推荐
- APFS 宗卷 • APFS(加密)磁盘格式怎么去掉?Mac磁盘加密怎么解除?
相信很多朋友都因为APFS 宗卷 • APFS(加密)磁盘格式而困扰,这种磁盘加密,导致很多破解版软件都不能安装.那么磁盘加密怎么解除?小编翻阅了一些教程,为您带来APFS 宗卷 • APFS(加密) ...
- Ubuntu18.04安装mysql(AWS云)
1.执行如下三条命令 sudo apt-get install mysql-server sudo apt install mysql-client sudo apt install libmysql ...
- 0级搭建类007-Ubuntu Desktop Linux安装 (18.04.2) 公开
项目文档引子系列是根据项目原型,制作的测试实验文档,目的是为了提升项目过程中的实际动手能力,打造精品文档AskScuti. 项目文档引子系列目前不对外发布,仅作为博客记录.如学员在实际工作过程中需提前 ...
- 【大道至简】NetCore3.1快速开发框架一:集成Swagger
在上一章节中,我们创建了基本的框架结构:https://www.cnblogs.com/fuyu-blog/p/12217647.html 下面我们测试接口和集成Swagger接口文档 一.接口测试 ...
- Quartz.NET常用方法 02
上一篇里介绍了Job和Trigger的常用方法,这一节将介绍Calendar,它的作用是排除特定的日期时间. Calendar的常用类 DailyCalendar 排除每天某个时间段任务的执行 例 ...
- Python学习笔记三:数据特征分析
完成数据清理后,下面通过图表展开对数据的分析. 1.前期初判(分布分析): 1)判断分组区间: # a.散点图:plt.scatter(data[字段1],data['字段2'], s = data[ ...
- python笔记07
今日内容 深浅拷贝(面试) 文件操作 今日内容 深浅拷贝 v1=[1,2,[34,67,9]] import copy 浅拷贝: 拷贝第一层 v2=copy(v1)---将v1的地址copy,最外层壳 ...
- MySQL的去重+列的表达式
MySQL的去重+列的表达式 1. 去重 作用:去除SELECT查询出来的结果中重复的数据,重复的数据只显示一条. SELECT * FROM `repeat_num` ...
- 原生JS数组操作的6个函数 arr.forEach arr.map arr.filter arr.some arr.every arr.findIndex
<!DOCTYPE html> <html> <head> <meta charset="UTF-8"> <title> ...
- MongoDB geonear和文本命令驱动程序2.0
文本查询,q作为查询字符串: coll.FindAsync<Foo>(Builders<Foo>.Filter.Text(q)); 文本查询需要一个文本索引.要从C#创建代码, ...