
【笔记】机器学习 - 李宏毅 - 5 - Classification
Classification: Probabilistic Generative Model 分类:概率生成模型
如果说对于分类问题用回归的方法硬解,也就是说,将其连续化。比如 \(Class 1\) 对应的目标输出为 1, \(Class 2\) 对应 -1。
则在测试集上,结果更接近1的归为\(Class 1\),反之归为\(Class 2\)。
这样做存在的问题:如果有Error数据的干扰,会影响分类的结果。
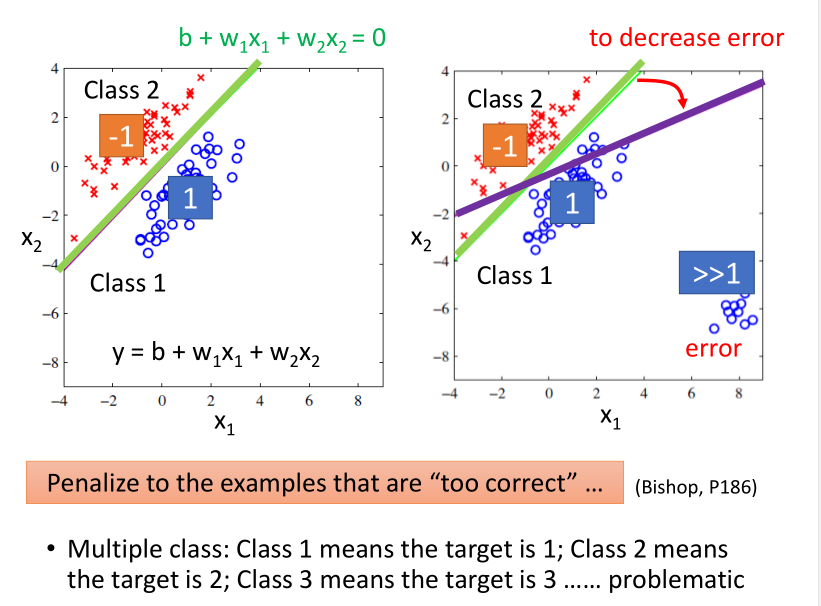
还有就是,如果是多分类问题,则在各类之间增加了线性关系,比如认为 \(Class 3\) 比 $ Class 4$ 离 \(Class 1\) 更近,这是不对的。
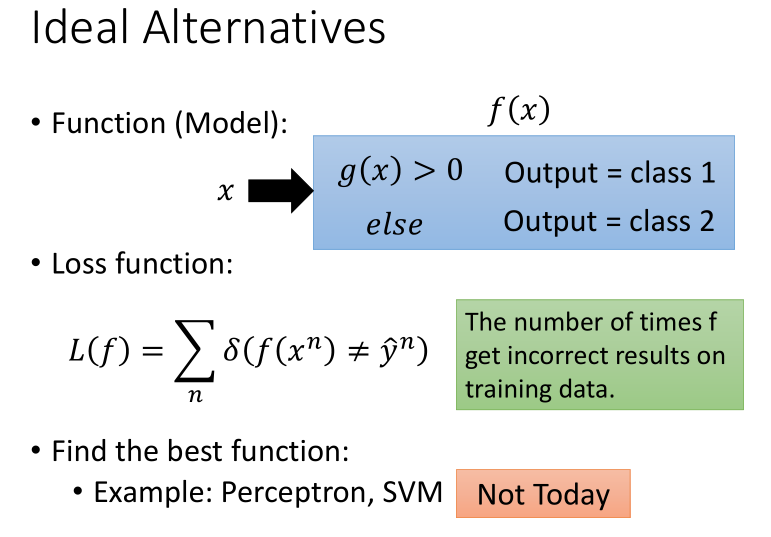
另一种方法是,用\(if\)函数,不过这样的话,虽然分类更合理,但损失函数无法微分计算。
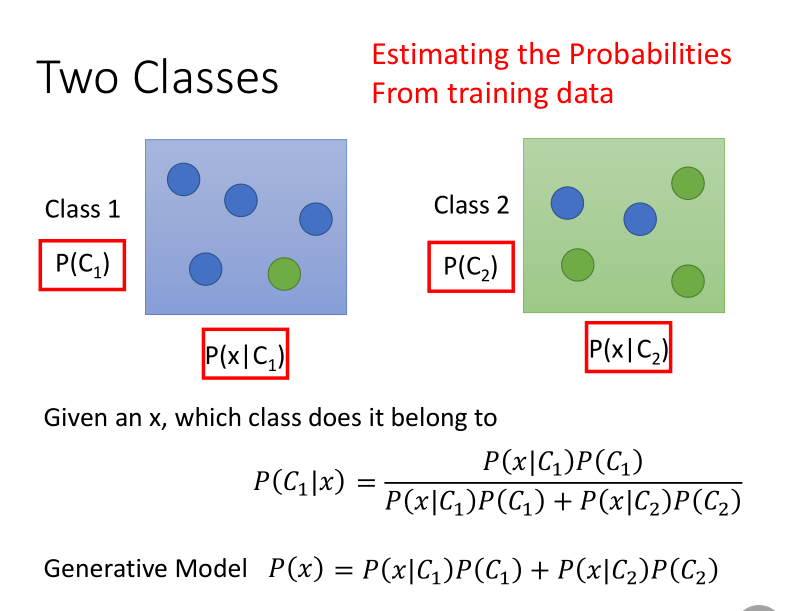
比较好的模型是概率生成模型,通过概率方式计算,(贝叶斯公式)。
其中\(P(C_1)\)和\(P(C_2)\)是先验概率。
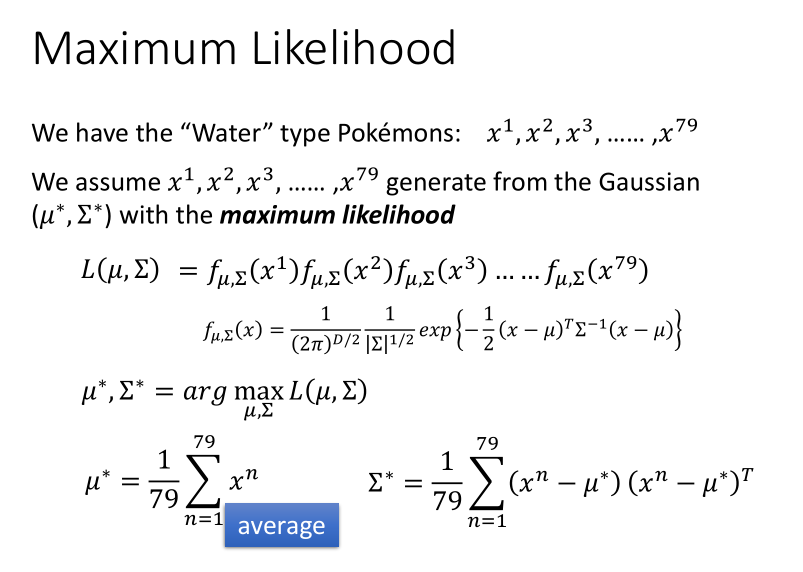
高斯分布,最大似然估计
这里选用高斯分布(其他合理的分布也可以,比如对于二元分类来说,可以假设是符合 Bernoulli distribution(伯努利分布))。
从概率上讲,任何高斯分布都可以产生样本数据,但我们需要的是最大可能性的那种分布,求出它的期望 \(\mu\) 和协方差矩阵 \(\sum\)。
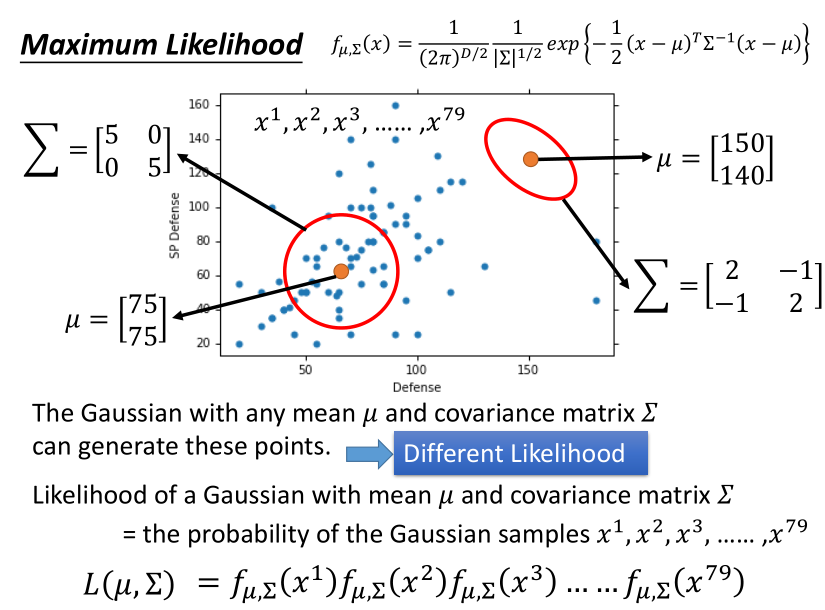
求解方法就是对 \(\mu\)和\(\sum\)分别关于\(L(\mu, \sum)\)求偏微分。
最后得到的结果不是很好,只有47%正确率,即使考虑更多的参数(Overfitting),提升到7维,也只有54%。
如果说,给两个高斯分布相同的协方差矩阵(求加权平均值)的话,效果会好很多,达到了73%。因为分界线是直线,所以也把这种分类叫做线性模型。

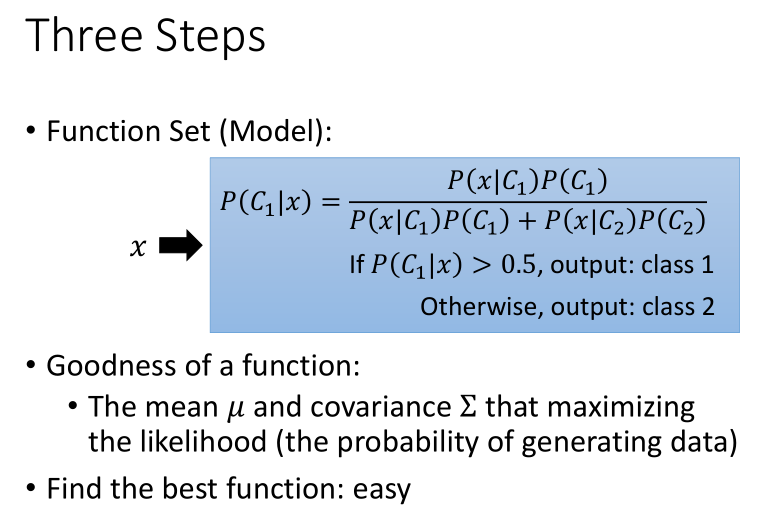
分类问题的机器学习三步骤:
此外,假设每一个维度用概率分布模型产生出来的几率是相互独立的,所以可以将 \(P(x|C_1)\)拆解,可以认为每个 \(P(x_k|C_1)\)产生的概率都符合一维的高斯分布。
也就是此时P(x|C1)的高斯分布的协方差是对角型的(不是对角线的地方值都是0),这样就可以减少参数的量。但是结果显示这种做法不好。
这种假设所有的feature都是相互独立产生的分类叫做 Naive Bayes Classifier(朴素贝叶斯分类器)。

后验概率
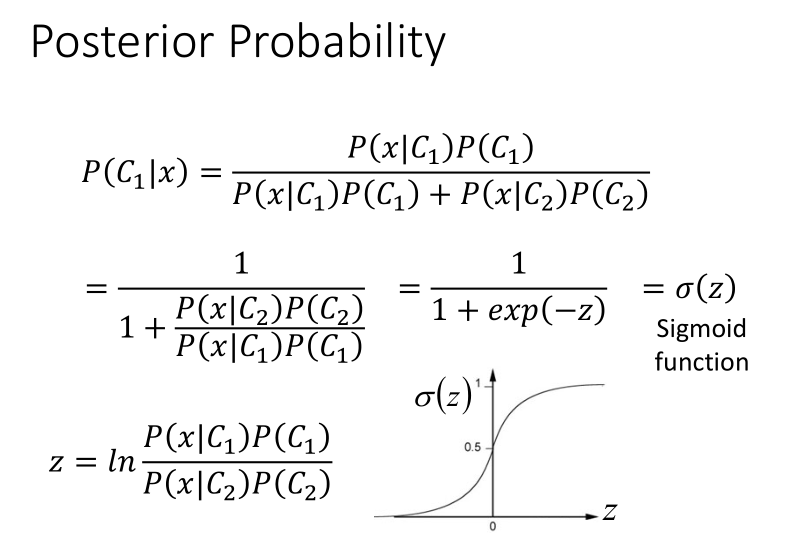
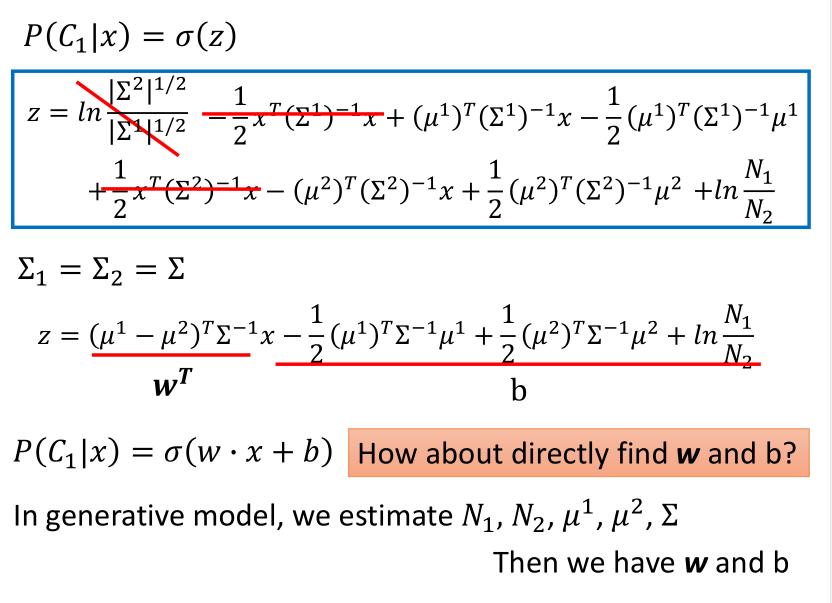
经过一系列数学推导后,最后在形式上转换为了 \(w · x + b\),然后再套一个\(sigmoid\)函数就得到了最后的结果。
所以,在训练时可以直接去求w和b,这在形式上和回归模型又统一了。
【笔记】机器学习 - 李宏毅 - 5 - Classification的更多相关文章
- 深度学习课程笔记(二)Classification: Probility Generative Model
深度学习课程笔记(二)Classification: Probility Generative Model 2017.10.05 相关材料来自:http://speech.ee.ntu.edu.tw ...
- 机器学习笔记P1(李宏毅2019)
该博客将介绍机器学习课程by李宏毅的前两个章节:概述和回归. 视屏链接1-Introduction 视屏链接2-Regression 该课程将要介绍的内容如下所示: 从最左上角开始看: Regress ...
- 【笔记】机器学习 - 李宏毅 - 10 - Tips for Training DNN
神经网络的表现 在Training Set上表现不好 ----> 可能陷入局部最优 在Testing Set上表现不好 -----> Overfitting 过拟合 虽然在机器学习中,很容 ...
- 【笔记】机器学习 - 李宏毅 - 1 - Introduction & next step
Machine Learning == Looking for a Function AI过程的解释:用户输入信息,计算机经过处理,输出反馈信息(输入输出信息的形式可以是文字.语音.图像等). 因为从 ...
- 【笔记】机器学习 - 李宏毅 - 13 - Why Deep
当参数一样多的时候,神经网络变得更高比变宽更有效果.为什么会这样呢? 其实和软件行业的模块化思想是一致的. 比如,如果直接对这四种分类进行训练,长发的男孩数据较少,那么这一类训练得到的classifi ...
- 【笔记】机器学习 - 李宏毅 - 12 - CNN
Convolutional Neural Network CNN 卷积神经网络 1. 为什么要用CNN? CNN一般都是用来做图像识别的,当然其他的神经网络也可以做,也就是输入一张图的像素数组(pix ...
- 【笔记】机器学习 - 李宏毅 - 11 - Keras Demo2 & Fizz Buzz
1. Keras Demo2 前节的Keras Demo代码: import numpy as np from keras.models import Sequential from keras.la ...
- 【笔记】机器学习 - 李宏毅 - 9 - Keras Demo
3.1 configuration 3.2 寻找最优网络参数 代码示例: # 1.Step 1 model = Sequential() model.add(Dense(input_dim=28*28 ...
- 【笔记】机器学习 - 李宏毅 - 8 - Backpropagation
反向传播 反向传播主要用到是链式法则. 概念: 损失函数Loss Function是定义在单个训练样本上的,也就是一个样本的误差. 代价函数Cost Function是定义在整个训练集上的,也就是所有 ...
随机推荐
- 死磕mysql(6)
再写数据库作业的时候,发现了一个问题,如果存在主键外键的约束,数据就删不掉 --set foreign_key_checks=0; 关掉外键约束 用好了再打开 --set foreign_key_ch ...
- Java的Integer与int互转
int转Integer ; Integer wrapperi = new Integer(i); Integer转int ); int i = wrapperi.intValue(); JDK1.5以 ...
- Go语言实现:【剑指offer】替换空格
该题目来源于牛客网<剑指offer>专题. 请实现一个函数,将一个字符串中的每个空格替换成"%20". 例如,当字符串为We Are Happy.则经过替换之后的字符串 ...
- Tomcat安装教程及常见错误解决方法
目录 Tomcat安装教程及常见错误解决方法 一.安装前准备 ·熟悉自己电脑的操作系统版本(32位or64位) ·保证电脑上已经装好JDK,并且已经设置好环境变量. 二.Tomcat安装教程(以Tom ...
- 《Head first设计模式》之外观模式
外观模式提供了一个统一的接口,用来访问子系统中的一群接口.外观定义了一个高层接口,让子系统更容易使用. 我们已经知道适配器模式是如何将一个类的接口转换成另一个符合客户期望的接口的.现在我们要看一个改变 ...
- html input元素的所有type属性
<input /> 属性 type="text" 输入框的类型为文本 type="password" 输入框的类型为密码 type="ra ...
- 论文《Entity Linking with Effective Acronym Expansion, Instance Selection and Topic Modeling》
Entity Linking with Effective Acronym Expansion, Instance Selection and Topic Modeling 一.主要贡献 1. pro ...
- light oj 1095 - Arrange the Numbers排列组合(错排列)
1095 - Arrange the Numbers Consider this sequence {1, 2, 3 ... N}, as an initial sequence of first N ...
- 线段树学习----C语言
/* 线段树学习:如果一个节点为i,那么他的左孩子为2I+1,右孩子为2i+2: */ #include<stdio.h> #define min(a,b) a<b?a:b; ]; ...
- C语言实现双人控制的战斗小游戏
实现功能 1.双人分别控制小人移动 2.子弹碰撞 3.可改变出弹方向 4.血条实体化 前言 这个游戏是看了知乎一位非常好的老师的专栏后练手写的,(至于是哪位,知乎搜C语言小游戏最牛逼的那位) 有老师系 ...