
Python之 爬虫(十二)关于深度优先和广度优先
- 网站的树结构
- 深度优先算法和实现
- 广度优先算法和实现
网站的树结构
通过伯乐在线网站为例子:
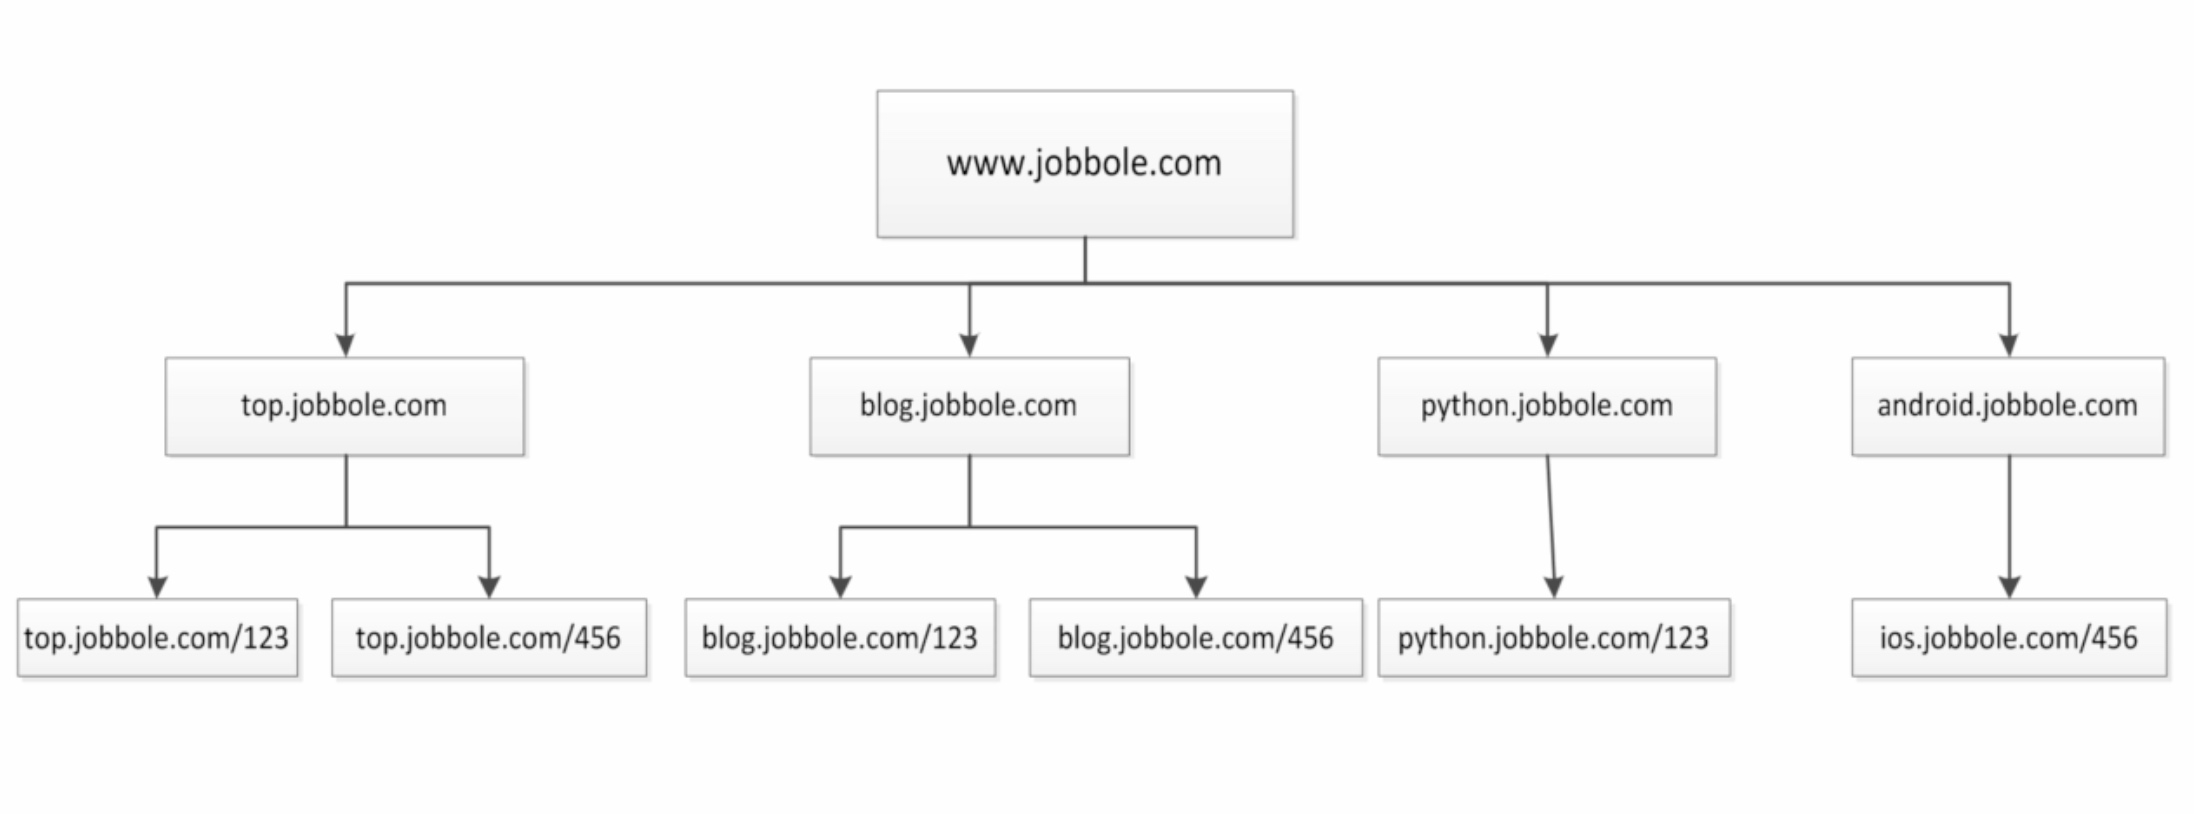
并且我们通过访问伯乐在线也是可以发现,我们从任何一个子页面其实都是可以返回到首页,所以当我们爬取页面的数据的时候就会涉及到去重的问题,我们需要将爬过的url记录下来,我们将上图进行更改

在爬虫系统中,待抓取URL队列是很重要的一部分,待抓取URL队列中的URL以什么样的顺序排队列也是一个很重要的问题,因为这涉及到先抓取哪个页面,后抓取哪个页面。而决定这些URL排列顺序的方法,叫做抓取策略。下面是常用的两种策略:深度优先、广度优先
深度优先
深度优先是指网络爬虫会从起始页开始,一个链接一个链接跟踪下去,处理完这条线路之后再转入下一个起始页,继续追踪链接,通过下图进行理解:
注:scrapy默认采用的是深度优先算法
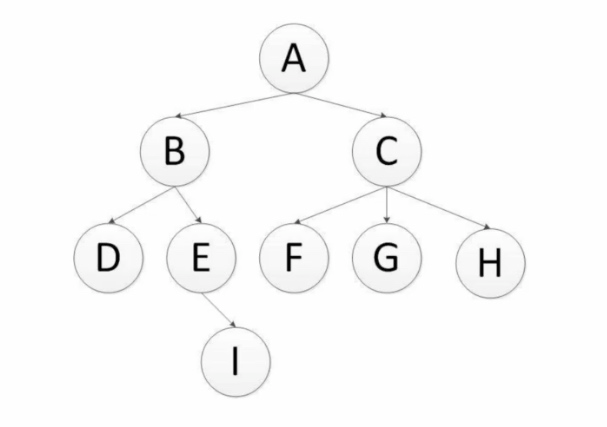
这里是深度优先,所以这里的爬取的顺序式:
A-B-D-E-I-C-F-G-H (递归实现)
深度优先算法的实现(伪代码):

广度优先
广度优先,有人也叫宽度优先,是指将新下载网页发现的链接直接插入到待抓取URL队列的末尾,也就是指网络爬虫会先抓取起始页中的所有网页,然后在选择其中的一个连接网页,继续抓取在此网页中链接的所有网页,通过下图进行理解:

还是以这个图为例子,广度优先的爬取顺序为:
A-B-C-D-E-F-G-H-I (队列实现)
广度优先代码的实现(伪代码):

Python之 爬虫(十二)关于深度优先和广度优先的更多相关文章
- 进击的Python【第十二章】:mysql介绍与简单操作,sqlachemy介绍与简单应用
进击的Python[第十二章]:mysql介绍与简单操作,sqlachemy介绍与简单应用 一.数据库介绍 什么是数据库? 数据库(Database)是按照数据结构来组织.存储和管理数据的仓库,每个数 ...
- python 教程 第二十二章、 其它应用
第二十二章. 其它应用 1) Web服务 ##代码 s 000063.SZ ##开盘 o 26.60 ##最高 h 27.05 ##最低 g 26.52 ##最新 l1 26.66 ##涨跌 c ...
- python 教程 第十二章、 标准库
第十二章. 标准库 See Python Manuals ? The Python Standard Library ? 1) sys模块 import sys if len(sys.argv) ...
- Python简单爬虫入门二
接着上一次爬虫我们继续研究BeautifulSoup Python简单爬虫入门一 上一次我们爬虫我们已经成功的爬下了网页的源代码,那么这一次我们将继续来写怎么抓去具体想要的元素 首先回顾以下我们Bea ...
- python 网络爬虫(二) BFS不断抓URL并放到文件中
上一篇的python 网络爬虫(一) 简单demo 还不能叫爬虫,只能说基础吧,因为它没有自动化抓链接的功能. 本篇追加如下功能: [1]广度优先搜索不断抓URL,直到队列为空 [2]把所有的URL写 ...
- python 网络爬虫(二)
一.编写第一个网络爬虫 为了抓取网站,我们需要下载含有感兴趣的网页,该过程一般被称为爬取(crawling).爬取一个网站有多种方法,而选择哪种方法更加合适,则取决于目标网站的结构. 首先探讨如何安全 ...
- Python爬虫(十二)_XPath与lxml类库
Python学习指南 有同学说,我正则用的不好,处理HTML文档很累,有没有其他的方法? 有!那就是XPath,我们可以用先将HTML文档转换成XML文档,然后用XPath查找HTML节点或元素. 什 ...
- Python之爬虫(二十六) Scrapy登录知乎
因为现在很多网站为了限制爬虫,设置了为只有登录才能看更多的内容,不登录只能看到部分内容,这也是一种反爬虫的手段,所以这个文章通过模拟登录知乎来作为例子,演示如何通过scrapy登录知乎 在通过scra ...
- Python之爬虫(二十五) Scrapy的中间件Downloader Middleware实现User-Agent随机切换
总架构理解Middleware 通过scrapy官网最新的架构图来理解: 这个图较之前的图顺序更加清晰,从图中我们可以看出,在spiders和ENGINE提及ENGINE和DOWNLOADER之间都可 ...
- Python之爬虫(二十四) 爬虫与反爬虫大战
爬虫与发爬虫的厮杀,一方为了拿到数据,一方为了防止爬虫拿到数据,谁是最后的赢家? 重新理解爬虫中的一些概念 爬虫:自动获取网站数据的程序反爬虫:使用技术手段防止爬虫程序爬取数据误伤:反爬虫技术将普通用 ...
随机推荐
- 一个简单的Shell脚本(解决windows上文本在macos上乱码问题)
之所以有这一篇文章,是因为之前我写过的一篇文章:“解决Mac上打开txt文件乱码问题”:传送门: https://www.cnblogs.com/chester-cs/p/11784079.html ...
- 重学 Java 设计模式:实战责任链模式「模拟618电商大促期间,项目上线流程多级负责人审批场景」
作者:小傅哥 博客:https://bugstack.cn - 原创系列专题文章 沉淀.分享.成长,让自己和他人都能有所收获! 一.前言 场地和场景的重要性 射击
- Java深拷贝和浅拷贝的区别
浅拷贝 被复制的对象的所有的变量都与原对象有相同的值,而所有的引用对象仍然指向原来的对象.换言之,浅拷贝 不复制引用对象. 1 class Experience { 2 private String ...
- Elasticsearch修改分词器以及自定义分词器
Elasticsearch修改分词器以及自定义分词器 参考博客:https://blog.csdn.net/shuimofengyang/article/details/88973597
- elasticSearch插件的安装以及使用nginx的modles收集nginx的日志
1.首先在windows环境上搭建es的集群 集群的配置如下 #node01的配置: cluster.name: es-itcast-cluster node.name: node01 node.ma ...
- Spring事务深入剖析--spring事务失效的原因
之前我们讲的分布式事务的调用都是在一个service中的事务方法,去调用另外一个service中的业务方法, 如果在一个sevice中存在两个分布式事务方法,在一个seivice中两个事务方法相互嵌套 ...
- 发布Nuget包时遇到都意外
准备好工具和发布教程.(这些网上都有,我就不说了,就说说我遇到都意外.) 在发布包都过程中,我给我都dll命名为Common.不知道是不是这个原因导致的我包发布上去后,程序对其引用时居然没主动引用进程 ...
- java-IO流(commons-io-2.6)使用教程
工具库下载: https://pan.baidu.com/s/1tXXF4zjIfJ9ouObsU5RTpA 提取码:214v 1.打开IDEA 2.在模块下新建个lib文件夹将框架复制进去 3.点 ...
- ArrayList类的使用
ArrayList常用类方法 (1)添加元素 public boolean add(E element) 在集合末端添加一个元素 public void add(int index,E element ...
- 使用 Prometheus-Operator 监控 Calico
原文链接:https://fuckcloudnative.io/posts/monitoring-calico-with-prometheus-operator/ Calico 中最核心的组件就是 F ...