
RabbitMQ与Kafka选型对比
背景
本公司是.Net项目,在.Net可选的MQ比较少,主要Kafka和RabbitMQ,RabbitMQ我也是使用多年了,最近的Kafka广告与流行度打得使我也是无法无视,因此也是花了点时间收集了资料做了些对比。
此外有个小插曲,当我形成了文档让老板兼CTO对比决策后,他打算上阿里云买MQ服务。我当时给他开了个玩笑:您这价钱把我请回来,而且公司还有运维,其实完全可以自己维护,要不我来负责,你把这每个月的MQ费用给我加工资得了。当我下楼买了支维他柠檬茶后,他决定由我们自己搭建RabbitMQ。这个决定跟我的想法差不多,原因主要两点:运维起来方便,吞吐没有特别高。
RabbitMQ模型
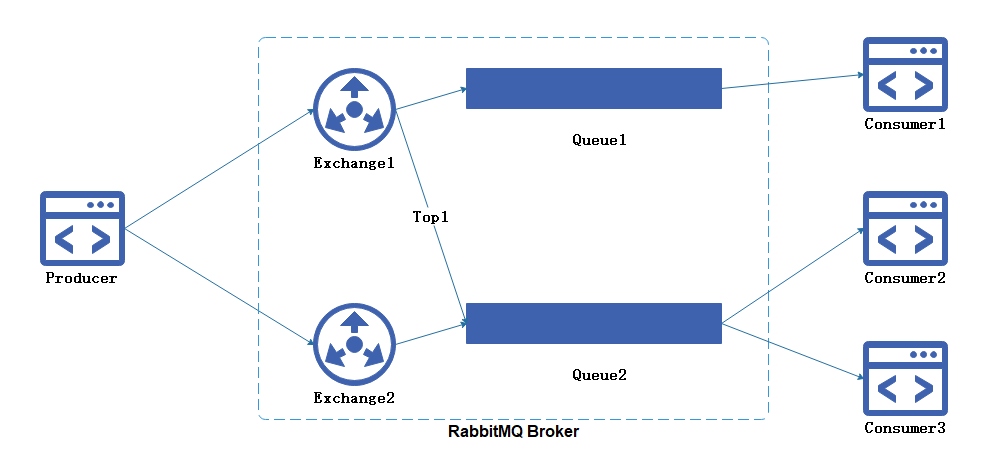
| 名词 | 描述 |
| Queue | 用于存储消息,消费者直接绑定Queue进行消费消息 |
| Exchange | 生产者将消息发送到Exchange,由交换器将消息通过匹配Exchange Type、Binding Key、Routing Key后路由到一个或者多个队列中。 |
| Exchange Type | Direct、Fanout、Topic、Headers |
| Routing Key | 生产者发送消息给Exchange会指定一个Routing Key。 |
| Binding Key | 在绑定Exchange与Queue时会指定一个Binding Key |
- Exchange在声明时会绑定Queue和Binding Key,当Exchange收到消息会根据消息的
- Routing Key与Exchange Type、Binding Key进行匹配,最后会路由到相关的队列当中。
- Fanout,将消息发送到与该交换器所绑定的所有队列中,与Routing Key、Bind Key无关,这就是广播模式。
- Topic,通过对消息的Routing Key和Exchange、Queue进行匹配,将消息路由给一个或多个队列,以此来达到发布/订阅模式。
- Direct,把消息路由到哪些Bind Key和Routing Key完全匹配的队列中。
- Headers,不依赖与路由键的匹配规则,基本用不上。
- 消费者会直接订阅Queue里的消息进行消费,多个消费者订阅同个Queue会形成消息竞争状态,以此达到负载均衡作用。
Kafka模型
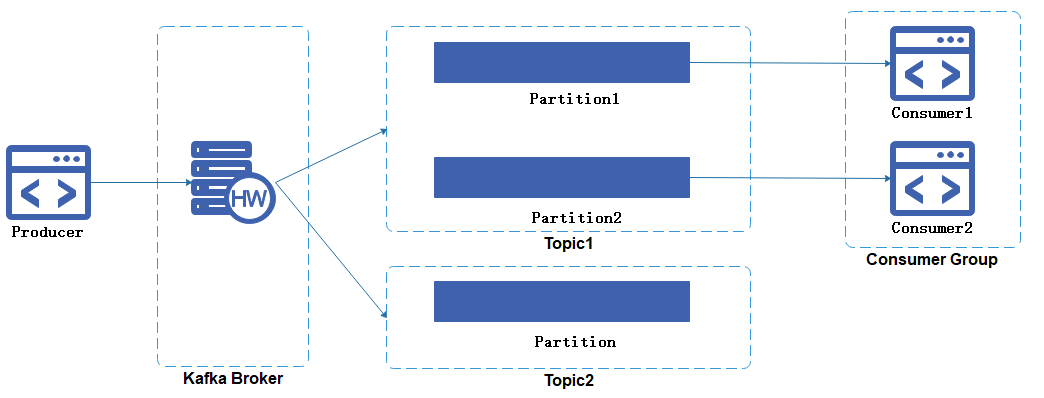
| 名词 | 描述 |
| Topic | 队列是通过Topic进行隔离的,生产者发送消息必须指定Topic |
| Broker | 一个Kafka Server的被称为一个Broker。 |
| Partition | 每个Topic可以包含多个Partition,多个Partition会平均分配给同一个Consumer Group里的不同Consumer进行消费 |
| Consumer Group | 不在同一个Group 的Consumer能重复消费同一条消息(订阅),相同Group的Consumer存在消费竞争(负载均衡) |
- Kafka与RabbitMQ比没有Exchange的概念,生产者直接发消息Topic(队列)。
- Kafka的订阅者是通过消费组(Consumer Group)来体现的,每个消费组都可以重复消费Topic一份完整的消息,不同消费组之间消费进度彼此不受影响。例如Message1能被Consumer Group 1和Consumer Group2里的消费者都消费一次。
- 消费组中包含多个消费者,同个Group的消费者之间是竞争消费的关系。例如Message2只能够被Consumer Group里某一个Consumer只消费一次。
- Kafka具有消息存储的功能,消息被消费后不会被立即删除,因为需要被不同的Consumer Group多次消费同个消息,因此会在Topic维护一个Consumer Offset,每消费成功Offset自增1.
功能对比
| 对比项 | RabbitMQ | Kafka |
| 吞吐量 | 低 | 高 |
| 有序性 | 全局有序性 | 分区有序性 |
| 消息可靠性 | 多策略组合 | 消息持久化 |
| 流处理 | 不支持 | 支持 |
| 时效性 | 高 | 中 |
| 运维便捷度 | 高 | 中 |
| 系统依赖 | 无 | zookeeper |
| Web监控 | 自带 | 第三方 |
| 优先级队列 | 支持 | 不支持 |
| 死信 | 支持 | 不支持 |
| 客户端支持 | 支持多种语言 | |
| 社区生态 | 好 | |
| 安全机制 | (TLS/SSL、SASL)身份认证和(读写)权限控制 | |
| 消息回溯 | 支持 | 不支持 |
对比描述
共同点
RabbitMQ与Kafka都有很好的客户端语言支持、安全机制与生态支持。
性能
Kafka的诞生的是处理高并发日志的,吞吐量比较高,每秒请求数达到数十万量级,而RabbitMQ每秒请求数则为万级别,有测试报告指出Kafka是RabbitMQ的10倍以上性能。
运维便捷
RabbitMQ相对比较方便,可以使用yum或者docker安装,自带Web管理UI,没有额外的依赖,除了需要做镜像队列外需要引入HAproxy。
Kafka则需要依赖Zookeeper,也没有自带的管理工具,可以使用第三方的Kafka Eagle代替,Kafka Manager过于难用,另外Kafka没有yum安装,docker镜像也是社区人员自己建的。
有序性
RabbitMQ理论上是全局有序性的,但是由于【发后既忘】+【自动确认】机制的原因,如果在同个队列的多个消费者做相同的业务处理时,他们的各自的执行任务无法保证有序完成。如果确保100%有序可以使用【非自动确认】,但会影响消费性能。
Kafka支持分区有序性,如果对有序性有严格要求可以设置单个Partition,可是单个Partition并发性比较低,因此在多个Partition情况下可以根据业务指定key把相关的消息路由到同一个Partition,例如相同UserId行为信息可以到Partition 1进行处理。
时效性
Kafka基本上无论在客户端还是服务端都是以【异步批量】的机制进行处理,通俗的讲就是先攒起来一堆消息,到了某个阀值再发送,也会导致一些消息可靠性与消息有时效上的问题,当然可以通过各种配置策略进行解决。
消息回溯
Kafka在消费完了消息后不会立即删除,只会修改offset,如果之前部分业务消费失败了可以重新设置offset进行重新消费。
RabbitMQ则是[发后既忘]的机制,一但消费者确认消息则删除,但是可以通过死信进行补偿消费。此外RabbitMQ在队列消息堆积多的情况下性能表现不佳,所以尽可能的及时消费消息。
特色功能
RabbitMQ具有死信的功能,可以通过死信形成重复消费与延时发送。
Kafka具有流处理功能,可以收集用户的行为日志进行存储与分析。
Kafka为什么快?
关键核心技术点:
- 异步批量处理
- 磁盘顺序读写
- 操作系统PageCache缓存数据
- 零拷贝加速消费
Kafka的诞生就是为了高并发日志处理的,那么在他整个机制里使用了很多批量、异步、缓存。例如生产者客户端,他会积累一定量(条数、大小)的消息,再批量的发给kafka broker,如果在这段时间客户端服务挂了,就等于消息丢失了。当broker接受到了消息后,还有一堆骚操作-异步刷盘,也就是生产者发送给broker之后他是记录在缓存的,每隔一段时间才会持久化到磁盘,假如这段真空期broker挂了,消息也是丢了。
Kafka是否消息不可靠?
Kafka快是因为牺牲了消息可靠换取回来的性能,在最早期版本的确没提供消息可靠的策略,经过多个版本迭代后的功能完善,已经不存在这种旧观念。那么可靠的关键点有以下:
生产者
设置ack:
- 0:producer不等待broker的ack,broker一接收到还没有写入磁盘就已经返回,可靠性最低;
- 1:producer等待broker的ack,partition的leader刷盘成功后返回ack,如果在follower同步成功之前leader故障,那么将会丢失数据,可靠性中;
- -1:producer等待broker的ack,partition的leader和follower全部落盘成功后才返回ack,数据一般不会丢失,延迟时间长但是可靠性高
消费者
设置enable.auto.commitrue,不管执行结果如何,消费者会自动提交offset。
RabbitMQ单节点部署
安装
yum install -y rabbitmq-server
开放相关端口
firewall-cmd --permanent --add-port=15672/tcp

firewall-cmd --permanent --add-port=5672/tcp

firewall-cmd --reload
启动服务
service rabbitmq-server start
启动web管理界面
rabbitmq-plugins enable rabbitmq_management
增加访问admin用户,默认用户guest只能本地访问。
rabbitmqctl add_user admin 123456
设置admin用户为管理员角色
rabbitmqctl set_user_tags admin administrator
设置默认admin用户访问权限
rabbitmqctl set_permissions -p "/" admin "." "." ".*"
重启服务
service rabbitmq-server restart
浏览器访问:http://IP:15672
Kafka单节点部署
Zookeeper部署
下载Zookeeper并启动
docker run -d --restart always --name zookeeper -p 2181:2181 -v /root/zookeeper/data:/data -v /root/zookeeper/conf:/conf -v /root/zookeeper/logs:/logs zookeeper:3.6.1
开放2181端口
firewall-cmd --permanent --add-port=2181/tcp

firewall-cmd --reload
Kafka服务部署
下载kafka 镜像并启动
docker run -d --name kafka -p 9092:9092 -e KAFKA_BROKER_ID=1 -e KAFKA_ZOOKEEPER_CONNECT=192.168.88.139:2181 -e KAFKA_ADVERTISED_HOST_NAME=192.168.88.141 -e KAFKA_ADVERTISED_PORT=9092 wurstmeister/kafka:2.12-2.5.0
创建目录并拷贝
mkdir /root/kafka

docker cp kafka:/opt/kafka/config /root/kafka/config
删除原有的容器并重新创建
docker stop kafka

docker rm kafka

docker run -d --name kafka -p 9092:9092 -e KAFKA_BROKER_ID=1 -e KAFKA_ZOOKEEPER_CONNECT=192.168.88.139:2181 -e KAFKA_ADVERTISED_HOST_NAME=192.168.88.141 -e KAFKA_ADVERTISED_PORT=9092 -v /root/kafka/config: /opt/kafka/config wurstmeister/kafka:2.12-2.5.0
开放9092端口
firewall-cmd --permanent --add-port=9092/tcp

firewall-cmd --reload
Kafka-eagle
下载jdk依赖
yum -y install java-1.8.0-openjdk*
下载kafka-eagle-bin包
wget -o kafka-eagle-bin.tar.gz https://codeload.github.com/smartloli/kafka-eagle-bin/tar.gz/v2.0.1
解压
tar -zxvf kafka-eagle-bin.tar.gz

tar -zxvf kafka-eagle-bin-2.0.1/kafka-eagle-web-2.0.1-bin.tar.gz

mv kafka-eagle-web-2.0.1 kafka-eagle
添加环境变量
vim /etc/profile

export JAVA_HOME=/usr

export KE_HOME=/etc/kafka-eagle

export PATH=$PATH:$KE_HOME/bin:$JAVA_HOME/bin
生效环境变量
source /etc/profile
修改Kafka-eagle配置
cd /etc/kafka-eagle/conf

vim system-config.properties

#注释

#cluster2.zk.list=xdn10:2181,xdn11:2181,xdn12:2181

#cluster2.kafka.eagle.offset.storage=zk

#cluster1.zk.acl.enable=false

#cluster1.zk.acl.schema=digest

#cluster1.zk.acl.username=test

#cluster1.zk.acl.password=test123

修改

kafka.eagle.zk.cluster.alias=cluster1

cluster1.zk.list=192.168.88.139:2181

kafka.eagle.metrics.charts=true

kafka.eagle.driver=org.sqlite.JDBC

kafka.eagle.url=jdbc:sqlite:/etc/kafka-eagle/db/ke.db

kafka.eagle.username=root

kafka.eagle.password=root
启动kafka-eagle服务
cd /etc/kafka-eagle/bin

chmod +x ke.sh

ke.sh start
开启防火墙
firewall-cmd --permanent --add-port=8048/tcp

firewall-cmd --reload
浏览器访问:http://IP:8048
阿里云费用
以下截图基本以最低配置。
Kafka按量付费

Kafka包月

RabbitMQ包月

RabbitMQ与Kafka选型对比的更多相关文章
- RabbitMQ 和 Kafka
============================RabbitMQ 术语============================RabbitMQ 有很多术语和Kafka不一样, 理解这些术语十分 ...
- 消息中间件面试题31道RabbitMQ+ActiveMQ+Kafka
消息中间件面试题31道RabbitMQ+ActiveMQ+Kafka 前言 文章开始前,我们先了解一下什么是消息中间件? 什么是中间件? 非底层操作系统软件,非业务应用软件,不是直接给最终用户使用的, ...
- MQ选型对比ActiveMQ,RabbitMQ,RocketMQ,Kafka 消息队列框架选哪个?
最近研究消息队列,发现好几个框架,搜罗一下进行对比,说一下选型说明: 1)中小型软件公司,建议选RabbitMQ.一方面,erlang语言天生具备高并发的特性,而且他的管理界面用起来十分方便.不考虑r ...
- 我为什么要选择RabbitMQ ,RabbitMQ简介,各种MQ选型对比(转载)
转载自:https://www.sojson.com/blog/48.html 前言: MQ 是什么?队列是什么,MQ 我们可以理解为消息队列,队列我们可以理解为管道.以管道的方式做消息传递. 场景: ...
- 为什么要选择RabbitMQ ,RabbitMQ简介,各种MQ选型对比
原文:https://www.sojson.com/blog/48.html 前言: MQ 是什么?队列是什么,MQ 我们可以理解为消息队列,队列我们可以理解为管道.以管道的方式做消息传递. 场景: ...
- RabbitMQ和Kafka对比
# 前言 开源社区有好多优秀的队列中间件,比如RabbitMQ和Kafka,每个队列都貌似有其特性,在进行工程选择时,往往眼花缭乱,不知所措.对于RabbitMQ和Kafka,到底应该选哪个? # R ...
- MQ选型对比RabbitMQ RocketMQ ActiveMQ
原文:MQ选型对比RabbitMQ RocketMQ ActiveMQ 几种MQ产品说明: ZeroMQ : 扩展性好,开发比较灵活,采用C语言实现,实际上他只是一个socket库的重新封装 ...
- RabbitMQ和Kafka对比以及场景使用说明
我目前的项目最后使用的是RabbitMQ,这里依然是结合网上大神们的优秀博客,对kafka和rabbitmq进行简单的比对.最后附上参考博客. 1.架构模型 rabbitmq RabbitMQ遵循AM ...
- RabbitMQ 和 Kafka 的消息可靠性对比
RabbitMQ和Kafka都提供持久的消息保证.两者都提供至少一次和至多一次的保证,另外,Kafka在某些限定情况下可以提供精确的一次(exactly-once)保证. 让我们首先理解一下上述术语的 ...
随机推荐
- C语言基础练习——打印乘法口诀表
C语言基础练习--打印乘法口诀表 JERRY_Z. ~ 2020 / 8 / 26 转载请注明出处! 代码: /* * @Author: JERRY_Z. * @Date: 2020-08-26 16 ...
- 使用 Python破解大众点评字体加密(SVG反扒)
前言 大众点评拥有大量高质量评论信息.种草信息,同时也有非常严格的反扒机制. 今天我们一起使用 Python破解大众点评字体加密,获取极具商业价值的信息. 本文知识点: requests 的使用 xp ...
- 架构设计 | 基于电商交易流程,图解TCC事务分段提交
本文源码:GitHub·点这里 || GitEE·点这里 一.场景案例简介 1.场景描述 分布式事务在业务系统中是十分常见的,最经典的场景就是电商架构中的交易业务,如图: 客户端通过请求订单服务,执行 ...
- Flink从入门到入土(详细教程)
和其他所有的计算框架一样,flink也有一些基础的开发步骤以及基础,核心的API,从开发步骤的角度来讲,主要分为四大部分 1.Environment Flink Job在提交执行计算时,需要首先建立和 ...
- CobaltStrike与Metasploit联动配合
利用CobaltStrike内置Socks功能 通过Beacon内置的Socks功能在VPS上开启代理端口,打通目标内网通道,之后将本地Metasploit直接带入目标内网,进行横向渗透. 首先,到已 ...
- xml selectnodes
[xML ]SelectNodes的用法 之前简单找个SelectNodes的例子看了看,写了读取XML文件节点的程序,但是节点数目有限制,后来仔细看看,是自己没完全弄清SelectNodes的用法, ...
- Zabbix-4.0-设置钉钉报警脚本
问题:当服务器发生报错时,有一个信息能实现自动发送到我的手机或者应用上,以达到对服务器的实时的监控与处理.邮件与短信不能满足实时性,于是想到了钉钉的通知. 思路:在钉钉里面建一个群,群里面拉个机器人. ...
- MAC 上编译安装nginx-rtmp-module 流媒体服务器
MAC 上编译安装nginx-rtmp-module 流媒体服务器 记录踩坑过程 下载nginx和nginx-rtmp-module wget http://nginx.org/download/ng ...
- [BUUOJ记录] [强网杯 2019]随便注(三种方法)
本题主要考察堆叠注入,算是比较经典的一道题,在i春秋GYCTF中也出现了本题的升级版 猜测这里的MySQL语句结构应该是: select * from words where id='$inject' ...
- CSS中的包含块
1.初始包含块,浏览器viewport大小 2.非根元素,position:relative/static,包含块为最近的块级框,表格单元或行内祖先框的内容区 3.非根元素,position:abso ...