
(数据科学学习手札97)掌握pandas中的transform
本文示例文件已上传至我的
Github仓库https://github.com/CNFeffery/DataScienceStudyNotes
1 简介
开门见山,在pandas中,transform是一类非常实用的方法,通过它我们可以很方便地将某个或某些函数处理过程(非聚合)作用在传入数据的每一列上,从而返回与输入数据形状一致的运算结果。
本文就将带大家掌握pandas中关于transform的一些常用使用方式。
 图1
2 pandas中的transform
在pandas中transform根据作用对象和场景的不同,主要可分为以下几种:
2.1 transform作用于Series
当transform作用于单列Series时较为简单,以前段时间非常流行的企鹅数据集为例:
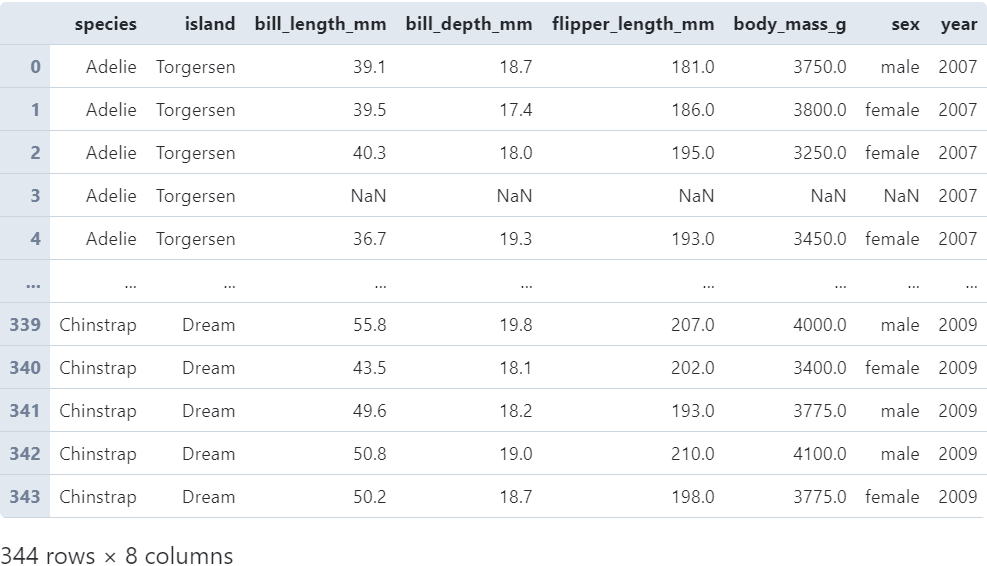 图2
我们在读入数据后,对bill_length_mm列进行transform变换:
- 单个变换函数
我们可以传入任意的非聚合类函数,譬如对数化:
# 对数化

penguins['bill_length_mm'].transform(np.log)
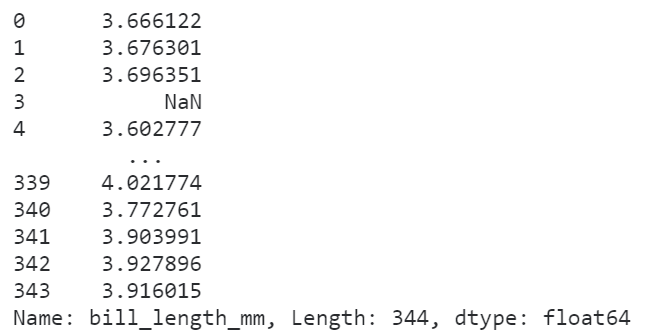 图3
或者传入lambda函数:
# lambda函数

penguins['bill_length_mm'].transform(lambda s: s+1)
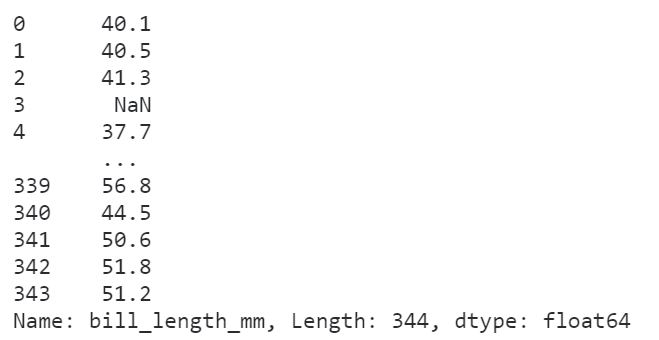 图4
- 多个变换函数
也可以传入包含多个变换函数的列表来一口气计算出多列结果:
penguins['bill_length_mm'].transform([np.log,

                                      lambda s: s+1,

                                      np.sqrt])
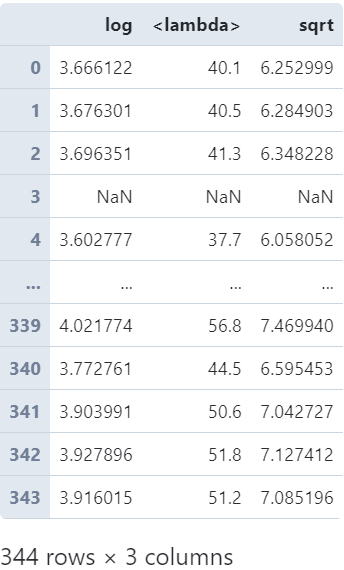 图5
而又因为transform传入的函数,在执行运算时接收的输入参数是对应的整列数据,所以我们可以利用这个特点实现诸如数据标准化、归一化等需要依赖样本整体统计特征的变换过程:
# 利用transform进行数据标准化

penguins['bill_length_mm'].transform(lambda s: (s - s.mean()) / s.std())
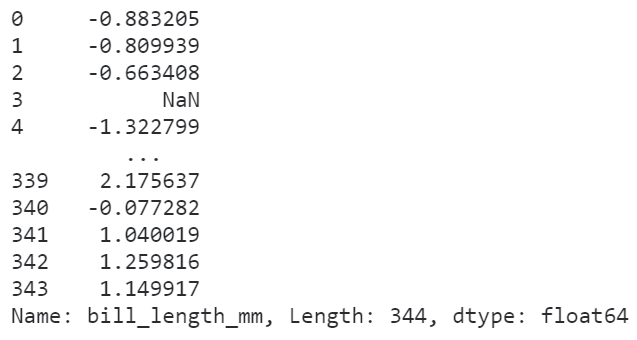 图6
2.2 transform作用于DataFrame
当transform作用于整个DataFrame时,实际上就是将传入的所有变换函数作用到每一列中:
# 分别对每列进行标准化

(

    penguins

    .loc[:, 'bill_length_mm': 'body_mass_g']

    .transform(lambda s: (s - s.mean()) / s.std())

)
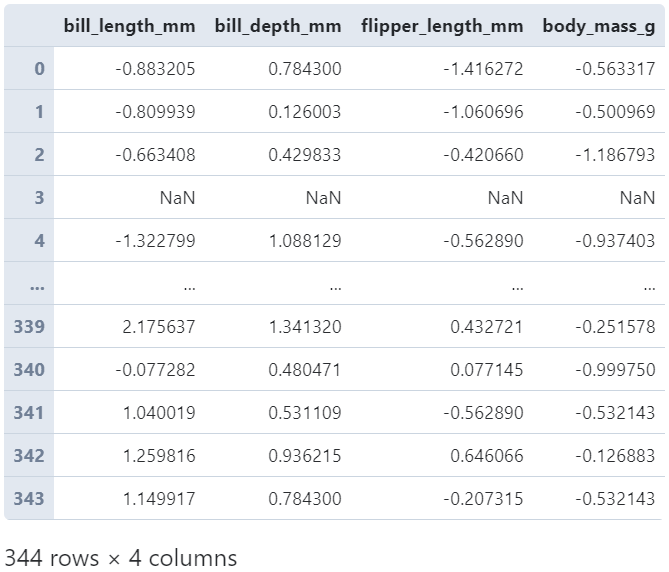 图7
而当传入多个变换函数时,对应的返回结果格式类似agg中的机制,会生成MultiIndex格式的字段名:
(

    penguins

    .loc[:, 'bill_length_mm': 'body_mass_g']

    .transform([np.log, lambda s: s+1])

)
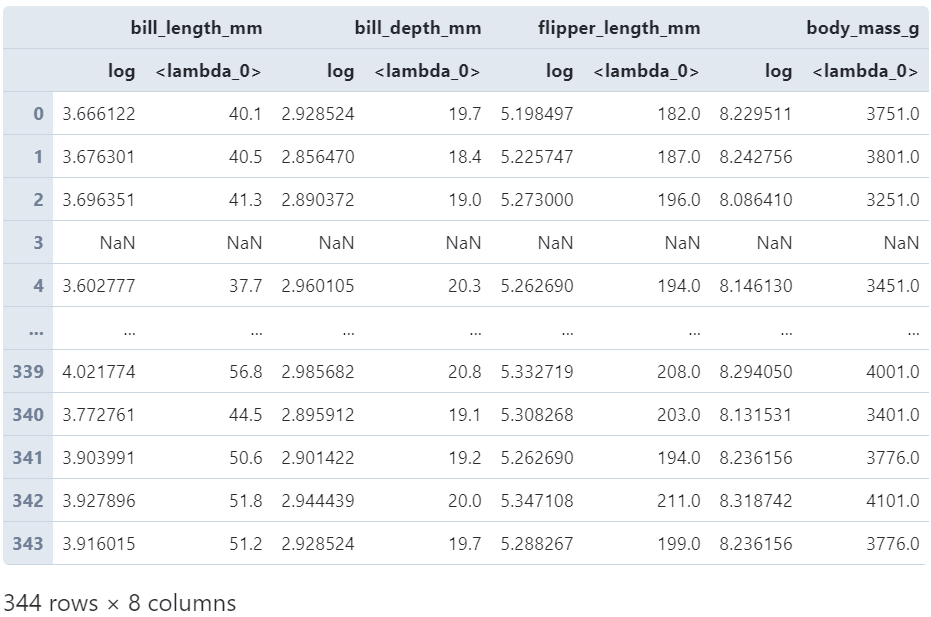 图8
而且由于作用的是DataFrame,还可以利用字典以键值对的形式,一口气为每一列配置单个或多个变换函数:
# 根据字典为不同的列配置不同的变换函数

(

    penguins

    .loc[:, 'bill_length_mm': 'body_mass_g']

    .transform({'bill_length_mm': np.log,

                'bill_depth_mm': lambda s: (s - s.mean()) / s.std(),

                'flipper_length_mm': np.log,

                'body_mass_g': [np.log, np.sqrt]})

)
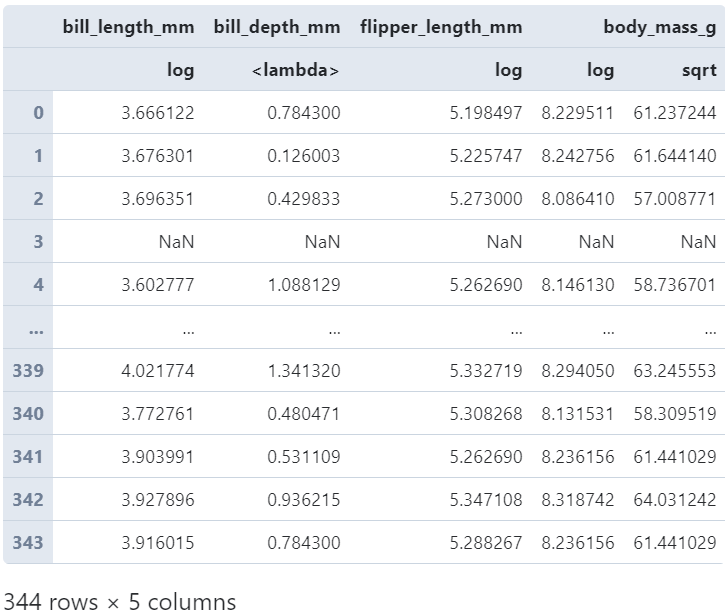 图9
2.3 transform作用于DataFrame的分组过程
在对DataFrame进行分组操作时,配合transform可以完成很多有用的任务,譬如对缺失值进行填充时,根据分组内部的均值进行填充:
# 分组进行缺失值均值填充

(

    penguins

    .groupby('species')[['bill_length_mm', 'bill_depth_mm',

                         'flipper_length_mm', 'body_mass_g']]

    .transform(lambda s: s.fillna(s.mean().round(2)))

)
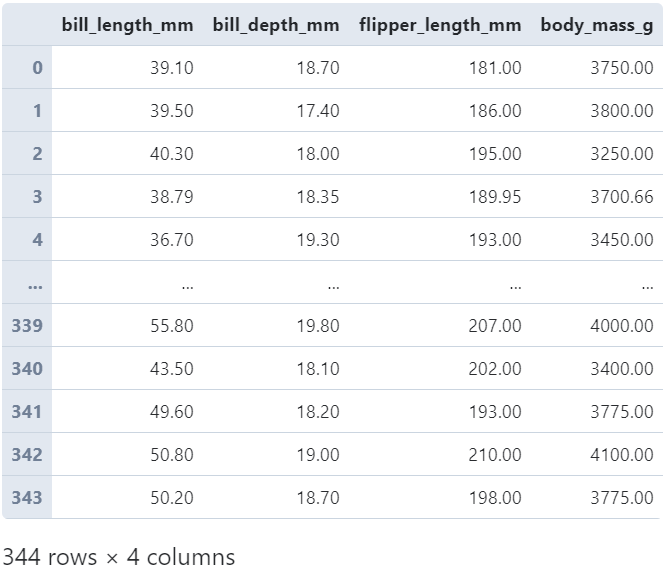 图10
并且在pandas1.1.0版本之后为transform引入了新特性,可以配合Cython或Numba来实现更高性能的数据变换操作,详细的可以阅读( https://github.com/pandas-dev/pandas/pull/32854 )了解更多。
除了以上介绍的内容外,transform还可以配合时间序列类的操作譬如resample等,功能都大差不差,感兴趣的朋友可以自行了解。
以上就是本文的全部内容,欢迎在评论区与我进行讨论
(数据科学学习手札97)掌握pandas中的transform的更多相关文章
- (数据科学学习手札131)pandas中的常用字符串处理方法总结
本文示例代码及文件已上传至我的Github仓库https://github.com/CNFeffery/DataScienceStudyNotes 1 简介 在日常开展数据分析的过程中,我们经常需要对 ...
- (数据科学学习手札52)pandas中的ExcelWriter和ExcelFile
一.简介 pandas中的ExcelFile()和ExcelWriter(),是pandas中对excel表格文件进行读写相关操作非常方便快捷的类,尤其是在对含有多个sheet的excel文件进行操控 ...
- (数据科学学习手札68)pandas中的categorical类型及应用
一.简介 categorical是pandas中对应分类变量的一种数据类型,与R中的因子型变量比较相似,例如性别.血型等等用于表征类别的变量都可以用其来表示,本文就将针对categorical的相关内 ...
- (数据科学学习手札49)Scala中的模式匹配
一.简介 Scala中的模式匹配类似Java中的switch语句,且更加稳健,本文就将针对Scala中模式匹配的一些基本实例进行介绍: 二.Scala中的模式匹配 2.1 基本格式 Scala中模式匹 ...
- (数据科学学习手札32)Python中re模块的详细介绍
一.简介 关于正则表达式,我在前一篇(数据科学学习手札31)中已经做了详细介绍,本篇将对Python中自带模块re的常用功能进行总结: re作为Python中专为正则表达式相关功能做出支持的模块,提供 ...
- (数据科学学习手札124)pandas 1.3版本主要更新内容一览
本文示例代码及文件已上传至我的Github仓库https://github.com/CNFeffery/DataScienceStudyNotes 1 简介 就在几天前,pandas发布了其1.3版本 ...
- (数据科学学习手札25)sklearn中的特征选择相关功能
一.简介 在现实的机器学习任务中,自变量往往数量众多,且类型可能由连续型(continuou)和离散型(discrete)混杂组成,因此出于节约计算成本.精简模型.增强模型的泛化性能等角度考虑,我们常 ...
- (数据科学学习手札19)R中基本统计分析技巧总结
在获取数据,并且完成数据的清洗之后,首要的事就是对整个数据集进行探索性的研究,这个过程中会利用到各种描述性统计量和推断性统计量来初探变量间和变量内部的基本关系,本篇笔者便基于R,对一些常用的数据探索方 ...
- (数据科学学习手札126)Python中JSON结构数据的高效增删改操作
本文示例代码及文件已上传至我的Github仓库https://github.com/CNFeffery/DataScienceStudyNotes 1 简介 在上一期文章中我们一起学习了在Python ...
随机推荐
- FastJSON解析JSON的时候保证深堆的顺序
普通的JSONObject.parseObject(),解析的时候,底层采用HashMap解析所以是无序的, JSONObject params = JSONObject.parseObject(ex ...
- Spring框架学习笔记(1)
Spring 框架学习笔记(1) 一.简介 Rod Johnson(spring之父) Spring是分层的Java SE/EE应用 full-stack(服务端的全栈)轻量级(跟EJB比)开源框架, ...
- python基础 画图
python 画图 matplotlib 库只保存图片,不显示图片? 在导入库时,添加如下代码 import matplotlib matplotlib.use('Agg') 各种 symbol ? ...
- python中eval()
eval()执行简单的python代码(个人感觉像是执行表达式)
- algorithm入门算法中的常见问题
KMP算法(next数组) 二分查找(非递归) /** * 二分查找(非递归) * @param arr 从小到大的排序数组 * @param target 目标查找值 * @return */ pu ...
- Git进阶:常用命令和问题案例整理
一.前言 整理常用git命令和以及在实际使用的过程中碰到的问题案例,旨在git进阶,提升工作开发效率,有需要补充的小伙伴欢迎下方留言,本篇持续更新中... 二.命令 配置用户名和邮箱 git conf ...
- 三年之久的 etcd3 数据不一致 bug 分析
问题背景 诡异的 K8S 滚动更新异常 笔者某天收到同事反馈,测试环境中 K8S 集群进行滚动更新发布时未生效.通过 kube-apiserver 查看发现,对应的 Deployment 版本已经是最 ...
- C语言汇总3
16-18 1.常量 整型常量:1: 2: 3: 实型常量(小数):单精度常量[3.14],双精度常量(默认情况下)[10.1f] 字符型常量 ' 5 ',只要在双引号的任意的唯一一个字符就为字符型常 ...
- Oracle学习(五)DBLINK
一.DBLINK学习 目的:为了解决跨库访问的需求. 场景如下:tnsnames.ora(oracle的库配置文件)下配置了2个库的环境地址,现在要实现跨库访问. PS:DBLINK和是否同一个主机无 ...
- 自定义springboot - starter 实现日志打印,并支持动态可插拔
1. starter 命名规则: springboot项目有很多专一功能的starter组件,命名都是spring-boot-starter-xx,如spring-boot-starter-loggi ...