
python利用爬虫获取百度翻译,爱词霸翻译结果,制作翻译小工具
先看效果展示(仅作学习使用,非商业)
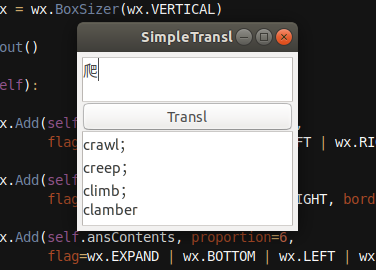
效果图是采用的 爱词霸 翻译,百度翻译 也实现了,只不过被注释了。
学计算机很多时候碰到生词,每次打开手机/浏览器翻译总觉得很麻烦,就想着自己写一个软件,自己去实现字典又太麻烦了,就想借着网上的翻译网站,做个爬虫。于是就学了下python,开始了爬虫之旅。
代码开始部分:
 # -*- encoding: utf-8 -*-

 import wx

 import requests

 import re

 import bs4

 import json

 import time

 from requests import Session

 # 界面与逻辑分离
本着面向对象的编程思想,就把 界面实现,和 逻辑部分给分开了
定义了两个类,一个处理 爬虫请求(Handler),一个处理界面部分(Window)
接下来是 Handler 类:
 class Handler():

     def __init__(self):

         # self.armUrl = r'https://fanyi.baidu.com/transapi'

         # 爱词霸

         self.mainUrl = r'http://www.iciba.com/'

         # 爱词霸

         self.armUrl = ""

         self.headers = {

             'User-Agent':

                 'Mozilla/5.0 (X11; Ubuntu; Linux x86_64; rv:61.0) Gecko/20100101 Firefox/61.0',

         }

         # self.data = {

         #     'transtype': 'ente'

         # }

         self.session = Session()

     #     self.__initial()

     #

     # def __initial(self):

     #

     #     r = requests.get(url = self.mainUrl, headers = self.headers)

     #     self.session.cookies = r.cookies

     # def setData(self, dict):

     #     self.data.update(dict)

     # 爱词霸

     def mendUrl(self, query):

         self.armUrl = self.mainUrl + query

     def requestText(self):

         r = self.session.get(url = self.armUrl)

         soup = bs4.BeautifulSoup(r.content, 'lxml')

         try:

             p = soup.find_all('p')[0]

             ans = ""

             for span in p.find_all('span'):

                 ans += span.string + '\n'

             return ans

         except:

             return "you fuck it up !!!"

     @property

     def text(self):

         return self.requestText()
Window 类部分:
 class Window():

     def __init__(self, handler):

         self.win = wx.Frame(None, title = 'SimpleTransl', size = (200, 150))

         self.bkg = wx.Panel(self.win)

         self.handler = handler

         self.translBtn = wx.Button(self.bkg, label = 'Transl')

         self.waitContents = wx.TextCtrl(self.bkg, style = wx.TE_MULTILINE)

         self.ansContents = wx.TextCtrl(self.bkg, style = wx.TE_MULTILINE)

         self.vbox = wx.BoxSizer(wx.VERTICAL)

         self.layout()

     def layout(self):

         self.vbox.Add(self.waitContents, proportion=3,

                       flag=wx.EXPAND | wx.TOP | wx.LEFT | wx.RIGHT, border=5)

         self.vbox.Add(self.translBtn, proportion=1,

                       flag=wx.EXPAND | wx.LEFT | wx.RIGHT, border=5)

         self.vbox.Add(self.ansContents, proportion=6,

                       flag=wx.EXPAND | wx.BOTTOM | wx.LEFT | wx.RIGHT, border=5)

         self.translBtn.Bind(wx.EVT_BUTTON, self.transl)

         self.bkg.SetSizer(self.vbox)

     def transl(self, event):

         # f, t = self.checkLang()

         #

         # data = {

         #     'from'  : f,

         #     'to'    : t,

         #     'query' : self.waitContents.GetValue()

         # }

         # self.handler.setData(dict = data)

         # 爱词霸

         self.handler.mendUrl(self.waitContents.GetValue())

         self.ansContents.SetValue(self.handler.text)

     # def checkLang(self):

     #

     #     txt = self.waitContents.GetValue()

     #

     #     if not txt:

     #         return ('error', 'error')

     #

     #     else:

     #         if 'a' <= txt[0] <= 'z' or 'A' <= txt[0] <= 'Z':

     #             return ('en', 'zh')

     #

     #         else:

     #             return ('zh', 'en')

     #

     def show(self):

         self.win.Show()
以上注释的部分是 百度翻译实现,取消注释,并且把 有 ‘爱词霸’ 标注部分注释就可以使用百度翻译实现了(但,requestsText 函数 提取信息要自己实现)
Window 类就是实现界面,定义了一个Button,两个 TextCrtl,并且给 翻译按钮绑定了一个事件,用于翻译。通过 构造函数,和 layout 函数 实现。
下面是 主函数:
 if __name__ == '__main__':

     app = wx.App()

     handler = Handler()

     window = Window(handler = handler)

     window.show()

     app.MainLoop()
PS.功能比较简单,后期可以拓展,比如 读音,界面美化等。。
这里用爱词霸展示是有原因的, 在百度翻译里,只能提取出一个非常简单的意思,没办法提供丰富的翻译(有那位小伙伴解决了这个问题,可以告诉我)
比如 :下面是 百度翻译 返回的信息
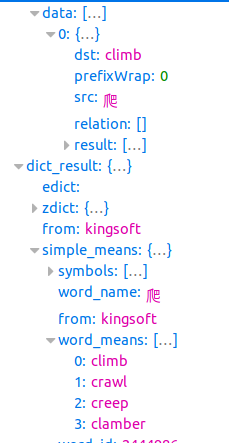
你可以获取 data 下的 { src :爬 }
但却获取不了 { word_means [... ] } 里面的更加详细、有用的信息。
解决了这个问题的小伙伴麻烦告知下(我再去补一下 web 的知识看看能不能解决)。
python利用爬虫获取百度翻译,爱词霸翻译结果,制作翻译小工具的更多相关文章
- python 利用爬虫获取页面上下拉框里的所有国家
前段时间,领导说列一下某页面上的所有国家信息,话说这个国家下拉框里的国家有两三百个,是第三方模块导入的,手动从页面拷贝,不切实际,于是想着用爬虫去获取这个国家信息,并保存到文件里. 下面是具体的代码, ...
- 《精通Python网络爬虫》|百度网盘免费下载|Python爬虫实战
<精通Python网络爬虫>|百度网盘免费下载|Python爬虫实战 提取码:7wr5 内容简介 为什么写这本书 网络爬虫其实很早就出现了,最开始网络爬虫主要应用在各种搜索引擎中.在搜索引 ...
- Python实现将爱词霸每日一句定时推送至微信
前言 前几天在网上看到一篇文章<教你用微信每天给女票说晚安>,感觉很神奇的样子,随后研究了一下,构思的确是巧妙.好,那就开始动工吧!服务器有了,Python环境有了,IDE打开了...然而 ...
- python爬虫获取百度图片(没有精华,只为娱乐)
python3.7,爬虫技术,获取百度图片资源,msg为查询内容,cnt为查询的页数,大家快点来爬起来.注:现在只能爬取到百度的小图片,以后有大图片的方法,我会陆续发贴. #!/usr/bin/env ...
- 一篇文章教会你利用Python网络爬虫获取电影天堂视频下载链接
[一.项目背景] 相信大家都有一种头疼的体验,要下载电影特别费劲,对吧?要一部一部的下载,而且不能直观的知道最近电影更新的状态. 今天小编以电影天堂为例,带大家更直观的去看自己喜欢的电影,并且下载下来 ...
- Selenium2+python自动化34-获取百度输入联想词
前言 最近有小伙伴问百度输入后,输入框下方的联想词如何定位到,这个其实难度不大,用前面所讲的元素定位完全可以定位到的. 本篇以百度输入框输入关键字匹配后,打印出联想词汇. 一.定位输入框联想词 1.首 ...
- Selenium2+python自动化34-获取百度输入联想词【转载】
前言 最近有小伙伴问百度输入后,输入框下方的联想词如何定位到,这个其实难度不大,用前面所讲的元素定位完全可以定位到的. 本篇以百度输入框输入关键字匹配后,打印出联想词汇. 一.定位输入框联想词 1.首 ...
- 手把手教你用Python网络爬虫获取网易云音乐歌曲
前天给大家分享了用Python网络爬虫爬取了网易云歌词,在文尾说要爬取网易云歌曲,今天小编带大家一起来利用Python爬取网易云音乐,分分钟将网站上的音乐down到本地. 跟着小编运行过代码的筒子们将 ...
- Python爬虫获取百度贴吧图片
#!/usr/bin/python# -*- coding: UTF-8 -*-import urllibimport re文章来源:https://www.cnblogs.com/Axi8/p/57 ...
随机推荐
- 深度搜索---------Lake counting
#include<iostream>#include<cstdio>#include<cstdlib>#define maxn 100char ch[maxn][m ...
- 从Python开始学编程|PDF百度网盘免费下载|Python新手入门
百度网盘免费下载:从Python开始学编程|附PDF免费下载 提取码:7nkf 豆瓣评分: 本书封面: 读者评论: 内容简介 · · · · · · 改编自Vamei博客的<Python快速教 ...
- 利用updatexml()报错注入mysql
基本介绍一下updatexml() updatexml(XML_document, XPath_string, new_value) XML_document是文档对象的名称 XPath_string ...
- 萌新学渗透系列之Hack The Box_Legacy
我将我的walkthrough过程用视频解说的形式记载 视频地址https://www.bilibili.com/video/BV1mZ4y1u7jG 一是因为看我视频的后来者应该都是刚入门的新手,视 ...
- 路径总和(leetcode 113)
题目描述如下所示: 给定一个二叉树和一个目标和,找到所有从根节点到叶子节点路径总和等于给定目标和的路径.(https://leetcode-cn.com/problems/path-sum-ii/) ...
- 关于cnpm的命令出错 cant find module npm-cli.js,以及vue packages version mismatch出错
1.cant find module npm-cli.js 这个修复比较简单粗暴,直接找到安装node的安装软件,然后点开,里面有一个修复选项. 修复完就可以了 2.第二个vue packages v ...
- Sqlite3 实现学生信息增删改查
import sqlite3 conn = sqlite3.connect('studentsdb.db') # 连接数据库 cursor = conn.cursor( ) # 创建数据表 def c ...
- 遍历多个 txt 文件进行获取值
import random def load_config(path): with open(path,'r') as tou: return [line for line in tou.readli ...
- 如何使用k3OS和Argo进行自动化边缘部署?
本文转自边缘计算k3s社区 前 言 随着Kubernetes生态系统的发展,新的技术正在被开发出来,以实现更广泛的应用和用例.边缘计算的发展推动了对其中一些技术的需求,以实现将Kubernetes部署 ...
- 2-Numpy之hstack、vstack、concatenate区别
concatenate与hstack.vstack的异同点: 都表示拼接数组,concatenate可以实现hstack和vstack的功能,只需要通过调整参数axis的值即可. 其中:v表示垂直(V ...