
CNN作为denoiser的优势总结
图像恢复的MAP推理公式:
$\hat{x}\text{}=\text{}$arg min$_{x}\frac{1}{2}||\textbf{y}\text{}-\text{}\textbf{H}x||^{2}\text{}+\text{}\lambda\Phi(x)$
正则化项$\Phi(x)$对应恢复的表现扮演了至关重要的角色:
$\textbf{z}_{k+1}\text{}=\text{}Denoiser(\textbf{x}_{k+1},\sqrt{\lambda/\mu})$
然后介绍现在的降噪先验只要采取model-based 优化方法去解决inverse problem,包括:
-- total variation(TV)法 ==》 常常制造watercolor-like 鬼影、伪影
-- 高斯混合模型(Gaussian mixture model,GMM)
-- K-SVD ==》高计算消耗
-- 非局部均值(Non-local means) ==》如果图像不具有自相似属性,会过度平滑不规则的结构
-- BM3D==》 如果图像不具有自相似属性,会过度平滑不规则的结构
图像的颜色先验是一个十分重要的考虑因素,因为图像大多数图像是RGB格式。
而由于不同图像通道之间的相关性,联合处理图像的不同通道常常会产生更好的表现比独立处理每个颜色通道。
许多工作都只对灰度图像进行建模,而对于彩色图像的建模较少;
作者指出CBM3D 因为联合处理了RGB通道,收获了不错的效果,同时作者提出可以使用判别学习方法去自动化的揭示潜在的彩色图像先验,而不是依靠手工设计的pipeline;
CNN降噪先验具有速度、表现、判别彩色图像建模的优势,同时CNN去学习判别式降噪器(discriminative denoiser)有一些原因:
-- CNN 的前向传播由于GPU的存在而并行计算
-- CNN 表现出了强大的先验建模能力with deep architecture
-- CNN利用外部先验,作为了BM3D为代表的内部先验的补充
-- 利用判别式学习的优势
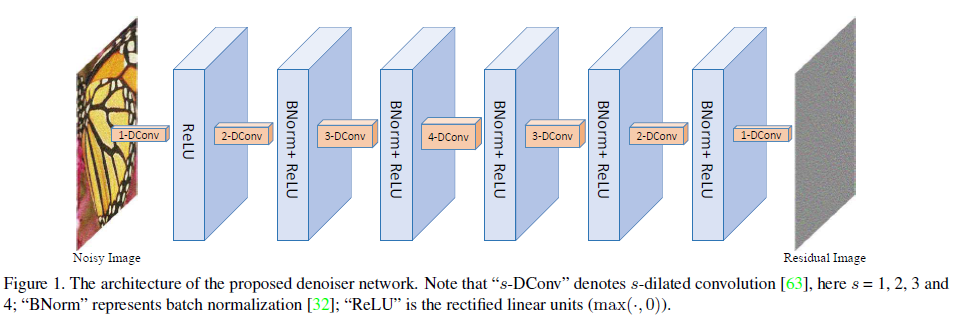
模型结构
CNN denoiser 如上图所示,网络包含七层,其中第一层是"扩张卷积(扩张指标为1,感知域还是3*3)+RELU",2-6层为“扩张卷积(扩张指标分别为2 3 4 3 2)+BN+RELU”, 最后一层为“扩展卷积(1),相当于正常的卷积运算,且每个中间层的特征图的数量都为64
扩张卷积filter and 增大的感知域
-- 在图像降噪中,上下文的信息能够促进毁坏像素的重建;
-- 为了捕获上下文的信息,通过前向的卷积操作去增大感知域是一个成功的方法;
有两种基本的增大感知域的方法:
-- 一个是增大filter size 弊端:会引入更多的参数,增大了计算负担
-- 一个是增大模型的深度
使用扩张卷积去获取filter size 和模型深度的平衡, 在保持 3*3 filter 的基础上 增大感知域, 整个7层网络实现了 33*33 的感知域, 相当于16层的3*3普通卷积;
其中扩张卷积的filter size 和 扩张指标s 之间的关系为: size = (2s+1)*(2s+1)
使用BN和残差学习加快训练
对于高斯降噪问题,结合BN和残差学习是十分有帮助的,他们都能够互相的获益(在他的论文中有讲Residual learning of deep CNN for image denoising.) 对于模型的迁移也有用;
残差学习方式,就是模型的目标不是直接学习产生降噪的图片,而是学习噪声即残差,即输入的带噪声的图片和干净图片的差。
使用小尺寸的图像作为训练集去避免边缘伪影
-- 由于CNN的特点,如果没有合适的处理,CNN的降噪图片将会产生边缘伪影;
-- 对称pandding 和 zero padding是两种解决这个问题的方法
-- 对于扩张指数为4的操作,在边缘pads 4 zeros,那其他的扩张指数呢?
-- 经验主义的使用了小尺寸的训练样本 去避免边缘伪影,原因包括:
-- 将大尺寸的图像crop 成小尺寸的patches,有利于CNN去看到更多的边沿信息,比如将70*70的patches crop成四个非重叠的35*35的patches,边缘信息被扩大了;
-- 就patch的大小可以作对比试验进行验证;
-- 当训练的patch尺寸小于感知域后,这个性能会下降;
学习实际的降噪器模型with 小间隔的噪声水平
-- 想要得到精确的子问题的解是非常困难且time-consuming的去优化的,使用不精确但是快速的子问题的解能够加快收敛(两篇文献:The augmented lagrange multiplier method for exact recovery of corrupted low-rank matrices.和 From learning models of natural im age patches to whole image restoration.)
-- 所以 没有必要去学习很多判别式降噪模型for 每个噪声水平。
-- 尽管$\textbf{z}_{k+1}\text{}=\text{}Denoiser(\textbf{x}_{k+1},\sqrt{\lambda/\mu})$ 是一个降噪器,但他与传统的高斯降噪有着不同的目标。
-- 传统的高斯降噪是恢复出潜在的干净图像,无论要去噪的图像的噪声类型和噪声水平如何,这里的去噪器都会发挥自己的作用。也就是说,不管这个图像有没有噪声,都会发挥作用!
-- 所以一个理想的判别降噪器应该使用当前的噪声水平进行训练:
训练了一系列的噪声水平在0-50同时独立的以2为间隔的模型,产生了25个模型为图像的先验进行建模;迭代方案的存在,使他恢复足以满足。
实验
图像降噪:
-- 将每个图片 crop 成了35*35的patches,因为使用残差学习的方式,损失函数:
$\textit{l}(\Theta)\text{}=\text{}\frac{1}{2N}\sum_{i=1}^{N}||f(y_{i};\Theta)\text{}-\text{}(y_{i}\text{}-\text{}x_{i})||^{2}$
-- 训练结束的标志 训练损失在五个连续的epoch固定
-- 使用了旋转翻转等数据扩充技巧;
-- 从不同方法的PSNR 进行了对比, 分别书灰度图和彩色图
-- 从不同方法的运行时间进行了对比
图像去模糊:
模糊核的选择:
-- 一个常见的模糊的高斯模糊核,标准差为1.6, 来自论文(Understanding and evaluating blind deconvolution algorithms)的前两个的真实模糊核;
-- 我们只需将颜色去噪器插入到HQS框架中;
-- 在公式6中:
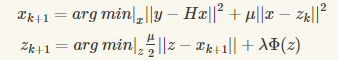
-- 两个参数中,$\lambda$ 与$\sigma^{2}$相联系同时在迭代中保持固定,其中$\mu$控制着降噪器的噪声水平;
公式6(a)的快速解法:
$x_{k+1}=(H^{T}H+\mu I)^{-1}(H^{T}y+\mu z_{k}) \text{ }\text{ }\text{ }\text{ }\text{ }\text{ }(7)$
-- 由于hqs框架是基于去噪的,因此我们将每次迭代中去噪的噪声级隐式的确定为μ。
-- 在我们的实验设置中,根据噪声水平,它以指数形式从49衰减到[1,15]中的值。
-- 实验代码核心迭代部分
%模拟仿真的模糊噪声图片

k = fspecial('gaussian', 25, 1.6);%相当于是模糊算子

y = imfilter(im2double(x), k, 'circular', 'conv') + sigma*randn(size(x));

%denominator 表示是H^{T}H, H模糊算子与他的共轭矩阵相乘

V = psf2otf(k,[w,h]);%psf2otf(PSF) 其作用是将一个空间点扩散函数转换为频谱面的光学传递函数,执行的也是对PSF的FFT变换,变为了频域;

denominator = abs(V).^2;%y = abs(3+4i) y=5

%H^{T}*y H的共轭矩阵乘以输入y

upperleft   = conj(V).*fft2(y); % conj(V) V=5-2i ==> 5+2i

%训练的特点噪声水平\sigma的一组denoiser,其\sigma以指数形式的衰减的不同模型;

modelSigmaS = logspace(log10(modelSigma1),log10(modelSigma2),totalIter);

%\lamba与噪声水平\sigma^2有关且在迭代中保持固定,\mu控制着降噪器的噪声水平,%rho隐式的表示\mu,见下面的计算方法与降噪器的噪声水平和噪声水平有关

rho = lamda*255^2/(modelSigmaS(itern)^2);%[243.742,267.099,292.694,320.742,351.476]

upperleft =

for itern = 1:totalIter

            %%% step 1

            rho = lamda*255^2/(modelSigmaS(itern)^2);

            z = real(ifft2((upperleft + rho*fft2(z))./(denominator + rho)));

            if ns(itern+1)~=ns(itern)

                [net] = loadmodel(modelSigmaS(itern),CNNdenoiser);

                net = vl_simplenn_tidy(net);

                if useGPU

                    net = vl_simplenn_move(net, 'gpu');

                end

            end

            %%% step 2

            res = vl_simplenn(net, z,[],[],'conserveMemory',true,'mode','test');

            residual = res(end).x;

            z = z - residual;

        end
真实模糊图像的测试
设置了两个重要的估计图像噪声水平 和 降噪器去噪水平的 超参数:

% There are two important parameters to tune:

% (1) image noise level of blurred image: Isigma and

% (2) noise level of the last denoiser: Msigma.

%使用了 别人的方法 产生的模糊核 图像作为先验的条件

%% read blurred image and its estimated kernel

% blurred image

Iname = 'im01_ker01';

y  = im2single(imread(fullfile(folderTestCur,[Iname,'.png'])));

% estimated kernel

%k  = imread(fullfile(folderTestCur,[Iname,'_kernel.png']));

k  = imread(fullfile(folderTestCur,[Iname,'_out_kernel.png']));

if size(k,3)==3

    k = rgb2gray(k);

end

k  = im2single(k);

k  = k./(sum(k(:))); %归一化

%比较重要的部分是边缘的处理

%% handle boundary

boundary_handle = 'case2';

switch boundary_handle

    case {'case1'} % option (1), edgetaper to better handle circular boundary conditions, (matlab2015b)

        % k(k==0) = 1e-10; % uncomment this for matlab 2016--2018?

        ks = floor((size(k) - 1)/2);

        y = padarray(y, ks, 'replicate', 'both');

        for a=1:4

            y = edgetaper(y, k);

        end

    case {'case2'} % option (2)

        H = size(y,1);    W = size(y,2);

        y = wrap_boundary_liu(y, opt_fft_size([H W]+size(k)-1));

end
需要明白为什么需要进行边缘条件的变化,是让模糊核完全重合和图像,所以需要用模糊核 进行 一些 padding 操作
CNN作为denoiser的优势总结的更多相关文章
- CNN卷机网络在自然语言处理问题上的应用
首先申明本人的英语很搓,看英文非常吃力,只能用这种笨办法来方便下次阅读.有理解错误的地方,请别喷我. 什么是卷积和什么是卷积神经网络就不讲了,自行google.从在自然语言处理的应用开始(SO, HO ...
- 深度学习之父低调开源 CapsNet,欲取代 CNN
“卷积神经网络(CNN)的时代已经过去了!” ——Geoffrey Hinton 酝酿许久,深度学习之父Geoffrey Hinton在10月份发表了备受瞩目的Capsule Networks(Cap ...
- CNN卷积神经网络详解
前言 在学计算机视觉的这段时间里整理了不少的笔记,想着就把这些笔记再重新整理出来,然后写成Blog和大家一起分享.目前的计划如下(以下网络全部使用Pytorch搭建): 专题一:计算机视觉基础 介 ...
- zz全面拥抱Transformer
放弃幻想,全面拥抱Transformer:自然语言处理三大特征抽取器(CNN/RNN/TF)比较 在辞旧迎新的时刻,大家都在忙着回顾过去一年的成绩(或者在灶台前含泪数锅),并对2019做着规划,当然也 ...
- 【计算机视觉】图像配准(Image Registration)
(Source:https://blog.sicara.com/image-registration-sift-deep-learning-3c794d794b7a) 图像配准方法概述 图像配准广泛 ...
- 论文翻译—SPP-Net(目标检测)
SPPNet论文翻译 <Spatial Pyramid Pooling in Deep Convolutional Networks for Visual Recognition> Kai ...
- 小匠第二周期打卡笔记-Task04
一.机器翻译及相关技术 机器翻译(MT):将一段文本从一种语言自动翻译为另一种语言,用神经网络解决这个问题通常称为神经网络翻译(NMT). 主要特征:输出是单词序列而不是单个单词.输出序列的长度可能与 ...
- 图像配准:从SIFT到深度学习
图像配准(Image Registration)是计算机视觉中的基本步骤.在本文中,我们首先介绍基于OpenCV的方法,然后介绍深度学习的方法. 什么是图像配准 图像配准就是找到一幅图像像素到另一 ...
- L12 Transformer
Transformer 在之前的章节中,我们已经介绍了主流的神经网络架构如卷积神经网络(CNNs)和循环神经网络(RNNs).让我们进行一些回顾: CNNs 易于并行化,却不适合捕捉变长序列内的依赖关 ...
随机推荐
- Github 个人首页的 README,这样玩儿~
本文首发于 Ficow Shen's Blog,原文地址: Github 个人首页的 README,这样玩儿~. 内容概览 前言 创建仓库 修改 README 的内容 总结 前言 大家最近有没有发现这 ...
- 【性能监控-Perfmon工具】手动添加数据收集器,点击保存时需要输入用户NT AUTHORITY\SYSTEM的密码问题
发现是有的电脑会弹出这种输入用户NT AUTHORITY\SYSTEM密码的现象,有的电脑不会弹出这个对话框.......仍然没搞懂是为什么? 关键是输入windows用户登录时的密码也不对!!压根不 ...
- MySQL中concat()、concat_ws()、group_concat()函数的使用技巧与心得总结
Author:极客小俊 一个专注于web技术的80后 我不用拼过聪明人,我只需要拼过那些懒人 我就一定会超越大部分人! CSDN@极客小俊,原创文章, B站技术分享 B站视频 : Bilibili.c ...
- 从四个问题透析Linux下C++编译&链接
摘要:编译&链接对C&C++程序员既熟悉又陌生,熟悉在于每份代码都要经历编译&链接过程,陌生在于大部分人并不会刻意关注编译&链接的原理.本文通过开发过程中碰到的四个典型 ...
- python+pymysql访问mysql数据库
今天跟大家分享两种场景的python连接MySQL方法: 场景一:连接远程MySQL 首先,安装pymysql:在命令行执行pip install pymysql指令. 然后,导入pymysql: i ...
- 微信小程序-实现文字跑马灯-wepy
百度蛮多例子的,但是代码太长懒得看了 前言 要实现跑马灯主要就是获得判断开始定界和结束定界, 1.9.3新增的wxml操作接口 就可以拿到节点长宽等属性,当然你也可以直接用 文字数量 * 文字大小(注 ...
- Restful 风格是什么?
1.1 什么是RESTful 1. REST与技术无关,代表的是一种软件架构风格(REST是Representational State Transfer的简称,中文翻译为"表征状态转移&q ...
- Python-禅
Python特点 1. 面向对象解释性编程语言 2. 简洁.优雅的编码风格 3. 跨平台 windows MacOS Linux 4. 丰富的标准库和第三方库 什么是编程? 解决现实中问题 什么是面向 ...
- 001 01 Android 零基础入门 01 Java基础语法 01 Java初识 01 导学
001 01 Android 零基础入门 01 Java基础语法 01 Java初识 01 导学 welcome to Java World 欢迎来到Java世界 一起领略Java编程世界的奥秘与奥妙 ...
- Jmeter之『JSR223脚本』
Json处理(通过JS) 对于Json字符串,需要使用单引号『''』(因为Json中已存在双引号) // String转为Object var jsonObj = JSON.parse('${data ...