
sklearn学习一
转发说明:by majunman from HIT email:2192483210@qq.com
简介:scikit-learn是数据挖掘和数据分析的有效工具,它建立在 NumPy, SciPy, and matplotlib基础上。开源的但商业不允许
1. Supervised learning
1.1. Generalized Linear Models
1.1.1. Ordinary Least Squares最小二乘法
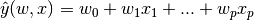
>>> from sklearn import linear_model

>>> reg = linear_model.LinearRegression()

>>> reg.fit ([[0, 0], [1, 1], [2, 2]], [0, 1, 2])

LinearRegression(copy_X=True, fit_intercept=True, n_jobs=1, normalize=False)

>>> reg.coef_

array([ 0.5,  0.5])
reg-http://scikit-learn.org/stable/modules/generated/sklearn.linear_model.LinearRegression.html#sklearn.linear_model.LinearRegression
reg.coef_ 是回归函数的结果,即相关系数
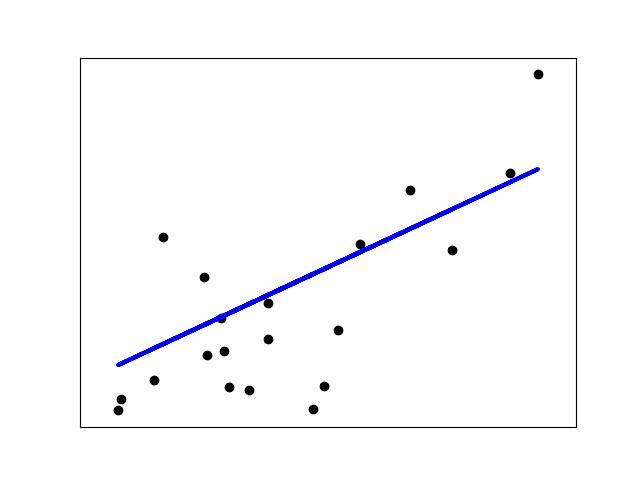
具体实验:
print(__doc__)

# Code source: Jaques Grobler

# License: BSD 3 clause

import matplotlib.pyplot as plt

import numpy as np

from sklearn import datasets, linear_model

from sklearn.metrics import mean_squared_error, r2_score

# Load the diabetes dataset

diabetes = datasets.load_diabetes()   #加载diabetes数据集(sklearn提供的几种数据集之一,该数据是糖尿病数据集)

# Use only one feature

diabetes_X = diabetes.data[:, np.newaxis, 2]   #只加载一个特征值

# Split the data into training/testing sets

diabetes_X_train = diabetes_X[:-20]

diabetes_X_test = diabetes_X[-20:]

# Split the targets into training/testing sets

diabetes_y_train = diabetes.target[:-20]

diabetes_y_test = diabetes.target[-20:]

# Create linear regression object

regr = linear_model.LinearRegression()

# Train the model using the training sets

regr.fit(diabetes_X_train, diabetes_y_train)

# Make predictions using the testing set

diabetes_y_pred = regr.predict(diabetes_X_test)

# The coefficients

print('Coefficients: \n', regr.coef_)

# The mean squared error

print("Mean squared error: %.2f"

      % mean_squared_error(diabetes_y_test, diabetes_y_pred))

# Explained variance score: 1 is perfect prediction

print('Variance score: %.2f' % r2_score(diabetes_y_test, diabetes_y_pred))

# Plot outputs

plt.scatter(diabetes_X_test, diabetes_y_test,  color='black')

plt.plot(diabetes_X_test, diabetes_y_pred, color='blue', linewidth=3)

plt.xticks(())

plt.yticks(())

plt.show()
sklearn学习一的更多相关文章
- sklearn学习笔记之简单线性回归
简单线性回归 线性回归是数据挖掘中的基础算法之一,从某种意义上来说,在学习函数的时候已经开始接触线性回归了,只不过那时候并没有涉及到误差项.线性回归的思想其实就是解一组方程,得到回归函数,不过在出现误 ...
- sklearn学习总结(超全面)
https://blog.csdn.net/fuqiuai/article/details/79495865 前言sklearn想必不用我多介绍了,一句话,她是机器学习领域中最知名的python模块之 ...
- sklearn学习 第一篇:knn分类
K临近分类是一种监督式的分类方法,首先根据已标记的数据对模型进行训练,然后根据模型对新的数据点进行预测,预测新数据点的标签(label),也就是该数据所属的分类. 一,kNN算法的逻辑 kNN算法的核 ...
- sklearn 学习 第一篇:分类
分类属于监督学习算法,是指根据已有的数据和标签(分类)进行学习,预测未知数据的标签.分类问题的目标是预测数据的类别标签(class label),可以把分类问题划分为二分类和多分类问题.二分类是指在两 ...
- SKlearn | 学习总结
1 简介 scikit-learn,又写作sklearn,是一个开源的基于python语言的机器学习工具包.它通过NumPy, SciPy和Matplotlib等python数值计算的库实现高效的算法 ...
- sklearn学习笔记3
Explaining Titanic hypothesis with decision trees decision trees are very simple yet powerful superv ...
- sklearn学习笔记2
Text classifcation with Naïve Bayes In this section we will try to classify newsgroup messages using ...
- sklearn学习笔记1
Image recognition with Support Vector Machines #our dataset is provided within scikit-learn #let's s ...
- 莫烦sklearn学习自修第九天【过拟合问题处理】
1. 过拟合问题可以通过调整机器学习的参数来完成,比如sklearn中通过调节gamma参数,将训练损失和测试损失降到最低 2. 代码实现(显示gamma参数对训练损失和测试损失的影响) from _ ...
- 莫烦sklearn学习自修第八天【过拟合问题】
1. 什么是过拟合问题 所谓过拟合问题指的是使用训练样本进行训练时100%正确分类或规划,当使用测试样本时则不能正确分类和规划 2. 代码实战(模拟过拟合问题) from __future__ imp ...
随机推荐
- Python pip升级及升级失败解决方案
本教程用于Python pip升级及失败解决方案 首先查看脚本 pip show pip 我已经升级到了最新的版本 安装其他模块过程中出现下面提示,便说明你需要升级pip You are using ...
- hadoop3.1.2队列
hapood3.1.2 capacity-scheduler.xml CDH6.2 在配置中输入fair,转成json格式看. yarn资源池配置: CDH--yarn--动态资源池配置 pool_d ...
- Oracle临时表的功能与应用
什么是临时表,用户做一个操作查询出几百几千条数据,我们可以把数据放在内存中.当有很多用户都这样做,内存空间不足,这个时候就需要把数据保存在磁盘上.对于 oracle 就提供了一种临时表用于存放这些数据 ...
- jdbc简单使用
1.代码 import java.sql.*; public class DBUtil { public static void main(String[] args) throws ClassNot ...
- 从入门到自闭之Python高阶函数
高阶函数:内部帮忙做了一个for循环 filter:筛选过滤 语法: filter(function,iterable) function: 1.指定过滤规则(函数的内存地址) 2.用来筛选的函数,在 ...
- Linux 测试IP和端口是否能访问
一. 使用wget判断 wget是linux下的下载工具,需要先安装. 用法: wget ip:port 连接存在的端口 转自:https://blog.csdn.net/weixin_3768923 ...
- springboot mongodb jpa常用方法整理
官方文档https://docs.spring.io/spring-data/data-mongodb/docs/current/reference/html/index.html 查询: ***** ...
- javaScript基本使用api
基本方法 isArray() 判断数组 isArray() 方法用于判断是否是数组(有兼容性) 语法:Array.isArray(arr) 返回值:是数组,返回true.不是数组,返回false. i ...
- react 不同环境配置不同域名
npm eject 先将配置文件暴露出来 将scripts中的build文件复制一份,改名为你需要的名字 将其中的 process.env.NODE_ENV 赋值为你需要的环境 在package.js ...
- groovy程序设计
/********* * groovy中Object类型存在隐式转换 可以不必使用as强转 */ Object munber = 9.343444 def number1 = 2 println mu ...