
scrapy架构与目录介绍、scrapy解析数据、配置相关、全站爬取cnblogs数据、存储数据、爬虫中间件、加代理、加header、集成selenium
今日内容概要
- scrapy架构和目录介绍
- scrapy解析数据
- setting中相关配置
- 全站爬取cnblgos文章
- 存储数据
- 爬虫中间件和下载中间件
- 加代理,加header,集成selenium
内容详细
1、scrapy架构和目录介绍
# pip3 install scrapy

# 创建项目:scrapy startproject cnblogs_spider   等同于django创建项目

# 创建爬虫:scrapy genspider cnblogs www.cnblogs.com   等同于创建app

	本质就是在spiders文件夹下创建一个py文件,写入一些代码

# 运行爬虫:scrapy crawl 爬虫名
1.1 项目目录介绍
cnblogs_spider  # 项目名字

	-cnblogs_spider  # 项目下一级文件夹

		--spiders  # 项目下二级文件夹,下面放了一个个爬虫文件

			---__init__.py

			---cnblogs.py  # 创建的一个个的爬虫文件

	-__init__.py

	-items.py  # 模型类写了一些字段---》类似于django的models

	-middlewares.py  # 中间件:爬虫中间件和下载中间件

	-pipelines.py  # 管道:存储数据的代码写在这

	-settings.py  # 项目的配置文件

	-scrapy.cfg  # 项目上线需要用到,不用管

# 重点:

	咱们以后主要是在cnblogs.py 爬虫文件中写爬取和解析的逻辑,pipelines.py写存储
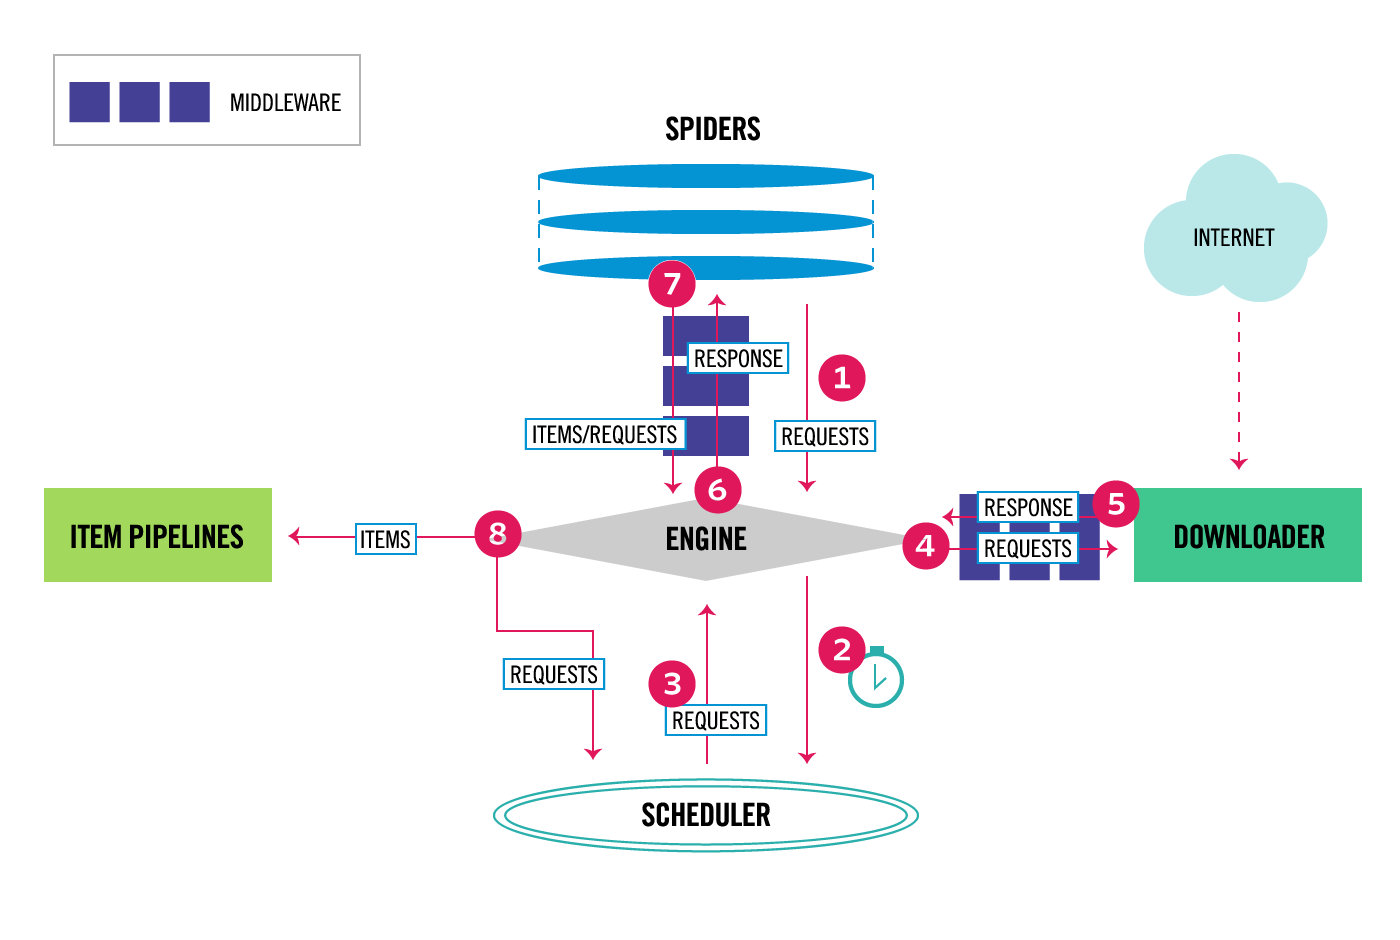
1.2 scrapy架构
# 引擎(EGINE)-->大总管,负责全部的数据流向--》内置的,咱们不需要写

	引擎负责控制系统所有组件之间的数据流,并在某些动作发生时触发事件

# 调度器(SCHEDULER)---》对要爬取的地址进行排队,去重

	用来接受引擎发过来的请求, 压入队列中, 并在引擎再次请求的时候返回

	可以想像成一个URL的优先级队列, 由它来决定下一个要抓取的网址是什么, 同时去除重复的网址

# 下载器(DOWLOADER)--》真正负责下载---》高效的异步模型

	用于下载网页内容, 并将网页内容返回给EGINE,下载器是建立在twisted这个高效的异步模型上的

# 爬虫(SPIDERS)--》咱们重点写的地方,解析响应,从响应中提取要保存的数据和下一次爬取的地址

	SPIDERS是开发人员自定义的类,用来解析responses,并且提取items,或者发送新的请求

# 项目管道(ITEM PIPLINES)---》存储数据的逻辑---》可以存到文件,redis,mysql。。。

	在items被提取后负责处理它们,主要包括清理、验证、持久化(比如存到数据库)等操作

# 下载器中间件(Downloader Middlewares)--》用的多

	位于Scrapy引擎和下载器之间,主要用来处理从EGINE传到DOWLOADER的请求request(加请求头,加cookie,加代理),已经从DOWNLOADER传到EGINE的响应response进行一些处理

# 爬虫中间件(Spider Middlewares)---》用的少

	位于EGINE和SPIDERS之间,主要工作是处理SPIDERS的输入(即responses)和输出(即requests)
1.3 py文件直接运行爬虫
# 在项目根目录下创建一个运行脚本

# 右键运行它就可以运行爬虫,不需要每次都敲命令

from scrapy import cmdline

# cmdline.execute(['scrapy', 'crawl', 'cnblogs', '--nolog'])  # 不打印日志

cmdline.execute(['scrapy', 'crawl', 'cnblogs'])  # 打印日志
2、scrapy解析数据
###################################  重点

1 response对象有css方法和xpath方法

	css中写css选择器

	xpath中写xpath选择

2 重点1:

	xpath取文本内容

		'.//a[contains(@class,"link-title")]/text()'

	xpath取属性

		'.//a[contains(@class,"link-title")]/@href'

	css取文本

		'a.link-title::text'

	css取属性

		'img.image-scale::attr(src)'

3 重点2:

	.extract_first()  取一个

	.extract()       取所有
3、setting中相关配置
3.1 基本配置
# 两套配置,内置一套,用户一套

ROBOTSTXT_OBEY = False  # 是否遵循爬虫协议,如果写了它,一般网站都不让爬,基本写成false

USER_AGENT = '浏览器头' # 爬虫请求头中USER_AGENT是什么,做成浏览器的样子

LOG_LEVEL='ERROR'  # 日志级别改成ERROR,以后错误日志会打印,普通日志不打印

#---------#####-------

SPIDER_MIDDLEWARES=[]      # 爬虫中间件,可以写多个

DOWNLOADER_MIDDLEWARES=[]  # 下载中间件类,配置在这,可以配多个

ITEM_PIPELINES=[]          # 保存数据,会执行到的类,类内部写保存逻辑
3.2 提高爬虫效率
# 1 增加并发:

	默认scrapy开启的并发线程为32个,可以适当进行增加。在settings配置文件中修改CONCURRENT_REQUESTS = 100值为100,并发设置成了为100

# 2 降低日志级别:

	在运行scrapy时,会有大量日志信息的输出,为了减少CPU的使用率。可以设置log输出信息为INFO或者ERROR即可。在配置文件中编写:LOG_LEVEL = 'INFO'

# 3 禁止cookie:

	如果不是真的需要cookie,则在scrapy爬取数据时可以禁止cookie从而减少CPU的使用率,提升爬取效率。在配置文件中编写:COOKIES_ENABLED = False

# 4 禁止重试:

	对失败的HTTP进行重新请求(重试)会减慢爬取速度,因此可以禁止重试。在配置文件中编写:RETRY_ENABLED = False

# 5 减少下载超时:

	如果对一个非常慢的链接进行爬取,减少下载超时可以能让卡住的链接快速被放弃,从而提升效率。在配置文件中进行编写:DOWNLOAD_TIMEOUT = 10 超时时间为10s
4、全站爬取cnblgos文章
# 只爬了首页---》下一页,文章详情页没有爬取

# 文章--》文章对象(标题,作者,摘要,详情。。。)---》把整站都爬取完成
4.1 request和response对象传递参数
# 在request中通过meta传递

	yield Request(url=article_url,callback=self.parse_detail,meta={'item':item})

# 在response中通过meta取出

	item=response.meta.get('item')
4.2 解析出下一页地址并继续爬取
# 使用

yield Request(url=article_url,callback=self.parse_detail,meta={'item':item})

yield Request(url=next_url)
5、存储数据
# 关于mysql出现Data too long for column的解决方案 打开my.ini,将其中sql-mode节中的STRICT_TRANS_TABLES这个属性去掉;
pipelines.py:
import pymysql

class CnblogsSpiderPipeline:

    # 所有的保存都用一个连接,最后存完把连接关闭,爬虫一启动打开数据库连接,爬虫关闭,关闭数据库连接

    def open_spider(self, spider):

        print("我开了")

        self.conn = pymysql.connect(

            user='root',

            password="123",

            host='127.0.0.1',

            database='cnblogs',

            port=3306,

            autocommit=True  # 自动提交

        )

        self.cursor = self.conn.cursor()

    def process_item(self, item, spider):

        # 每个文章都会一次次的触发该方法的执行,在这里写保存逻辑

        print('pipline:', item['title'])

        # self.cursor.execute('insert into article (title,`desc`,detail,author_name,author_img) values (%s,%s,%s,%s,%s)',

        #                     args=[item['title'], item['desc'], item['detail'], item['author_name'],

        #                           item['author_img'], ])

        return item

    def close_spider(self, spider):

        print('我关了')

        self.cursor.close()

        self.conn.close()

class CnblogsSpiderFilePipeline:

    def process_item(self, item, spider):

        return item
6、爬虫中间件和下载中间件
# 爬虫和下载中间件要使用,需要在配置文件中:

SPIDER_MIDDLEWARES = {

  'crawl_cnblogs.middlewares.CrawlCnblogsSpiderMiddleware': 5,

}

DOWNLOADER_MIDDLEWARES = {

  'crawl_cnblogs.middlewares.CrawlCnblogsDownloaderMiddleware': 5,

}
7、加代理,加header,集成selenium
# 在下载中间件的process_reqeust方法中

# 1 加cookie

	# request.cookies['name']='lqz'

	# request.cookies= {}

# 2 修改header

	# request.headers['Auth']='asdfasdfasdfasdf'

	# request.headers['USER-AGENT']='ssss'

# 3 加代理

	request.meta['proxy']='http://103.130.172.34:8080'

# 4 fake_useragent模块,可以随机生成user-aget

from fake_useragent import UserAgent

ua = UserAgent()

print(ua.ie)  #随机打印ie浏览器任意版本

print(ua.firefox)  #随机打印firefox浏览器任意版本

print(ua.chrome)  #随机打印chrome浏览器任意版本

print(ua.random)  #随机打印任意厂家的浏览器
scrapy架构与目录介绍、scrapy解析数据、配置相关、全站爬取cnblogs数据、存储数据、爬虫中间件、加代理、加header、集成selenium的更多相关文章
- Scrapy实战篇(八)之Scrapy对接selenium爬取京东商城商品数据
本篇目标:我们以爬取京东商城商品数据为例,展示Scrapy框架对接selenium爬取京东商城商品数据. 背景: 京东商城页面为js动态加载页面,直接使用request请求,无法得到我们想要的商品数据 ...
- scrapy爬取cnblogs文章列表
scrapy爬取cnblogs文章 目标任务 安装爬虫 创建爬虫 编写 items.py 编写 spiders/cnblogs.py 编写 pipelines.py 编写 settings.py 运行 ...
- 爬虫---scrapy全站爬取
全站爬取1 基于管道的持久化存储 数据解析(爬虫类) 将解析的数据封装到item类型的对象中(爬虫类) 将item提交给管道, yield item(爬虫类) 在管道类的process_item中接手 ...
- Python爬虫入门教程 42-100 爬取儿歌多多APP数据-手机APP爬虫部分
1. 儿歌多多APP简单分析 今天是手机APP数据爬取的第一篇案例博客,我找到了一个儿歌多多APP,没有加固,没有加壳,没有加密参数,对新手来说,比较友好,咱就拿它练练手,熟悉一下Fiddler和夜神 ...
- 利用python爬取58同城简历数据
利用python爬取58同城简历数据 利用python爬取58同城简历数据 最近接到一个工作,需要获取58同城上面的简历信息(http://gz.58.com/qzyewu/).最开始想到是用pyth ...
- 爬虫黑科技,我是怎么爬取indeed的职位数据的
最近在学习nodejs爬虫技术,学了request模块,所以想着写一个自己的爬虫项目,研究了半天,最后选定indeed作为目标网站,通过爬取indeed的职位数据,然后开发一个自己的职位搜索引擎,目前 ...
- 简单又强大的pandas爬虫 利用pandas库的read_html()方法爬取网页表格型数据
文章目录 一.简介 二.原理 三.爬取实战 实例1 实例2 一.简介 一般的爬虫套路无非是发送请求.获取响应.解析网页.提取数据.保存数据等步骤.构造请求主要用到requests库,定位提取数据用的比 ...
- Python网页解析库:用requests-html爬取网页
Python网页解析库:用requests-html爬取网页 1. 开始 Python 中可以进行网页解析的库有很多,常见的有 BeautifulSoup 和 lxml 等.在网上玩爬虫的文章通常都是 ...
- 使用Selenium爬取网站表格类数据
本文转载自一下网站:Python爬虫(5):Selenium 爬取东方财富网股票财务报表 https://www.makcyun.top/web_scraping_withpython5.html 需 ...
随机推荐
- ACM - 动态规划 - UVA 1347 Tour
UVA 1347 Tour 题解 题目大意:有 \(n\) 个点,给出点的 \(x\).\(y\) 坐标.找出一条经过所有点一次的回路,从最左边的点出发,严格向右走,到达最右点再严格向左,回到最左点. ...
- C# 正则表达式判断是否是有效的文件、文件夹路径
C# 正则表达式判断是否是有效的文件.文件夹路径 省流 /// <summary> /// 是否有效的文件,文件夹路径 /// </summary> /// <param ...
- AD18布线技巧
3. 快乐打孔模式(颜色配置)PCB 设计完成后,补回流孔,需要打开多层,软件设置如下: 设置方法: 转载原文链接未知
- 玩转 React(四)- 创造一个新的 HTML 标签
在第二篇文章 <新型前端开发方式> 中有说到 React 有很爽的一点就是给我们一种创造 HTML 标签的能力,那么今天这篇文章就详细讲解下 React 是如何提供这种能力的,作为前端开发 ...
- HTML中meta标签详解;property=og标签详解
meta是用来在HTML文档中模拟HTTP协议的响应头报文.META标签是HTML语言HEAD区的一个辅助性标签,它位于HTML文档头部的<HEAD>标记和<TITLE>标记之 ...
- 存储过程 psal emp.sal%type是什么意思
psal emp.sal%type 就是指psal这个变量是引用了表emp中的sal字段的类型.如果emp表中sal的类型变了,psal这个字段的类型也会跟着变化,总之,psal和表emp中sal字段 ...
- 浅谈ES6中的Class
转载地址:https://www.cnblogs.com/sghy/p/8005857.html 一.定义类(ES6的类,完全可以看做是构造函数的另一种写法) class Greet { constr ...
- 视频Video放器的部分实例方法
***创建一个视频播放器实例 let myPlayer = this.$video(myVideo, { controls: true, autoplay: 'muted', preload: &qu ...
- smdms超市订单管理系统之登录功能
一.超市订单管理系统准备阶段 Supermarket order management system 创建数据库 数据库代码放置如下 点击查看数据库address代码 CREATE TABLE `sm ...
- Ubuntu20.04中创建Pycharm桌面快捷方式
[Desktop Entry] Type=Application Name=Pycharm GenericName=Pycharm3 Comment=Pycharm3:The Python IDE E ...