
机器学习 —— 概率图模型(学习:CRF与MRF)
在概率图模型中,有一类很重要的模型称为条件随机场。这种模型广泛的应用于标签—样本(特征)对应问题。与MRF不同,CRF计算的是“条件概率”。故其表达式与MRF在分母上是不一样的。

如图所示,CRF只对 label 进行求和,而不对dataset求和。
1、CRF的likelyhood function
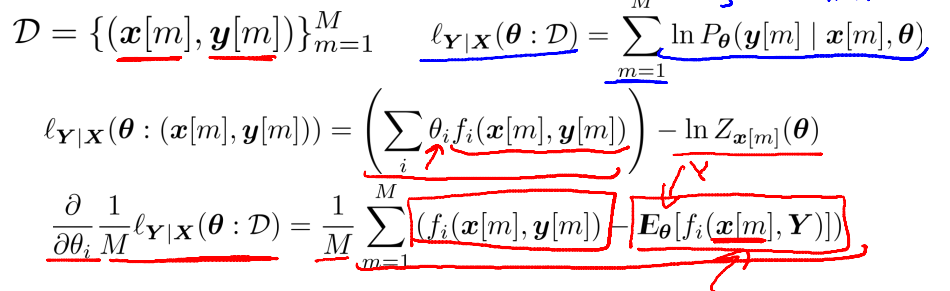
对于给定的数据集以及其对应标记,CRF的 E based on theta 是与 数据集 x[m]有关的,因为x[m]并没有完全被边际掉。也就是说,对数据集中的每个数据x[m],E based on theta 都是不一样的。这是CRF与MRF最大的不同。MRF完全边际掉了x,所以对任意数据集,E_theta 都相同。以图像分割中经典的双牛图为例:

1、图像是聚类后的图像,已经进行了超分割
2、X代表超像素,Y代表标签
3、Gs代表平均绿强度
4、采用loglinear模型:theta*fi
对于第一个参数,其仅和特征函数1(f1)有关,求导后发现,第一项是数据集特征统计(数据集特征函数期望);第二项是在该theta下,数据集对应label = green的概率乘以绿强度。很好理解1函数的模型期望就是概率。
2、CRF与MRF对比
1、CRF在训练时,针对每组数据都需要计算E based on model,MRF的E based on model 和单个数据集无关
2、CRF在使用时,针对给定x仅需要计算P(Y|x);MRF计算P(YX),在计算时需要对XY都进行边缘化。
3、MRF与CRF的先验
先验指的是对其参数分布的估计。在贝耶斯多项分布估计中,如果对参数先作出狄利克雷假设,则后续的后验分布也是狄利克雷的。把这个思想移植到MRF与CRF可以对其学习过程的性质进行改善。
关于参数的先验有两种,分别是拉普拉斯先验和高斯先验。
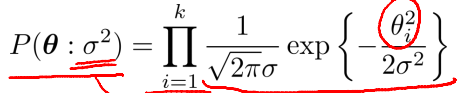
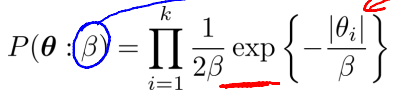
其中,delta和beta的作用类似,是分布中的方差。其决定了theta距离0的位置。也就是说该权重的重要程度。而加上先验分布可以带来更好的收敛性。
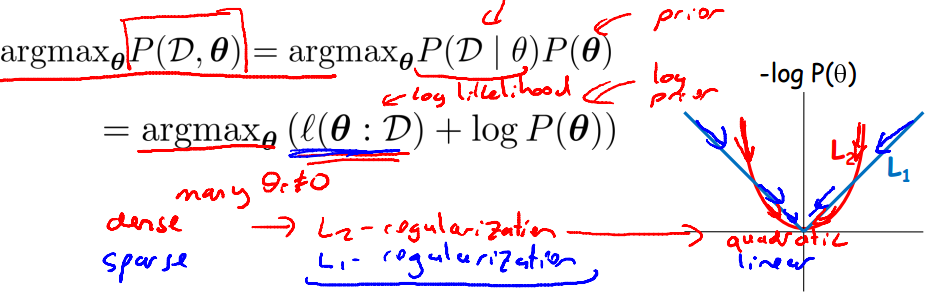
如图所示,log函数相当于是一个regularity.在theta被训练集改变的时候,给其一个趋于0的趋势。
1、拉普拉斯先验是L1 - regularization, 其有更强的趋势将数据拉向0, 所以利用拉普拉斯先验得到参数会更加稀疏,参数的稀疏性代表fi函数没什么用。换言之,图中连接label和x的边无关紧要,可以去除。
2、高斯先验相当于L2 - regularization. 也可以用于对抗过拟合。
机器学习 —— 概率图模型(学习:CRF与MRF)的更多相关文章
- 概率图模型学习笔记:HMM、MEMM、CRF
作者:Scofield链接:https://www.zhihu.com/question/35866596/answer/236886066来源:知乎著作权归作者所有.商业转载请联系作者获得授权,非商 ...
- 机器学习 —— 概率图模型(Homework: CRF Learning)
概率图模型的作业越往后变得越来越有趣了.当然,难度也是指数级别的上涨啊,以至于我用了两个周末才完成秋名山神秘车牌的寻找,啊不,CRF模型的训练. 条件随机场是一种强大的PGM,其可以对各种特征进行建模 ...
- 机器学习 —— 概率图模型(Homework: MCMC)
除了精确推理之外,我们还有非精确推理的手段来对概率图单个变量的分布进行求解.在很多情况下,概率图无法简化成团树,或者简化成团树后单个团中随机变量数目较多,会导致团树标定的效率低下.以图像分割为例,如果 ...
- 机器学习 —— 概率图模型(Homework: Structure Learning)
概率图的学习真的要接近尾声了啊,了解的越多越发感受到它的强大.这周的作业本质上是data mining.从数据中学习PGM的结构和参数,完全使用数据驱动 —— No structure, No par ...
- 机器学习 —— 概率图模型(Homework: Exact Inference)
在前三周的作业中,我构造了概率图模型并调用第三方的求解器对器进行了求解,最终获得了每个随机变量的分布(有向图),最大后验分布(双向图).本周作业的主要内容就是自行编写概率图模型的求解器.实际上,从根本 ...
- 机器学习 —— 概率图模型(Homework: Representation)
前两周的作业主要是关于Factor以及有向图的构造,但是概率图模型中还有一种更强大的武器——双向图(无向图.Markov Network).与有向图不同,双向图可以描述两个var之间相互作用以及联系. ...
- 机器学习 —— 概率图模型(Homework: StructuredCPD)
Week2的作业主要是关于概率图模型的构造,主要任务可以分为两个部分:1.构造CPD;2.构造Graph.对于有向图而言,在获得单个节点的CPD之后就可依据图对Combine CPD进行构造.在获得C ...
- 机器学习 —— 概率图模型(Homework: Factors)
Talk is cheap, I show you the code 第一章的作业主要是关于PGM的因子操作.实际上,因子是整个概率图的核心.对于有向图而言,因子对应的是CPD(条件分布):对无向图而 ...
- 机器学习 —— 概率图模型(CPD)
CPD是conditional probability distribution的缩写,翻译成中文叫做 条件概率分布.在概率图中,条件概率分布是一个非常重要的概念.因为概率图研究的是随机变量之间的练习 ...
随机推荐
- Python-Day4 Python基础进阶之生成器/迭代器/装饰器/Json & pickle 数据序列化
一.生成器 通过列表生成式,我们可以直接创建一个列表.但是,受到内存限制,列表容量肯定是有限的.而且,创建一个包含100万个元素的列表,不仅占用很大的存储空间,如果我们仅仅需要访问前面几个元素,那后面 ...
- EHCache 实现通用类 CacheManager
package com.zhubaje.api.workflow.ehcache; import java.io.Serializable; import java.util.ArrayList; i ...
- ORA-00054
系统版本: [root@yoon ~]# more /etc/oracle-releaseOracle Linux Server release 5.7 数据库版本: Oracle Database ...
- Cannot resolve the collation conflict between "SQL_Latin1_General_CP1_CI_AS" and "Latin1_General_100_CI_AS" in the equal to operation.
ErrorMessage Cannot resolve the collation conflict between "SQL_Latin1_General_CP1_CI_AS" ...
- python之量的概念
程序设计语言: 量的类型: 1. 直接量 2. 常量 3. 变量 量的因素: 1. 存储类别 2. 数据类型 3. 作用域 4. 生存期
- Andriod WIFI驱动模块
一:什么是WIFI WIFI是一种无线连接技术,可用于手机.电脑.PDA等终端.WIFI技术产生的目的是改善基于IEEE802.11标准的无线网络产品之间的互通性,也就是说WIFI是基于802.11标 ...
- 编译时和运行时、OC中对象的动态编译机制
编译时 编译时顾名思义就是正在编译的时候.那啥叫编译呢?就是编译器帮你把源代码翻译成机器能识别的代码.(当然只是一般意义上这么说,实际上可能只是翻译成某个中间状态的语言.比如Java只有JVM识别的字 ...
- beego 0.9.0 中智能路由AutoRouter的使用方法及源码解读
了解beego的开发者肯定知道,beego的路由设计来源于sinatra,原来是不支持自动路由的,每一个路由都要自己配置的,如: type MainController struct { beego. ...
- 1965: [Ahoi2005]SHUFFLE 洗牌 - BZOJ
Description 为了表彰小联为Samuel星球的探险所做出的贡献,小联被邀请参加Samuel星球近距离载人探险活动. 由于Samuel星球相当遥远,科学家们要在飞船中度过相当长的一段时间,小联 ...
- Codeforces Round #240 (Div. 2)->A. Mashmokh and Lights
A. Mashmokh and Lights time limit per test 1 second memory limit per test 256 megabytes input standa ...