
Python爬虫(小练习)
近日,在浏览伯乐在线(http://blog.jobbole.com/29281/)的时候碰到一些很不错的资源:25本免费的Python电子书
如下图:
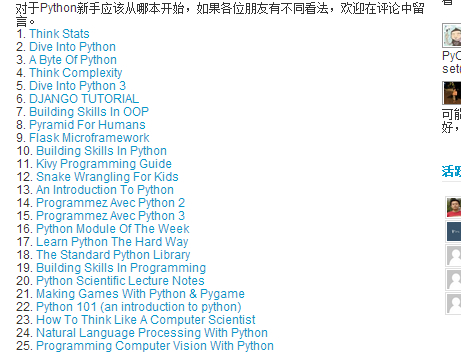
其中,每本都是以名字+超链接的方式,于是激起了我写个小程序保存这些资源的欲望,顺便也能练习一些不太熟练的小爬虫 : ) 。 好了,我们开始吧!
先展示一下成果给大家看嗯: 如图
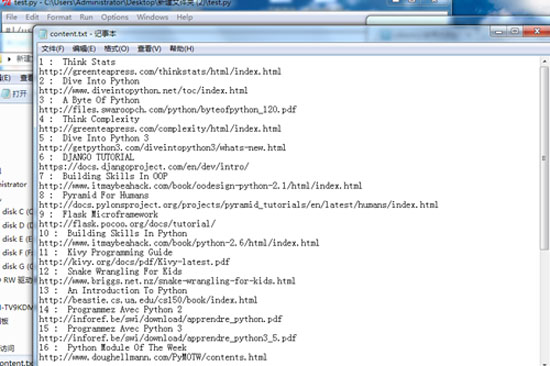
每本书都很有条理的保存在本地文档中,结果还是挺满意的哈。
首先呢 要完成这些工作大概要分为一下几个步骤:
1. 获得整个页面的源代码 (网页源码HTML)
2. 获得目标区域的源代码 (缩小范围)
3. 在小范围内匹配资源的URL
4. 将匹配到的资源URL写入到本地保存
下面,将分为4个步骤来分部展示Python程序
第一,获得整个页面的源代码:
 def getHtml(url):

     html = urllib.urlopen(url)

     sorce = html.read()

     return sorce
该段代码将返回资源所在的整个页面的HTML源代码
第二,获得目标区域的源代码 (缩小范围):
 def getRange(content):

     start0 = content.find(r'<div class="entry">')

     start = content.find(r'<ol>',start0)

     end = content.find(r'<div id="ad1">',start)

     content2 = content[start:end]

     return content2
第三,匹配资源的URL:
 def getLink(content2):

     reg = re.compile(r'<a href="(.*?[.html|.pdf]?)" target=')

     result = reg.findall(content2)

     return result

 def getName(content2):

     reg = re.compile(r'<a href=".*?[.html|.pdf]?" target="_blank">(.*?)</a>')

     result2 = reg.findall(content2)

     return result2
以上俩个函数分别用来匹配资源的 链接 和 书名
第四,保存到本体:
即是在print 的基础上从定向到文件中。详见下面的完整代码 : )
下面是完整代码:
 #!/usr/bin/env python

 #coding:utf-8

 import urllib

 import re

 def getHtml(url):

     html = urllib.urlopen(url)

     sorce = html.read()

     return sorce

 def getRange(content):

     start0 = content.find(r'<div class="entry">')

     start = content.find(r'<ol>',start0)

     end = content.find(r'<div id="ad1">',start)

     content2 = content[start:end]

     return content2

 def getLink(content2):

     reg = re.compile(r'<a href="(.*?[.html|.pdf]?)" target=')

     result = reg.findall(content2)

     return result

 def getName(content2):

     reg = re.compile(r'<a href=".*?[.html|.pdf]?" target="_blank">(.*?)</a>')

     result2 = reg.findall(content2)

     return result2

 if __name__ == '__main__':

     content = getHtml(r'http://blog.jobbole.com/29281/')

     content2 = getRange(content)

     link = getLink(content2)

     name = getName(content2)

     i = 1

     f = open('content.txt','w+')

     for x, y in zip(name, link):

         print >>f, str(i),": ",x,

         print >>f

         print >>f,y

         i = i + 1
看到这里您辛苦了,谢谢 : )
—————————————————————————————————————————————————————————————————————————————
声明:
本文为 大Yi巴狼 对自己所学的知识整理和实现。
本文档欢迎自由转载,但请务必保持本文档完整或注明来之本文档。本文档未经 大Yi巴狼 同意,不得用于商业用途。最后,如果您能从这个简单文档里获得些许帮助,大Yi巴狼 将对自己的一点努力感到非常高兴;由于作者本人水平有限,如果本文档中包含的错误给您造成了不便,在此提前说声抱歉。
祝身体健康,工作顺利。
Python爬虫(小练习)的更多相关文章
- 一个python爬虫小程序
起因 深夜忽然想下载一点电子书来扩充一下kindle,就想起来python学得太浅,什么“装饰器”啊.“多线程”啊都没有学到. 想到廖雪峰大神的python教程很经典.很著名.就想找找有木有pdf版的 ...
- 适合新手的Python爬虫小程序
介绍:此程序是使用python做的一个爬虫小程序 爬取了python百度百科中的部分内容,因为这个demo是根据网站中的静态结构爬取的,所以如果百度百科词条的html结构发生变化 需要修改部分内容. ...
- python爬虫小实例
1.python爬取贴吧壁纸 1.1.获取整个页面数据 #coding=utf-8 import urllib def getHtml(url): page = urllib.urlopen(url) ...
- 找python爬虫小项目?github给你准备好了!
前言 即使我们都是程序员,但我们也并非都会修电脑,都会做酷炫的ppt,都会优化系统卡顿.其实程序员也是分行业.分专业的,就像医生也分内外科.呼吸科.神经科神的. 作为非专业的python选手,或者非专 ...
- Python爬虫小实践:爬取任意CSDN博客所有文章的文字内容(或可改写为保存其他的元素),间接增加博客访问量
Python并不是我的主业,当初学Python主要是为了学爬虫,以为自己觉得能够从网上爬东西是一件非常神奇又是一件非常有用的事情,因为我们可以获取一些方面的数据或者其他的东西,反正各有用处. 这两天闲 ...
- Python爬虫小实践:寻找失踪人口,爬取失踪儿童信息并写成csv文件,方便存入数据库
前两天有人私信我,让我爬这个网站,http://bbs.baobeihuijia.com/forum-191-1.html上的失踪儿童信息,准备根据失踪儿童的失踪时的地理位置来更好的寻找失踪儿童,这种 ...
- 4.Python爬虫小案例
1.网络爬虫定义:按照一定的规则,自动的抓取网站信息的程序或者脚本. 2.流程:request打开url得到html文档==浏览器打开源码分析元素节点==通过BeautifulSoup得到想要的数据= ...
- python 爬虫小案例
爬取百度贴吧帖子信息 #!/usr/bin/env python # -*- coding: utf-8 -*- # author: imcati import requests,re,time cl ...
- python爬虫小项目实战
- GitHub 上有哪些优秀的 Python 爬虫项目?
目录 GitHub 上有哪些优秀的 Python 爬虫项目? 大型爬虫项目: 实用型爬虫项目: 其它有趣的Python爬虫小项目: GitHub 上有哪些优秀的 Python 爬虫项目? 大型爬虫项目 ...
随机推荐
- 【分享】4412开发板-嵌入式Linux开发须要掌握的基础知识和技能
本文转自迅为电子论坛:http://www.topeetboard.com 1.Linux 基础 安装Linux操作系统 Linux文件系统 Linux经常使用命令 Linux启动过程具体解释 熟悉L ...
- c++简单的ATL COM开发和调用实例(转)
c++简单的ATL COM开发和调用实例 1.打开VS2010,新建ATL COM 项目,步骤:“文件” -->“新建” -->“项目”,选择“Visual C++” -->“ATL ...
- C#解决微信支付Exception has been thrown by the target of an invocation(调用的目标发生了异常)的问题
今天搭建微信扫码支付环境的时候,一样的配置参数,调用连接提示错误 错误:调用的目标发生了异常 然后跟踪到执行 MD5 md5 = System.Security.Cryptography.MD5.Cr ...
- Listview实现分页下载
分析: * 1.初始控件,展示第一页数据 * 2.设置触发条件 * 1.设置滚动监听 * 2.判断是否在底部 * 3.判断是否停止滚动 * 4.更改网络请求参数为下一页 * 5.异步网络请求 * 6. ...
- nmblookup
域网内可以通过下述命令来根据ip地址查询其他主机名(Linux) 使用nmblookup -A ip命令查询 [admin@v015213 ~/lpmall]$ nmblookup -A 10.19. ...
- jemalloc源码结构分析(三):arena_malloc_small内存分布
在arena_s结构中,由NBINS数组将bin按照不同规模等级分别存储,每一个等级对应一颗run树,即一颗以chunk_map_t为节点的红黑树,而这些chunk_map_t节点实际分布于各个chu ...
- nfs文件系统挂载失败解决方法
nfs文件系统挂载失败解决方法 */--> nfs文件系统挂载失败解决方法 Table of Contents 1. 错误提示 2. 我的配置 1 错误提示 bootserver=255.255 ...
- 春&风
流光飞舞中,消逝的背影连同流动的人群,早已荒凉. 谁是谁的谁?落入尘世间,只是光阴下面的一粒尘埃. 那些时光,那些爱,渐行渐远. 留在心底,淡淡的思念,如轻风一阵, 吹过 彼此的容颜.
- override和new的区别【摘】
override 1. override是派生类用来重写基类中方法的: 2. override不能重写非虚方法和静态方法: 3. override只能重写用virtual.abstract.overr ...
- ASP.Net_入门准备
基础篇:(学习能力取决于你的基础扎不扎实) 第一步 掌握一门.NET面向对象语言,C#或VB.NET 我强烈反对在没系统学过一门面向对象(OO)语言的前提下去学ASP.NET. ASP.NET是一个全 ...