
Hive执行计划之只有map阶段SQL性能分析和解读
目录
概述
可能所有的SQLboy刚接触SQL语句的时候都是select xxx from xxx where xxx。在hive中,我们把这种语句称为select-from-where型语句,也可称为简单SQL,这类简单SQL是特指不含有变转换函数,聚合函数,开窗函数和连接操作的SQL语句。
这类SQL主要特征是只有map阶段,没有reduce阶段。
本文分析一下这类简单SQL执行计划和性能,让我们从最基础的SQL分析,hive简单语句select from where 型语句性能分析,逐渐深入,进而学会分析复杂SQL的性能和执行计划。
所有的复杂SQL(几百行?上千行?)都是由一个个简单SQL带一些特殊函数堆叠而成的。
1.不带函数操作的select-from-where型简单SQL
这类SQL语句通常只有select-from-where,没有其他函数操作,或者操作符处理,例如字符串截取。
1.1执行示例
例1 不带函数操作的select-from-where型简单SQL。
-- 本文默认使用mr计算引擎

explain

-- 统计年龄等于30岁的所有昵称

select age,nick from temp.user_info_all

where ymd = '20230505'

and age = 30;
执行执行计划结果:
STAGE DEPENDENCIES:

  Stage-1 is a root stage

  Stage-0 depends on stages: Stage-1

STAGE PLANS:

  Stage: Stage-1

    Map Reduce

      Map Operator Tree:

          TableScan

            alias: user_info_all

            Statistics: Num rows: 32634295 Data size: 783223080 Basic stats: COMPLETE Column stats: NONE

            Filter Operator

              predicate: (age = 30) (type: boolean)

              Statistics: Num rows: 16317147 Data size: 391611528 Basic stats: COMPLETE Column stats: NONE

              Select Operator

                expressions: 30 (type: bigint), nick (type: string)

                outputColumnNames: _col0, _col1

                Statistics: Num rows: 16317147 Data size: 391611528 Basic stats: COMPLETE Column stats: NONE

                File Output Operator

                  compressed: true

                  Statistics: Num rows: 16317147 Data size: 391611528 Basic stats: COMPLETE Column stats: NONE

                  table:

                      input format: org.apache.hadoop.mapred.SequenceFileInputFormat

                      output format: org.apache.hadoop.hive.ql.io.HiveSequenceFileOutputFormat

                      serde: org.apache.hadoop.hive.serde2.lazy.LazySimpleSerDe

  Stage: Stage-0

    Fetch Operator

      limit: -1

      Processor Tree:

        ListSink
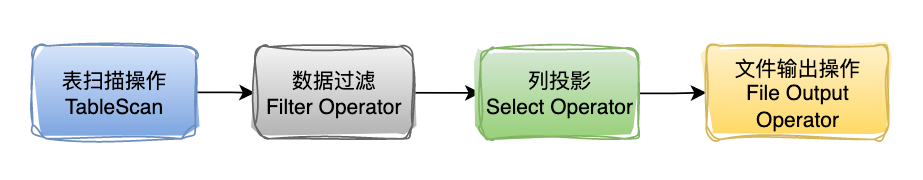
通过以上内容,我们可以看到,整个SQL逻辑执行过程中只有map操作树(Map Operate Tree),若转换成MapReduce来看的话,即只有Map阶段的任务。
如果有执行计划里关键词不熟悉的,建议阅读这篇 Hive执行计划之一文读懂Hive执行计划 。
1.2 运行逻辑分析
以上流程我们可以分解为运行逻辑图来看,如下图:
我们在之前的文章中提起过,Hive执行计划是一个预估的执行计划,只有在SQL实际执行后才会获取到真正的执行计划。那我们来看看以上语句的实际运行控制台打印过程。额,失算了,因为结果太多,限制一下输出条数。
Query ID = hdfs_20230613111158_03c8f6e1-e04f-4e4e-aa9b-569a89860438

Total jobs = 1

Launching Job 1 out of 1

# 这里表示没有reduce任务,reduce任务执行的服务器节点是0个。

Number of reduce tasks is set to 0 since there's no reduce operator

...

Hadoop job information for Stage-1: number of mappers: 6; number of reducers: 0

2023-06-13 11:12:28,564 Stage-1 map = 0%,  reduce = 0%

2023-06-13 11:12:45,219 Stage-1 map = 17%,  reduce = 0%, Cumulative CPU 6.17 sec

...

2023-06-13 11:12:54,523 Stage-1 map = 100%,  reduce = 0%, Cumulative CPU 40.52 sec

MapReduce Total cumulative CPU time: 40 seconds 520 msec

Ended Job = job_1675664438694_14052273

MapReduce Jobs Launched:

Stage-Stage-1: Map: 6   Cumulative CPU: 40.52 sec   HDFS Read: 203436481 HDFS Write: 2412 SUCCESS

Total MapReduce CPU Time Spent: 40 seconds 520 msec
从上面的结果可以知道,实际的运行过程也是只有map阶段的操作。
针对select-from-where只有map阶段操作而没有reduce阶段的主要原因是这类SQL只有从表中读取数据并执行数据行的过滤,并没有需要将HDFS在其他节点上的数据与该节点数据放在一起处理的必要,因此这类SQL不需要reduce操作。Map阶段过滤后的数据,就是最终的结果数据。
这种只含map的操作,如果文件大小控制在合适的情况下,都将只有本地操作,其执行非常高效,运行效率完全不输于在计算引擎Tez和Spark上运行。感兴趣的小伙伴可以去将三者运行效率比对一下。
1.3 伪代码解释
接下来我们再以mr伪代码的方式理解一下上述语句的运行情况:
例2 MRselect-from-where简单SQL代码解析
map(inkey,invalue,context);

colsArray = invalue.split("\t");

//对应filter操作,过滤掉age=30的数据行,ymd为分区列,属于文件级操作,这里不展示了。

if int(colsArray[11]) == 30 {

  //获取age,nick两列,就是投影操作,即select操作

  age = colsArray[11];

  nick = colsArray[7];

  //最后输出两列age,nick,执行计划中对应的为_col0和_col1.这里invalue为1

  context.write(age,nick);

}

reduce(inkey,invalue,context)

  //pass表示不会执行

  pass;
2.带普通函数和运行操作符的普通型SQL执行计划解读
这里的普通函数特指除表转换函数(UDTF),聚合函数和窗口函数之外的函数。例如:nvl(),cast(),case when,concat(),year()等,具体有哪些,后续会专门罗列。
这类SQL也属于select-from-where型SQL,其主要特点也是只有map阶段处理。
我们也可以给它更具体的称为 select-function(column)-from-where-function(column)类。
2.1 执行计划解读
接下来可以看一个带普通函数和操作符的SQL执行计划案例。
例3 带普通函数和操作符的SQL运行计划。
explain

-- 统计年龄等于30岁的所有昵称

select uid,

nvl(client,'android') as client,

case when age > 20 then '老腊肉' else '小鲜肉' end as label,

concat(nick,'_测试') as nick,

cast(chat_uv as double)/10 as chat

from temp.user_info_all

where ymd = '20230505'

and age in (18,19,20,21) and chat_uv is not null and substr(uid,0,1) = '1';
输出的执行计划结果:
STAGE DEPENDENCIES:

  Stage-1 is a root stage

  Stage-0 depends on stages: Stage-1

STAGE PLANS:

  Stage: Stage-1

    Map Reduce

      Map Operator Tree:

          TableScan

            alias: user_info_all

            Statistics: Num rows: 32634295 Data size: 783223080 Basic stats: COMPLETE Column stats: NONE

            # where 条件过滤

            Filter Operator

              predicate: ((age) IN (18, 19, 20, 21) and chat_uv is not null and (substr(uid, 0, 1) = '1')) (type: boolean)

              Statistics: Num rows: 8158574 Data size: 195805776 Basic stats: COMPLETE Column stats: NONE

              # 列投影

              Select Operator

                expressions: uid (type: bigint), NVL(client,'android') (type: string), CASE WHEN ((age > 20)) THEN ('老腊肉') ELSE ('小鲜肉') END (type: string), concat(nick, '_测试') (type: string), (UDFToDouble(chat_uv) / 10) (type: double)

                outputColumnNames: _col0, _col1, _col2, _col3, _col4

                Statistics: Num rows: 8158574 Data size: 195805776 Basic stats: COMPLETE Column stats: NONE

                File Output Operator

                  compressed: true

                  Statistics: Num rows: 8158574 Data size: 195805776 Basic stats: COMPLETE Column stats: NONE

                  table:

                      input format: org.apache.hadoop.mapred.SequenceFileInputFormat

                      output format: org.apache.hadoop.hive.ql.io.HiveSequenceFileOutputFormat

                      serde: org.apache.hadoop.hive.serde2.lazy.LazySimpleSerDe

  Stage: Stage-0

    Fetch Operator

      limit: -1

      Processor Tree:

        ListSink
通过以上执行计划我们可以看到,这个结果同select-from-where 型SQL,只有map阶段的操作,如果实际去运行以上任务,得到的执行步骤也和例1类似。即在map运行完整个作业任务结束。
结合以上实例我们可以得出一个结论 select-function(colums)-from-where-function(column)这种类型的SQL可以归于select-from-where类简单SQL类型。
2.2 伪代码解释逻辑
例4 例2的MapReduce伪代码执行逻辑。
//整个程序只有map阶段,没有reduce逻辑

map(inkey,invalue,context);

//数据输入是一行数据

colsArray = invalue.split("\t");

if age in (18,19,20,21) and chat_uv != null and substr(uid, 0, 1) == '1'{

  uid = colsArray[0];

  client = colsArray[3];

  if client == null{

    client = 'android';

  }

  label = '';

  if age > 20 {

    label = '老腊肉';

  } else {

    label = '小鲜肉';

  }

  nick = nick+'_测试');

  chat = double(chat_uv)/10;

}

context.write(uid,client+'\t'+label+'\t'+nick+'\t'+chat);
下一期:Hive常见时间函数的使用与问题整理
按例,欢迎点击此处关注我的个人公众号,交流更多知识。
后台回复关键字 hive,随机赠送一本鲁边备注版珍藏大数据书籍。
Hive执行计划之只有map阶段SQL性能分析和解读的更多相关文章
- Mysql高级操作学习笔记:索引结构、树的区别、索引优缺点、创建索引原则(我们对哪种数据创建索引)、索引分类、Sql性能分析、索引使用、索引失效、索引设计原则
Mysql高级操作 索引概述: 索引是高效获取数据的数据结构 索引结构: B+Tree() Hash(不支持范围查询,精准匹配效率极高) 树的区别: 二叉树:可能产生不平衡,顺序数据可能会出现链表结构 ...
- hive执行计划简单分析
原始SQL: select a2.ISSUE_CODE as ISSUE_CODE, a2.FZQDM as FZQDM, a2.FZQLB as FZQLB, a2.FJJDM as FJJDM, ...
- sqlser 2005 使用执行计划来优化你的sql
一:sqlserver 执行计划介绍 sqlserver 执行计是在sqlser manager studio 工具中打开,是检查一条sql执行效率的工具.建议配合SET STATISTICS ...
- SQL性能分析之执行计划
一直想找一些关于SQL语句性能调试的权威参考,但是有参考未必就能够做好调试的工作.我深信实践中得到的经验是最珍贵的,书本知识只是一个引导.本篇来源于<Inside Microsoft SQL S ...
- MySQL— 索引,视图,触发器,函数,存储过程,执行计划,慢日志,分页性能
一.索引,分页性能,执行计划,慢日志 (1)索引的种类,创建语句,名词补充(最左前缀匹配,覆盖索引,索引合并,局部索引等): import sys # http://www.cnblogs.com/w ...
- SQL性能分析
MySQL常见瓶颈: CPU:CPU在饱和的时候一般发生在数据装入内存或从磁盘上读取数据的时候. IO:磁盘I/O瓶颈发生在装入数据远大于内存容量的时候. 服务器硬件的性能瓶颈:top.free.io ...
- oracle SQL性能分析之10053事件
优化器生成正确执行计划的前提条件是要有正确的统计信息,不准确的统计信息往往会导致错误的执行计划.当通过SQL和基数推断出的执行计划和实际执行计划不同时,就可以借助10053事件.10053事件是用来诊 ...
- 单条sql性能分析与优化
性能分析 1. explain 查看sql执行计划,得出索引使用情况等信息 2. show profiling 查看sql所有执行步骤以及用时,使用步骤如下 1)开启性能剖析 mysql> se ...
- sql性能分析(explain关键字)
explain关键字结果 列名所代表的的含义: Id:MySQL QueryOptimizer 选定的执行计划中查询的序列号.表示查询中执行 select 子句或操作表的顺序,id 值越大优先级越高, ...
- 【转】Hive执行计划
执行语句 hive> explain select s.id, s.name from student s left outer join student_tmp st on s.name = ...
随机推荐
- 探究平台化设计的核心思想和Lattice的设计原则
一. 平台对业务敏捷支撑的挑战 早期阿里的交易中台遇到了一些挑战,这个在毗卢的博客中有提到,主要遇到了这些问题:新小业务都有一个成长规律,在早期业务模式验证阶段,需要的玩法比较简单,希望能频繁的发布快 ...
- 重打包APK绕过签名校验
这里先提一种针对性校强但简单好理解的办法,纯Java实现,代码大概也就50行不到吧. 还有更强的并且能过各种保护(反调试反HOOK反内存修改等等)的万能方法,不过较复杂,长篇大论的,等有空整理出来再提 ...
- 关于Java中的异常处理(详细)
Error:Java虚拟机无法解决的严重问题.如:JVM系统内部错误.资源耗尽等严重情况.比如:StackOverflowError和OOM.一般不编写针对性的代码进行处理 Exception:其它因 ...
- 每日复习——static , 饿汉式方法,懒汉式方法,以及单例设计模式
1.1.static 的使用 当我们编写一个类时,其实就是在描述其对象的属性和行为,而并没有产生实质上的对象,只有通过 new 关键字才会产生出对象,这时系统才会分配内存空间给对象,其方法才可以供外部 ...
- 统计模拟实验—R实现(蒲丰投针)
统计模拟实验 统计模拟是数理统计.和计算机科学的结合,是一门综合性学科.在科学研究和生产实际的各个领域中,普遍存在着大量数据的分析处理工作.如何应用数理统计中的方法来解决实际问题,以及如何解决在应用中 ...
- 非线性规划—R实现
非线性规划 非线性规划是一种求解目标函数或约束条件中有一个或几个非线性函数的最优化问题的方法.运筹学八大分支之一,20世纪50年代初,库哈(H.W.Kuhn) 和托克 (A.W.Tucker) 提出了 ...
- MySQL之 InnoDB 内存结构
从MySQL 5.5版本开始默认 使用InnoDB作为引擎,它擅长处理事务,具有自动崩溃恢复的特性,在日常开发中使用非常广泛 下面是官方的InnoDB引擎架构图,主要分为内存结构和磁盘结构两大部分. ...
- 简单的cs修改器
目录 各个函数解析 main() GetPid() 无限子弹 无限血 无限金币 Patch() 无僵直 稳定射击 Depatch1 手枪连发 Depatch 源代码部分 各个函数解析 这是我根据b站上 ...
- 【Dotnet 工具箱】跨平台图表库 LiveCharts2
你好,这里是 Dotnet 工具箱,定期分享 Dotnet 有趣,实用的工具和组件,希望对您有用! LiveCharts2 LiveCharts2 是一个简单.灵活.交互式以及功能强大的跨平台图表库. ...
- cocos2d-x返回Android游戏黑屏解决办法
返回Android游戏黑屏解决办法这几天逛cocos2d-x.org论坛,发现cocos2d-x的作者放出来一个帖子,用来解决返回Android游戏加载资源时黑屏的问题.帖子过些日子估计就沉了,所以转 ...