
[py]pandas数据统计学习
pandas.core.base.DataError: No numeric types to aggregate错误规避
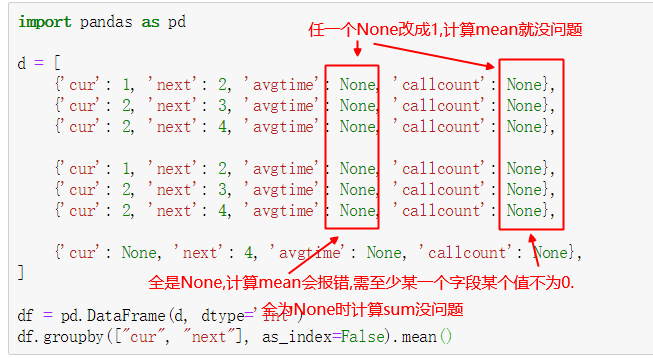
我没有去解决这个问题, 而用填充0规避了这个问题
统计 聚合
d = [
    {'cur': 1, 'next': 2, 'avgtime': None, 'callcount': None},
    {'cur': 2, 'next': 3, 'avgtime': None, 'callcount': None},
    {'cur': 2, 'next': 4, 'avgtime': None, 'callcount': None},

    {'cur': 1, 'next': 2, 'avgtime': None, 'callcount': None},
    {'cur': 2, 'next': 3, 'avgtime': None, 'callcount': None},
    {'cur': 2, 'next': 4, 'avgtime': None, 'callcount': None},

    {'cur': None, 'next': 4, 'avgtime': None, 'callcount': None},
]

df = pd.DataFrame(d, dtype='int')
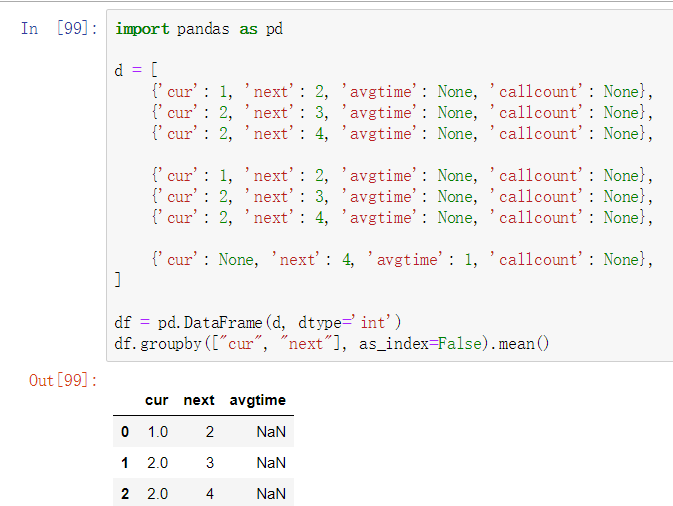
df.groupby(["cur", "next"], as_index=False).mean()
重要总结:
1. None为NaN
2. count会统计空字符串, 但是cont不统计NaN.  sum不统计NaN, 否则就会像sql里select(1+NULL)结果是NULL
3. 分组key为None时,记录不显示
计算mean()时DataError: No numeric types to aggregate
agg函数
使用这种聚合会卡到这个bug
pandas.core.base.DataError: No numeric types to aggregate错误规避
import pandas as pd

d = [
    {'cur': 1, 'next': 2, 'avgtime': None, 'callcount': None},
    {'cur': 2, 'next': 3, 'avgtime': None, 'callcount': None},
    {'cur': 2, 'next': 4, 'avgtime': None, 'callcount': None},

    {'cur': 1, 'next': 2, 'avgtime': None, 'callcount': None},
    {'cur': 2, 'next': 3, 'avgtime': None, 'callcount': None},
    {'cur': 2, 'next': 4, 'avgtime': None, 'callcount': None},

    {'cur': None, 'next': 4, 'avgtime': None, 'callcount': None},
]

df = pd.DataFrame(d, dtype='int')
g = df.groupby(["cur", "next"], as_index=False)
res = g.agg(
    {
        'avgtime': 'sum',
        'callcount': 'mean',
    }
)
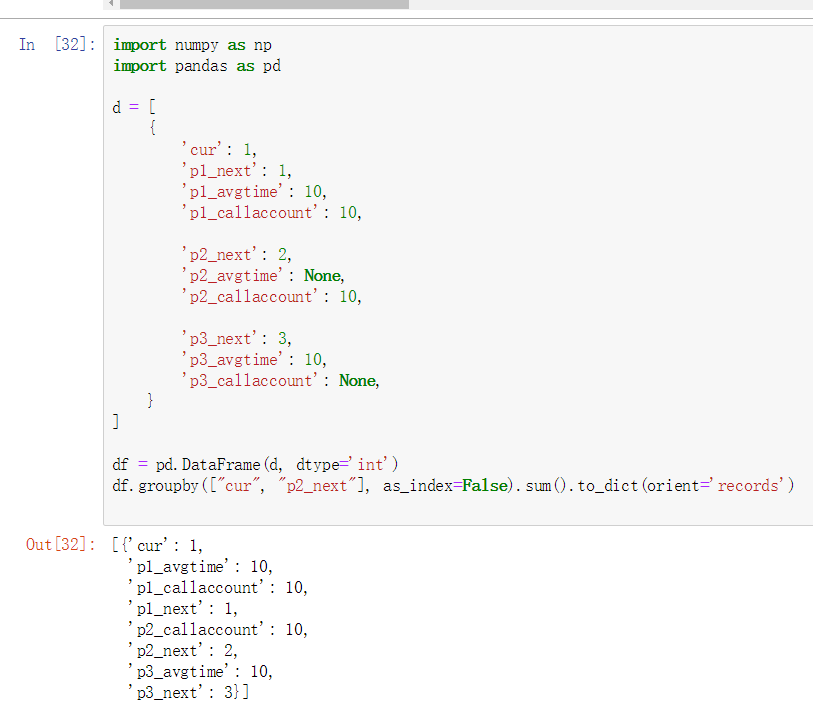
复杂的分组: cur分别与p1 p2 p3分组
import numpy as np
import pandas as pd

d = [
    {
        'cur': 1,
        'p1_next': 1,
        'p1_avgtime': 10,
        'p1_callaccount': 10,

        'p2_next': 2,
        'p2_avgtime': None,
        'p2_callaccount': 10,

        'p3_next': 3,
        'p3_avgtime': 10,
        'p3_callaccount': None,
    }
]

df = pd.DataFrame(d, dtype='int')
df.groupby(["cur", "p2_next"], as_index=False).sum().to_dict(orient='records')
[py]pandas数据统计学习的更多相关文章
- 转载,Pandas 数据统计用法
pandas模块为我们提供了非常多的描述性统计分析的指标函数,如总和.均值.最小值.最大值等,我们来具体看看这些函数: 1.随机生成三组数据import numpy as npimport panda ...
- pandas数据统计
1 count() 非空观测数量 2 sum() 所有值之和 3 mean() 所有值的平均值 4 median() 所有值的中位数 5 mode() 值的模值 6 std() 值的标准偏差 7 mi ...
- (数据科学学习手札69)详解pandas中的map、apply、applymap、groupby、agg
*从本篇开始所有文章的数据和代码都已上传至我的github仓库:https://github.com/CNFeffery/DataScienceStudyNotes 一.简介 pandas提供了很多方 ...
- pandas数据框,统计某列或者某行数据元素的个数
版权声明:本文为博主原创文章,遵循 CC 4.0 by-sa 版权协议,转载请附上原文出处链接和本声明.本文链接:https://blog.csdn.net/sinat_38893241/articl ...
- (数据科学学习手札72)用pdpipe搭建pandas数据分析流水线
1 简介 在数据分析任务中,从原始数据读入,到最后分析结果出炉,中间绝大部分时间都是在对数据进行一步又一步的加工规整,以流水线(pipeline)的方式完成此过程更有利于梳理分析脉络,也更有利于查错改 ...
- 大数据学习day34---spark14------1 redis的事务(pipeline)测试 ,2. 利用redis的pipeline实现数据统计的exactlyonce ,3 SparkStreaming中数据写入Hbase实现ExactlyOnce, 4.Spark StandAlone的执行模式,5 spark on yarn
1 redis的事务(pipeline)测试 Redis本身对数据进行操作,单条命令是原子性的,但事务不保证原子性,且没有回滚.事务中任何命令执行失败,其余的命令仍会被执行,将Redis的多个操作放到 ...
- 大数据学习day33----spark13-----1.两种方式管理偏移量并将偏移量写入redis 2. MySQL事务的测试 3.利用MySQL事务实现数据统计的ExactlyOnce(sql语句中出现相同key时如何进行累加(此处时出现相同的单词))4 将数据写入kafka
1.两种方式管理偏移量并将偏移量写入redis (1)第一种:rdd的形式 一般是使用这种直连的方式,但其缺点是没法调用一些更加高级的api,如窗口操作.如果想更加精确的控制偏移量,就使用这种方式 代 ...
- [译]针对科学数据处理的统计学习教程(scikit-learn教程2)
翻译:Tacey Wong 统计学习: 随着科学实验数据的迅速增长,机器学习成了一种越来越重要的技术.问题从构建一个预测函数将不同的观察数据联系起来,到将观测数据分类,或者从未标记数据中学习到一些结构 ...
- scikit-learning教程(二)统计学习科学数据处理的教程
统计学习:scikit学习中的设置和估计对象 数据集 Scikit学习处理来自以2D数组表示的一个或多个数据集的学习信息.它们可以被理解为多维观察的列表.我们说这些阵列的第一个轴是样本轴,而第二个轴是 ...
随机推荐
- 微信开发getLocation、openLocation等一些功能不起作用,但是走ready方法 closeWindow一些方法可以用
1.检查wx.config,发现我在jsApiList也声明了这些方法,并且也走了ready回调 wx.config({ debug: false, // 开启调试模式,调用的所有api的返回值会在客 ...
- 探索Visual Studio生成的.vs文件夹内部结构和作用
这里直接先将我摸索出的结果贴出来,文章后面会一一详细说明和分析:.vs目录是用来存储当前用户在解决方案中的工作配置,具体包括VS关闭前最后的窗口布局.最后打开的选项卡/操作记录/文件文档.某些自定义配 ...
- net core体系-web应用程序-4asp.net core2.0 项目实战(1)-13基于OnActionExecuting全局过滤器,页面操作权限过滤控制到按钮级
1.权限管理 权限管理的基本定义:百度百科. 基于<Asp.Net Core 2.0 项目实战(10) 基于cookie登录授权认证并实现前台会员.后台管理员同时登录>我们做过了登录认证, ...
- Doctrine2-完整创建数据库
---恢复内容开始--- 下面用Doctrine2设置配置一个数据库,具体分为以下步骤 1.设计主要字段和表 2.配置symfony2和数据库的连接 3.配置Entity,定义类 4.实现get/se ...
- ECMAScript 6 变量的解构赋值
1.数组的结构赋值 1.1 基本用法 可以用“模式匹配”的写法给数组的元素赋值,只要等号两边的模式相同,左边的变量就会被赋予对应的值.注意:元素的值和位置是一一对应关系,如果对应的位置没有值,就会解构 ...
- python基础篇_004_装饰器函数
python装饰器函数 1.装饰器函数引导 功能:计算函数执行时长 import time """ 方式一: 函数首位添加时间,差值就是函数执行时间 缺点:每个函数都要加 ...
- C#使用CefSharp碰到的坑(一)
使用CEFSharp做模拟提交的话,在高版本下会出现一个神奇的错误: 如果站点使用的是阿里提供的验证控件的话,就是那种拖动条的,如果是使用CEFSharp的新版本的(目前我是测试过70的) ,会出现拖 ...
- 软件工程团队:Spring计划会议及详细计划表
极限挑战! 小组Spring计划表: 11.15 进行软件需求分析,了解调查社会背景,确定要编写的软件,分配各小组成员的任务.确定小组会议每天召开地点时间. 3h 11.16 将任务进一步精确分配, ...
- ipdb介绍及Tensor
ipdb介绍 1.现在IPython之外使用debug功能,则需要安装ipdb(pip install ipdb),而后在需要进入调试的地方加上如下代码即可: import ipdb ipdb.set ...
- Java数据库连接与查询
9个步骤: 1.加载数据库驱动: 2.连接数据库: 3.创建语句statement: 5.创建sql语法字符串: 6.执行: 7.如果步骤6是执行新增.修改.删除操作那么返回的是影响的行数,如果是执行 ...