
巧用Grafana和Arthas自动抓取K8S中异常Java进程的线程堆栈
前言
近期发现业务高峰期时刻会出现CPU繁忙导致的timeout异常,通过监控来看是因为Node上面的一些Pod突发抢占了大量CPU导致的。
问: 没有限制CPU吗?是不是限制的CPU使用值就可以解决了呢?
解: 其实不能根本解决这个问题,因为使用的容器引擎是Docker,而Docker是使用了cgroups技术,这就引入了一个老大难的问题,cgroup的隔离性。当问题发生时并没有办法把异常CPU进程直接摁住,而会有短暂的高峰,现象为:限制了CPU为2核,突发时CPU可能是4、5、6等,然后容器会被kill掉,K8S会尝试重建容器。
那么该如何解决?
- 使用隔离性更好的容器引擎,如 kata(VM级别)。
- 优化程序
方案1
我们可以知道方案1解决的比较彻底,而且只需要全局处理一次即可,但技术比较新颖,不知道会不会带来其它问题,我们之后准备拿出部分Node尝试kata container。
方案2
对应用开发者要求比较高,需要对应的开发者针对性介入,短期收益很高,我们先部署了这种。
如何实施?
我们知道程序在运行中,除非特别严重的BUG,CPU高峰一般非常短暂,这时候靠人肉抓包基本上是来不及的,也很耗费精力,我们就希望有一个程序能在CPU达到一定阈值的时候自动抓取线程堆栈来事后针对性优化,并且一定时间内只允许运行一次防止循环抓包导致程序不可用。
根据要实现的最终效果我们发现与Grafana、Prometheus的告警机制十分接近,我们要做的就是接收告警的webhook,去对应的容器中获取线程堆栈就行。
于是我们利用了 Grafana ,写了一个程序来完成这个功能。
项目信息
开发语言: Go、Shell
项目地址: https://github.com/majian159/k8s-java-debug-daemon
k8s-java-debug-daemon
利用了 Grafana 的告警机制,配合阿里的 arthas,来完成高CPU使用率线程的堆栈抓取。
整体流程如下:
- 为 Grafana 添加 webhook 类型的告警通知渠道,地址为该程序的 url(默认的hooks路径为 /hooks)。
- 配置Grafana图表,并设置告警阈值
- 当 webhook 触发时,程序会自动将
craw.sh脚本拷贝到对应 Pod 的容器中并执行。 - 程序将 stdout 保存到本地文件。
效果预览
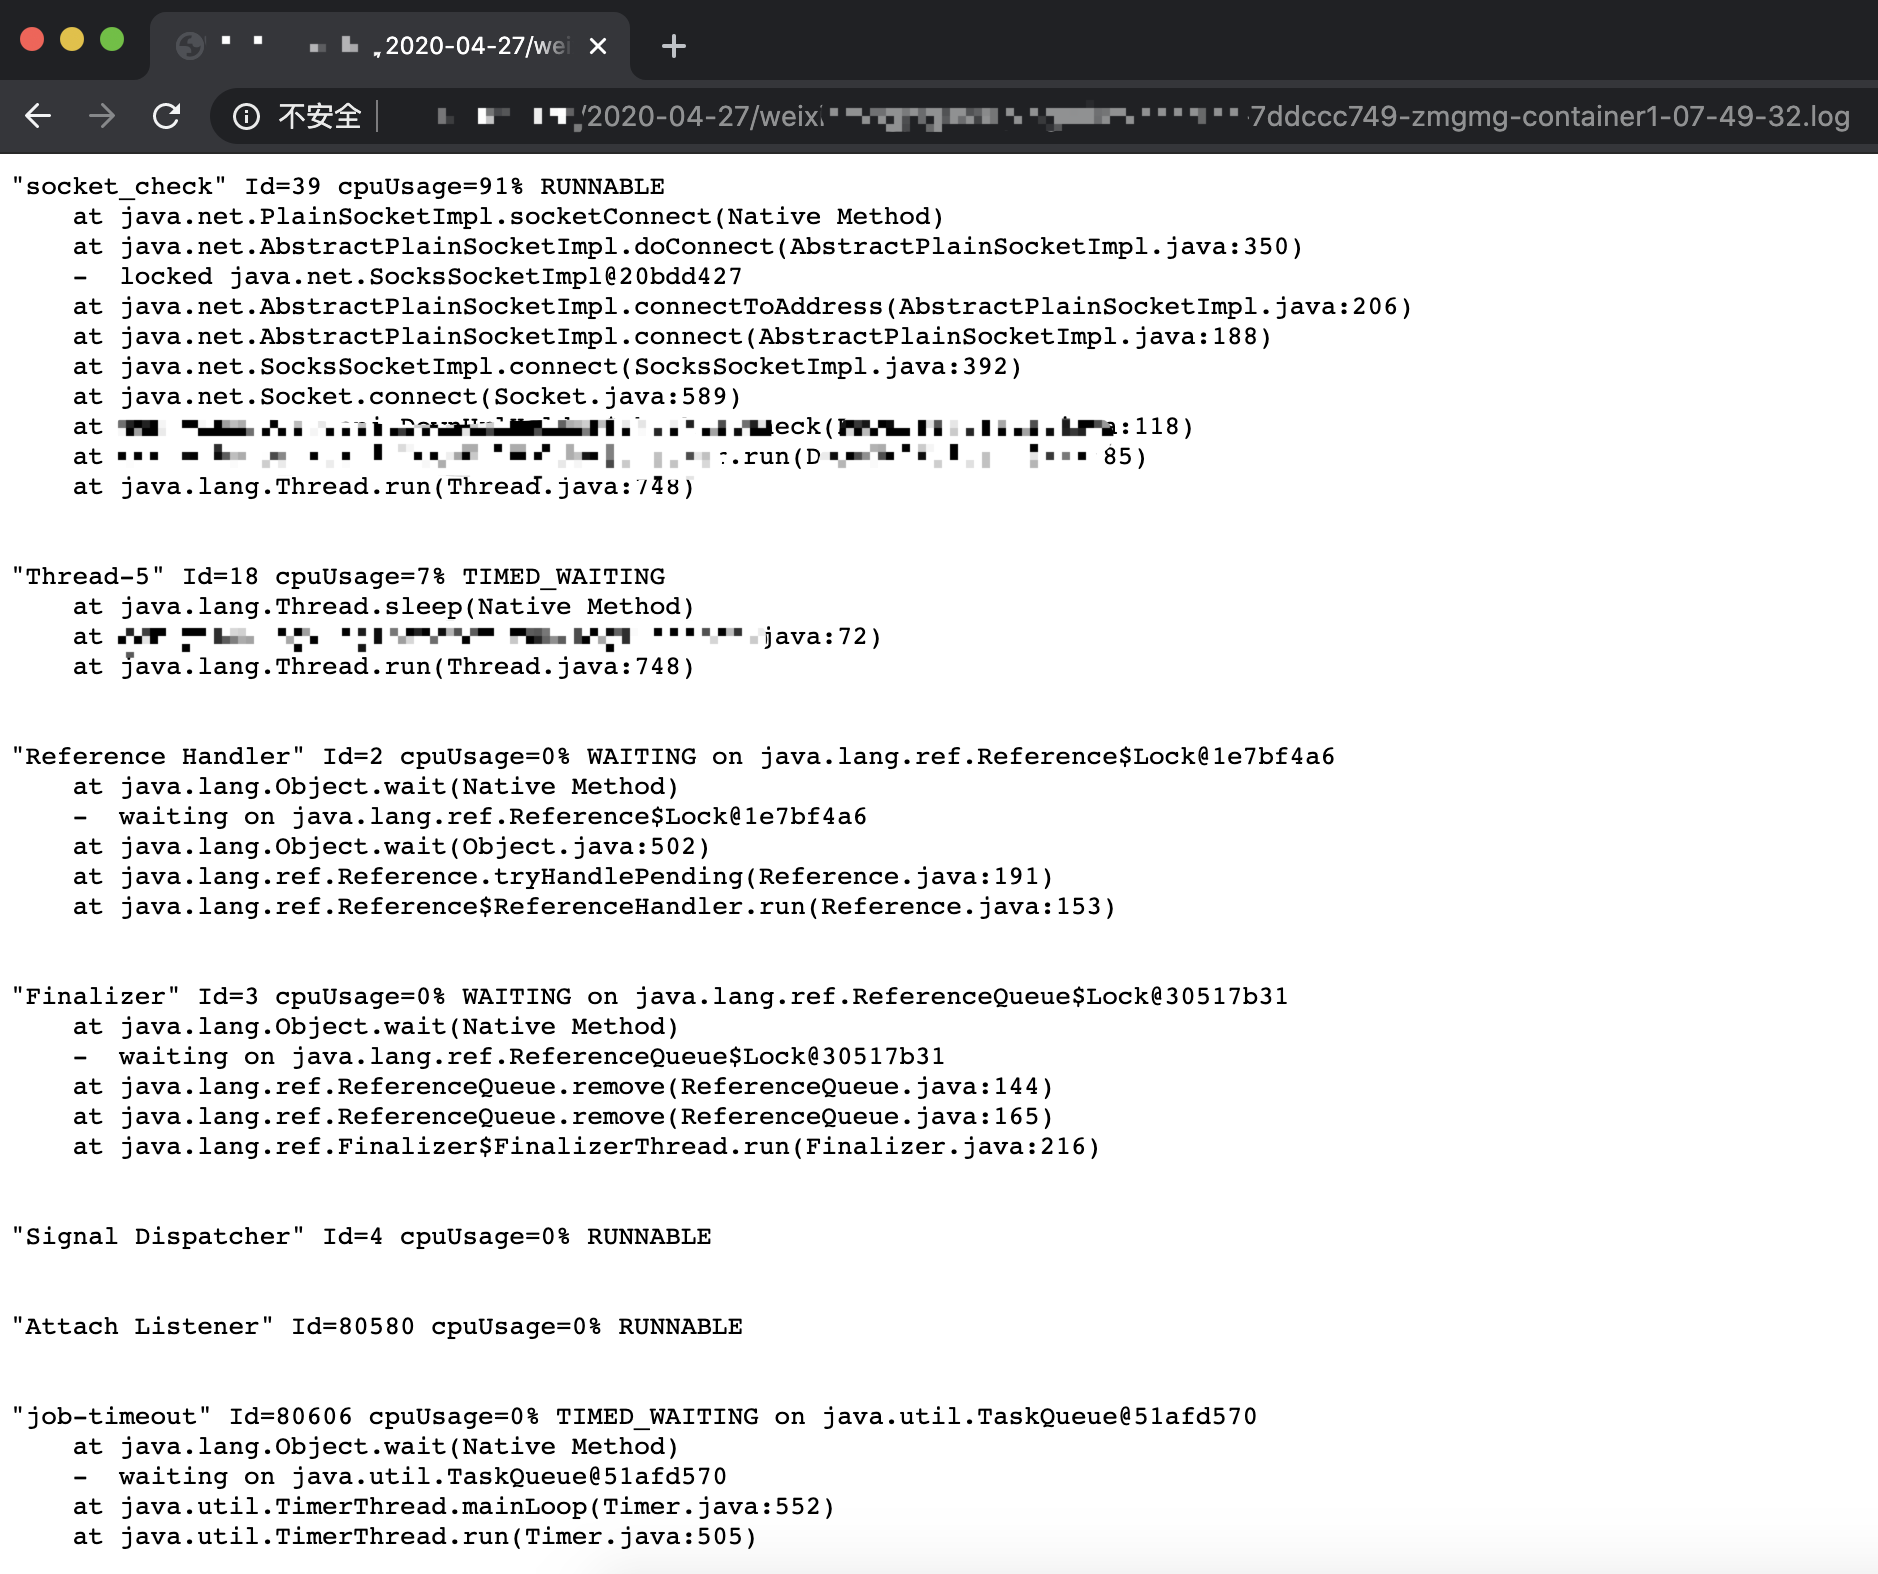
默认行为
- 每 node 同时运行执行数为10
可以在./internal/defaultvalue.go中更改var defaultNodeLockManager = nodelock.NewLockManager(10)
- 默认使用集群内的Master配置
可以在./internal/defaultvalue.go中更改func DefaultKubernetesClient(){} // default
func getConfigByInCluster(){} func getConfigByOutOfCluster(){}
- 默认使用并实现了一个基于本地文件的堆栈存储器, 路径位于工作路径下的
stacks中
可以在./internal/defaultvalue.go中更改func GetDefaultNodeLockManager(){}
- 默认取最繁忙的前50个线程的堆栈信息 (可在
craw.sh中修改) - 采集样本时间为2秒 (可在
craw.sh中修改)
如何使用
Docker Image
为 Grafana 新建一个通知频道
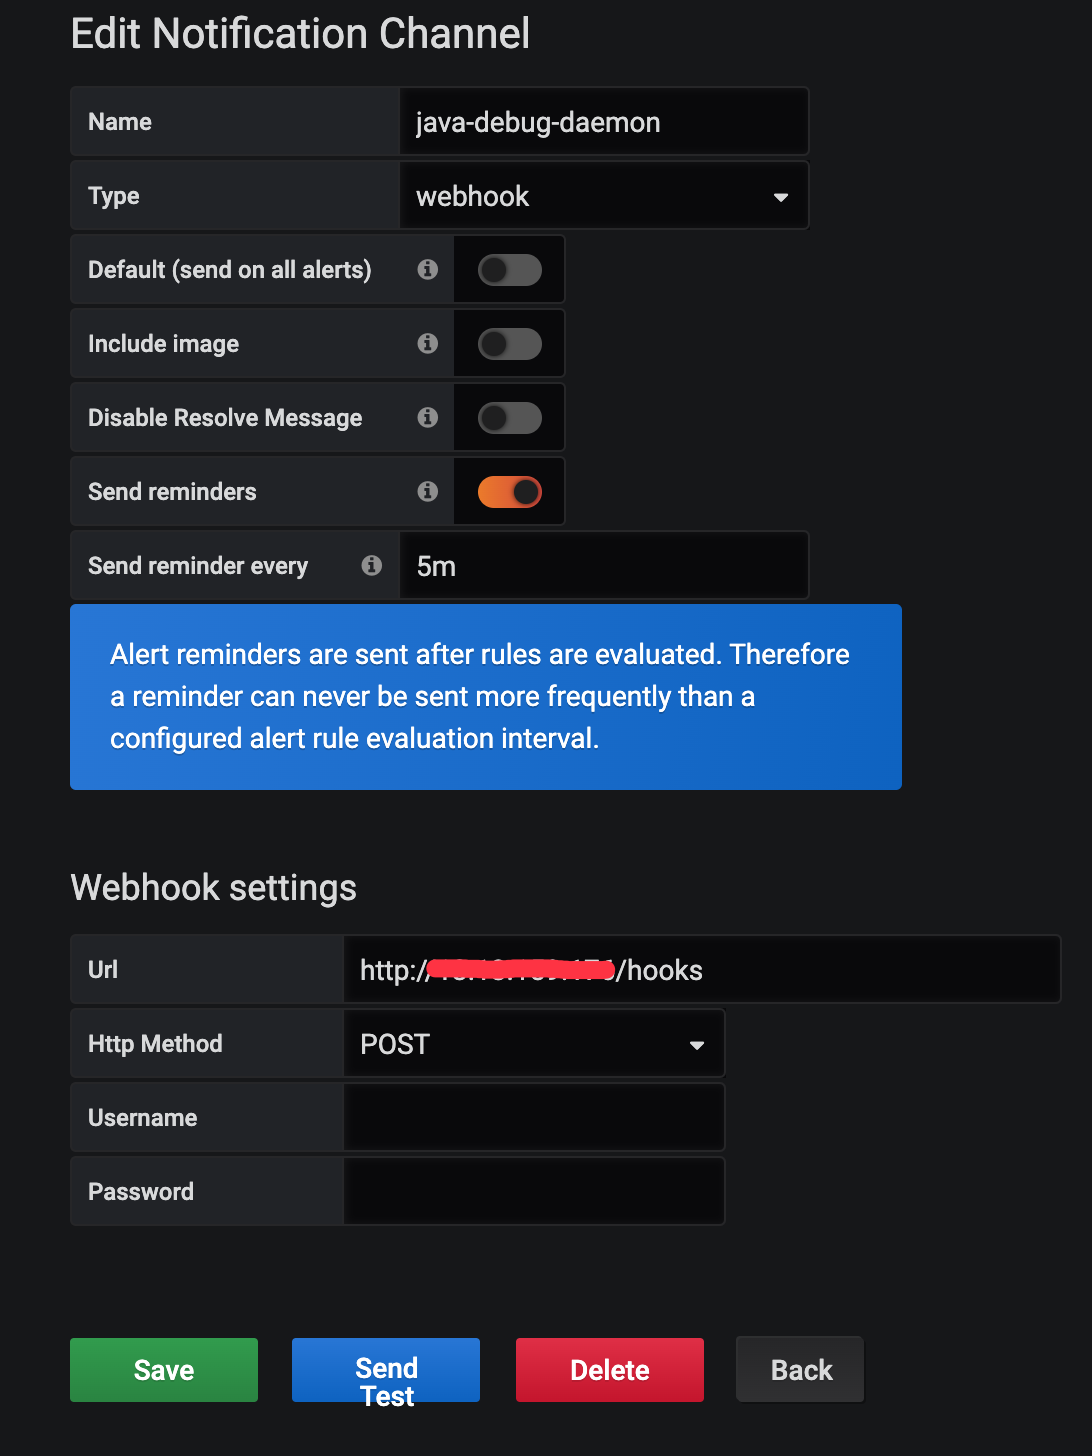
注意点
- 需要打开 Send reminders, 不然 Grafana 默认在触发告警后一直没有解决不会重复发送告警
- Send reminder every 可以控制最快多久告警一次
为 Grafana 新建一个告警图表
如果嫌麻烦可以直接导入以下配置, 在自行更改
{

  "datasource": "prometheus",

  "alert": {

    "alertRuleTags": {},

    "conditions": [

      {

        "evaluator": {

          "params": [

            1

          ],

          "type": "gt"

        },

        "operator": {

          "type": "and"

        },

        "query": {

          "params": [

            "A",

            "5m",

            "now"

          ]

        },

        "reducer": {

          "params": [],

          "type": "last"

        },

        "type": "query"

      }

    ],

    "executionErrorState": "keep_state",

    "for": "10s",

    "frequency": "30s",

    "handler": 1,

    "name": "Pod 高CPU堆栈抓取",

    "noDataState": "no_data",

    "notifications": [

      {

        "uid": "AGOJRCqWz"

      }

    ]

  },

  "aliasColors": {},

  "bars": false,

  "dashLength": 10,

  "dashes": false,

  "fill": 1,

  "fillGradient": 0,

  "gridPos": {

    "h": 9,

    "w": 24,

    "x": 0,

    "y": 2

  },

  "hiddenSeries": false,

  "id": 14,

  "legend": {

    "alignAsTable": true,

    "avg": true,

    "current": true,

    "max": true,

    "min": false,

    "rightSide": true,

    "show": true,

    "total": false,

    "values": true

  },

  "lines": true,

  "linewidth": 1,

  "nullPointMode": "null",

  "options": {

    "dataLinks": []

  },

  "percentage": false,

  "pointradius": 2,

  "points": false,

  "renderer": "flot",

  "seriesOverrides": [],

  "spaceLength": 10,

  "stack": false,

  "steppedLine": false,

  "targets": [

    {

      "expr": "container_memory_working_set_bytes{job=\"kubelet\", metrics_path=\"/metrics/cadvisor\", image!=\"\", container!=\"POD\"}* on (namespace, pod) group_left(node) max by(namespace, pod, node, container) (kube_pod_info)",

      "legendFormat": "{{node}} - {{namespace}} - {{pod}} - {{container}}",

      "refId": "A"

    }

  ],

  "thresholds": [

    {

      "colorMode": "critical",

      "fill": true,

      "line": true,

      "op": "gt",

      "value": 1

    }

  ],

  "timeFrom": null,

  "timeRegions": [],

  "timeShift": null,

  "title": "Pod CPU",

  "tooltip": {

    "shared": true,

    "sort": 0,

    "value_type": "individual"

  },

  "type": "graph",

  "xaxis": {

    "buckets": null,

    "mode": "time",

    "name": null,

    "show": true,

    "values": []

  },

  "yaxes": [

    {

      "format": "short",

      "label": null,

      "logBase": 1,

      "max": null,

      "min": null,

      "show": true

    },

    {

      "format": "short",

      "label": null,

      "logBase": 1,

      "max": null,

      "min": null,

      "show": true

    }

  ],

  "yaxis": {

    "align": false,

    "alignLevel": null

  }

}
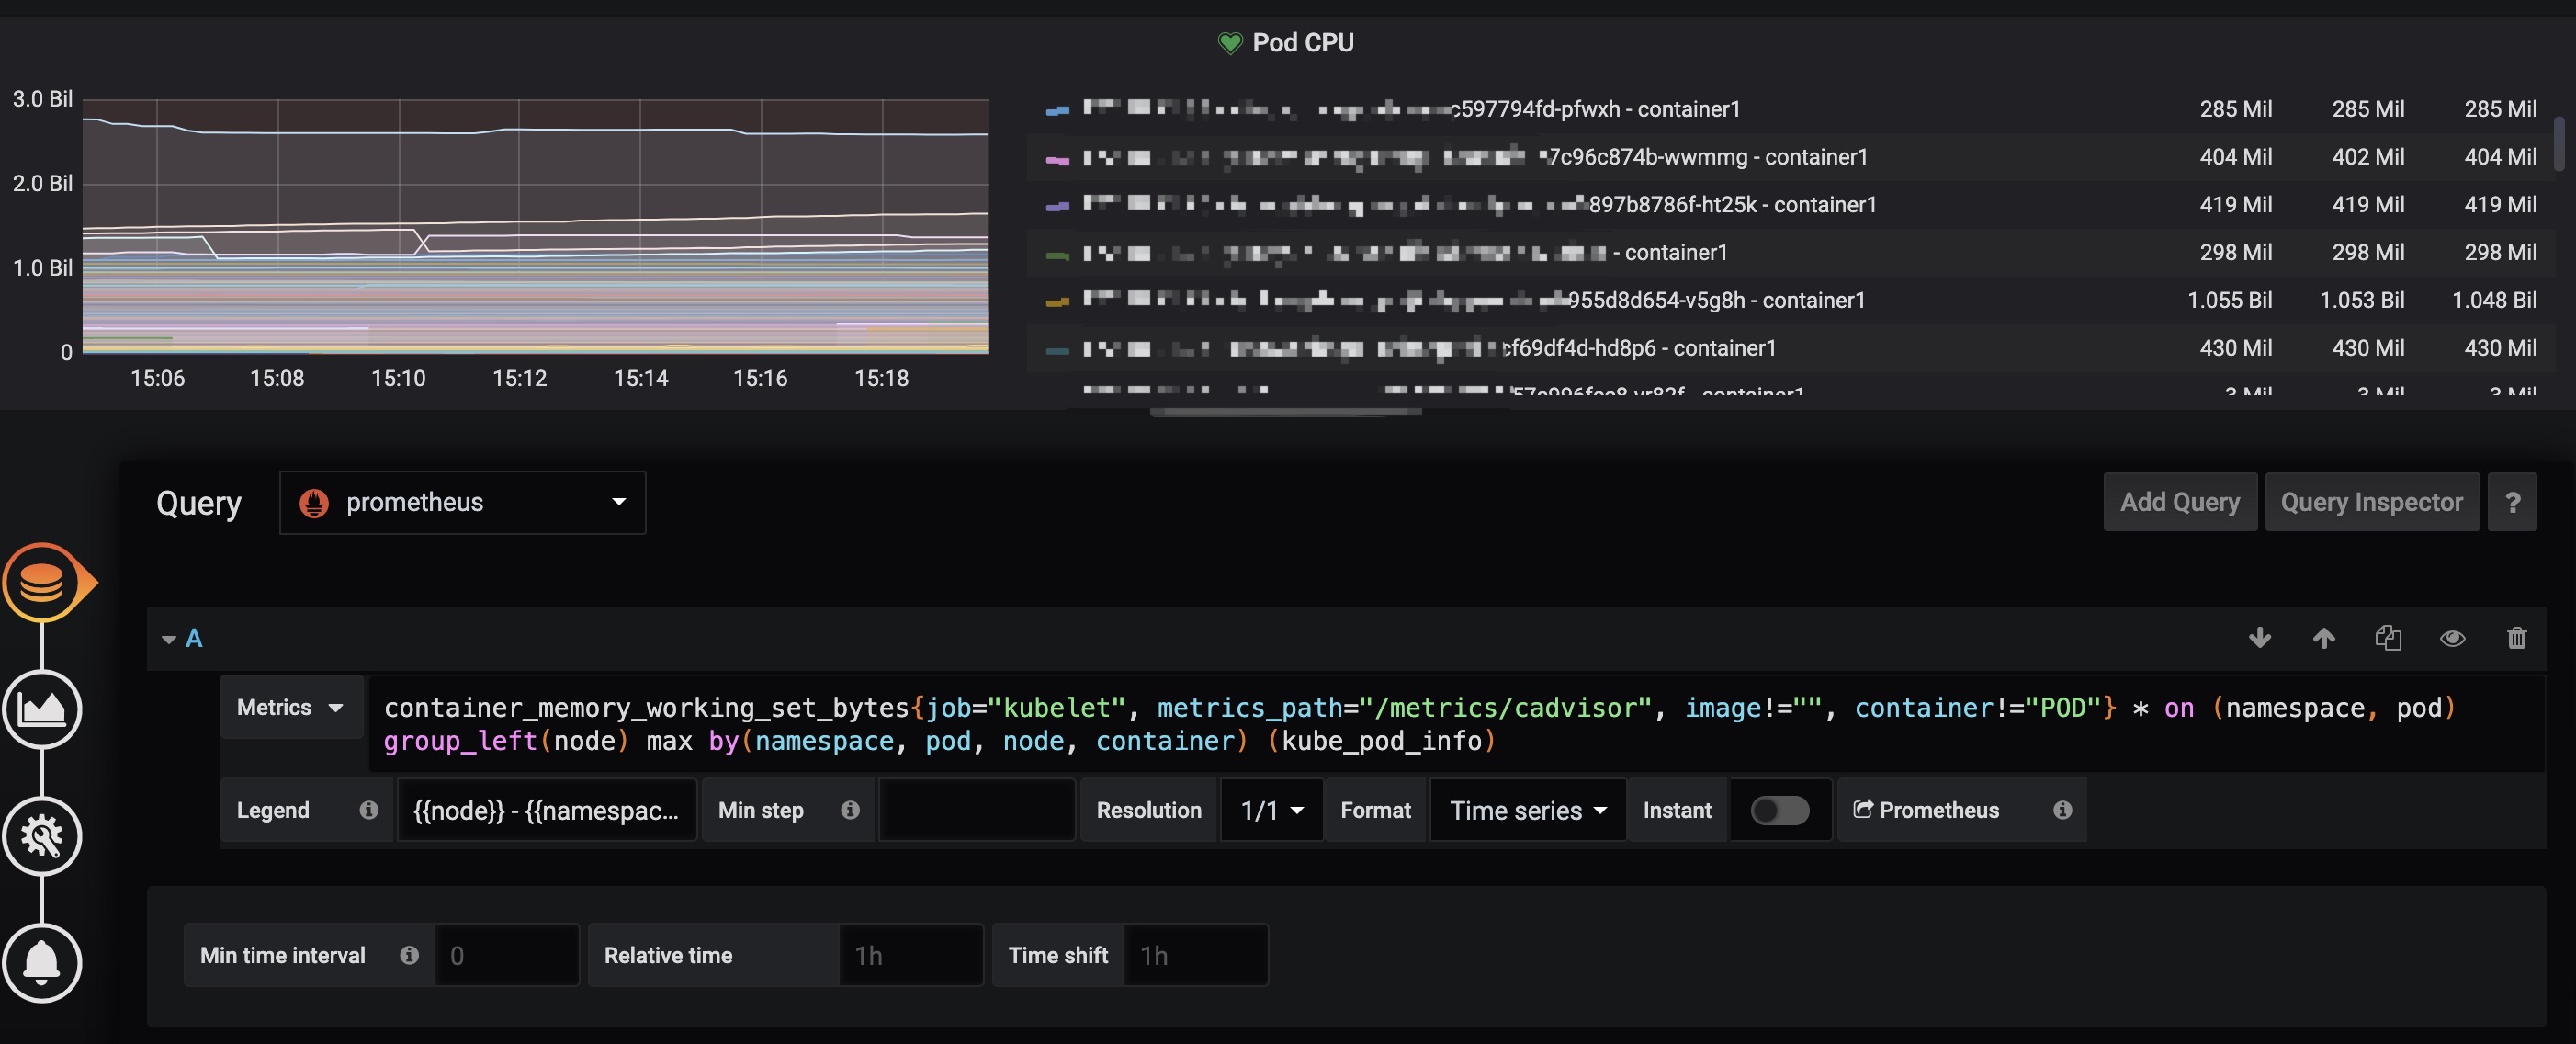
Queries配置
Metrics 中填写
container_memory_working_set_bytes{job="kubelet", metrics_path="/metrics/cadvisor", image!="", container!="POD"} * on (namespace, pod) group_left(node) max by(namespace, pod, node, container) (kube_pod_info)
Legend 中填写
{{node}} - {{namespace}} - {{pod}} - {{container}}
配置完如下:
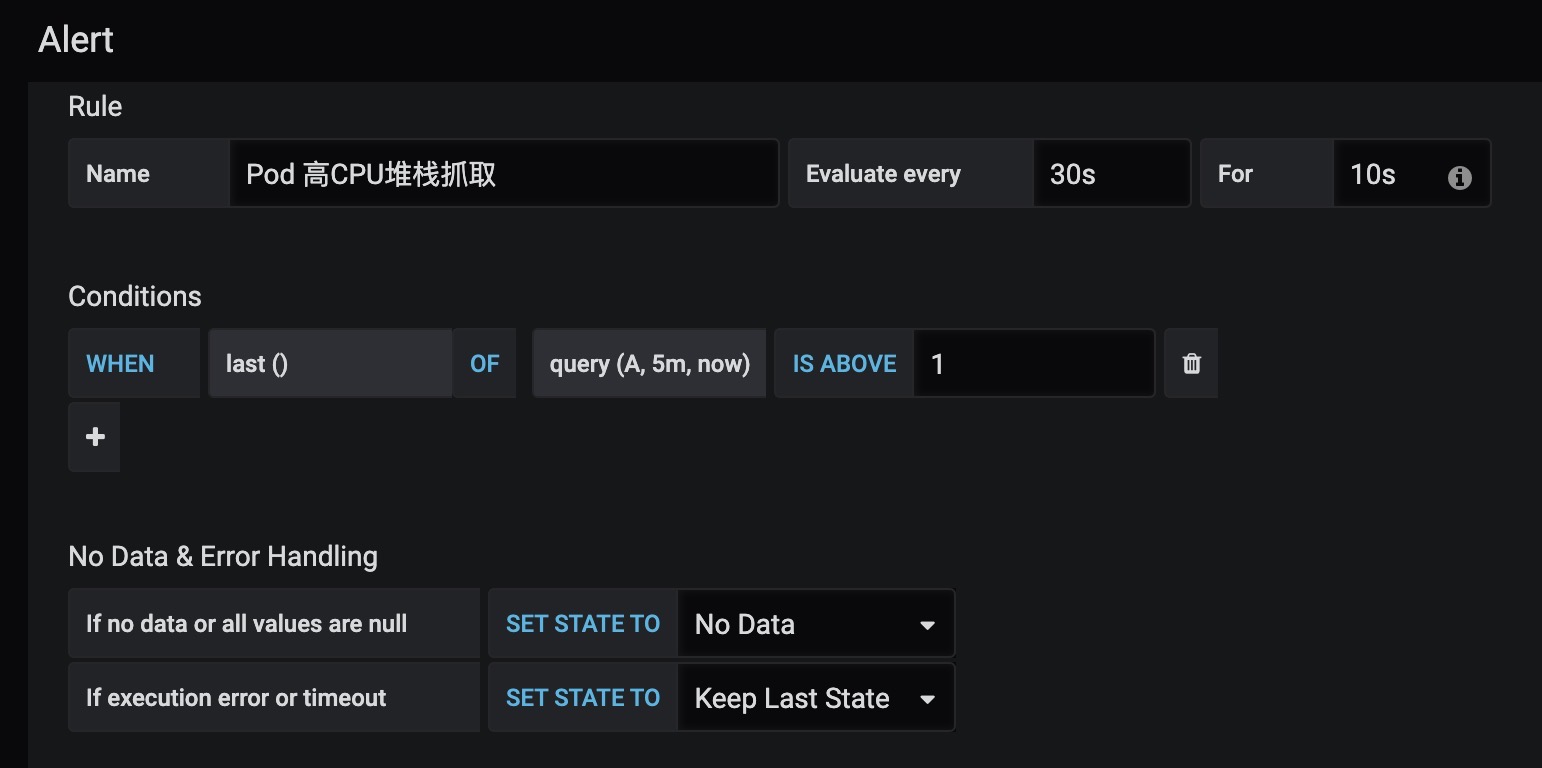
Alert配置
IS ABOVE
CPU使用值,这边配置的是超过1核CPU就报警, 可以根据需要自己调节
Evaluate every
每多久计算一次
For
Pedding时间
配置完应该如下:
构建
二进制
# 为当前系统平台构建

make

# 指定目标系统, GOOS: linux darwin window freebsd

make GOOS=linux
Docker镜像
make docker

# 自定义镜像tag

make docker IMAGE=test
巧用Grafana和Arthas自动抓取K8S中异常Java进程的线程堆栈的更多相关文章
- SQL Server定时自动抓取耗时SQL并归档数据发邮件脚本分享
SQL Server定时自动抓取耗时SQL并归档数据发邮件脚本分享 第一步建库和建表 USE [master] GO CREATE DATABASE [MonitorElapsedHighSQL] G ...
- IIS崩溃时自动抓取Dump
背景:在客户现场,IIS有时会崩溃,开发环境没法重现这个bug,唯有抓取IIS的崩溃是的Dump文件分析. IIS崩溃时自动抓取Dump,需要满足下面几个条件 1.启动 Windows Error R ...
- 自动抓取java堆栈
参数1 进程名字,参数2 最大线程数 例: pid为8888,达到1000个线程时自动抓取堆栈信息 ./autojstack.sh 8888 1000 & #!/bin/bashfileNam ...
- SQL Server定时自动抓取耗时SQL并归档数据脚本分享
原文:SQL Server定时自动抓取耗时SQL并归档数据脚本分享 SQL Server定时自动抓取耗时SQL并归档数据脚本分享 第一步建库 USE [master] GO CREATE DATABA ...
- APP自动化框架LazyAndroid使用手册(2)--元素自动抓取
作者:黄书力 概述 前面的一篇博文简要介绍了安卓自动化测试框架LazyAndroid的组成结构和基本功能,本文将详细描述此框架中元素自动抓取工具lazy-uiautomaterviewer的使用方法. ...
- 学习笔记CB010:递归神经网络、LSTM、自动抓取字幕
递归神经网络可存储记忆神经网络,LSTM是其中一种,在NLP领域应用效果不错. 递归神经网络(RNN),时间递归神经网络(recurrent neural network),结构递归神经网络(recu ...
- 【VIP视频网站项目】VIP视频网站项目v1.0.3版本发布啦(程序一键安装+电影后台自动抓取+代码结构调整)
在线体验地址:http://vip.52tech.tech/ GIthub源码:https://github.com/xiugangzhang/vip.github.io 项目预览 主页面 登录页面 ...
- scrapy自动抓取蛋壳公寓最新房源信息并存入sql数据库
利用scrapy抓取蛋壳公寓上的房源信息,以北京市为例,目标url:https://www.dankegongyu.com/room/bj 思路分析 每次更新最新消息,都是在第一页上显示,因此考虑隔一 ...
- scrapy实现自动抓取51job并分别保存到redis,mongo和mysql数据库中
项目简介 利用scrapy抓取51job上的python招聘信息,关键词为“python”,范围:全国 利用redis的set数据类型保存抓取过的url,现实避免重复抓取: 利用脚本实现每隔一段时间, ...
随机推荐
- 不可被忽视的操作系统( FreeRTOS )【1】
把大多数人每个星期的双休过过成了奢侈的节假日放假,把每天23点后定义为自己的自由时间,应该如何去思考这个问题 ? 双休的两天里,不!是放假的两天里,终于有较长的时间好好的学习一下一直断断续续的Free ...
- java程序:转化金额
在处理财务账款时,需要将转账金额写成大写的.也就是说,如果要转账123456.00元,则需要写成“壹拾贰万叁仟肆佰伍拾陆元整”.所以常常需要通过程序控制自动进行转换.本实例实现了小写金额到大写金额的转 ...
- Activiti网关--并行网关
1.什么是并行网关 并行网关允许将流程分成多条分支,也可以把多条分支汇聚到一起,并行网关的功能是基于进 入和外出顺序流的: fork 分支: 并行后的所有外出顺序流,为每个顺序流都创建一个并发分支. ...
- Java基础部分脑图
这两天事情多,Java摸鱼了,就抽空写了一个脑图聊以自慰,表示自己还是学了的 下面这些全会了,恭喜你,Java的基础你可以毕业了
- CAS单点登录系列之极速入门于实战教程(4.2.7)
@ 目录 一. SSO简介 1.1 单点登录定义 1.2 单点登录角色 1.3 单点登录分类 二. CAS简介 2.1 CAS简单定义 2.2 CAS体系结构 2.3 CAS原理 三.CAS服务端搭建 ...
- Netty 中的 handler 和 ChannelPipeline 分析
上一节我们讲了 Netty 的启动流程,从启动流程入手分析了 Reactor 模型的第一步:channel 如何绑定 Selector.然后讲到了 EventLoop 在启动的时候发挥了什么作用.整个 ...
- 曹工说Redis源码(3)-- redis server 启动过程完整解析(中)
文章导航 Redis源码系列的初衷,是帮助我们更好地理解Redis,更懂Redis,而怎么才能懂,光看是不够的,建议跟着下面的这一篇,把环境搭建起来,后续可以自己阅读源码,或者跟着我这边一起阅读.由于 ...
- go 反射包
一.什么是反射? 反射是用程序检查其所拥有的结构,尤其是类型的一种能力: 二.Printf Printf 的函数声明为: func Printf(format string, args ... int ...
- YII基础
一.目录结构 应用中最重要的目录和文件(假设应用根目录是 basic): basic/ 应用根目录 composer.json Composer 配置文件, 描述包信息 config/ 包含应用配置及 ...
- Java相同id的数据集合,合并数据为一条,并将几个字段内容合并为一个
Java实现,当然也可以数据库实现; /** * Created by shaozhiqi on 2019/7/31. */ public class TestUnion { @Test public ...