
Golang爬虫+正则表达式
最近学习go,爬取网站数据用到正则表达式,做个总结;
Go中正则表达式采用RE2语法(具体是啥咱也不清楚);
字符
. ——匹配任意字符 e.g: abc. 结果: abcd,abcx,abc9;
[] ——匹配括号中任意一个字符 e.g: [abc]d 结果:ad,cd,1d;
- ——[-]中表示范围 e.g: [A-Za-z0-9];
^ ——[^]中表示除括号中的任意字符 e.g:[^xy]a 结果:aa,da,不能为xa,ya;
数量限定
? ——前面单元匹配0或1次;
+ ——前面单元匹配1或多次;
* ——前面单元匹配0或多次;
{,} ——显示个数上下线;e.g : ip地址——[0-9]{1,3}.[0-9]{1,3}.[0-9]{1,3}.[0-9]{1,3};
其他
\ ——转义字符;
| ——条件或;
() ——组成单元 如果字符串本身有括号"[(] aaa. [)]" ;
方法
//参数正则字符串,返回值*Regexp

str := regexp.MustCompile(string)

//参数要查找的数据,查找次数-1为全局,返回值二维数组,查找出的字符串+正则字符串

var result [][]string = str.FindAllStringSubmatch(data, -1)
爬虫
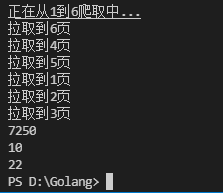
爬取博客园所有文章阅读量,评论,推荐;
package main

import (

	"fmt"

	"io"

	"net/http"

	"regexp"

	"strconv"

)

var readCount int = 0

var commentCount int = 0

var diggCount int = 0

//http读取网页数据写入result返回

func HttpGet(url string) (result string, err error) {

	resp, err1 := http.Get(url)

	if err1 != nil {

		err = err1

		return

	}

	defer resp.Body.Close()

	buf := make([]byte, 4096)

	for {

		n, err2 := resp.Body.Read(buf)

		//fmt.Println(url)

		if n == 0 {

			break

		}

		if err2 != nil && err2 != io.EOF {

			err = err2

			return

		}

		result += string(buf[:n])

	}

	return result, err

}

//横向纵向爬取文章标题数据,并累计数值

func SpiderPageDB(index int, page chan int) {

	url := "https://www.cnblogs.com/littleperilla/default.html?page=" + strconv.Itoa(index)

	result, err := HttpGet(url)

	if err != nil {

		fmt.Println("HttpGet err:", err)

		return

	}

	str := regexp.MustCompile("post-view-count\">阅读[(](?s:(.*?))[)]</span>")

	alls := str.FindAllStringSubmatch(result, -1)

	for _, j := range alls {

		temp, err := strconv.Atoi(j[1])

		if err != nil {

			fmt.Println("string2int err:", err)

		}

		readCount += temp

	}

	str = regexp.MustCompile("post-comment-count\">评论[(](?s:(.*?))[)]</span>")

	alls = str.FindAllStringSubmatch(result, -1)

	for _, j := range alls {

		temp, err := strconv.Atoi(j[1])

		if err != nil {

			fmt.Println("string2int err:", err)

		}

		commentCount += temp

	}

	str = regexp.MustCompile("post-digg-count\">推荐[(](?s:(.*?))[)]</span>")

	alls = str.FindAllStringSubmatch(result, -1)

	for _, j := range alls {

		temp, err := strconv.Atoi(j[1])

		if err != nil {

			fmt.Println("string2int err:", err)

		}

		diggCount += temp

	}

	page <- index

}

//主要工作方法

func working(start, end int) {

	fmt.Printf("正在从%d到%d爬取中...\n", start, end)

	//channel通知主线程是否所有go都结束

	page := make(chan int)

	//多线程go程同时爬取

	for i := start; i <= end; i++ {

		go SpiderPageDB(i, page)

	}

	for i := start; i <= end; i++ {

		fmt.Printf("拉取到%d页\n", <-page)

	}

}

//入口函数

func main() {

	//输入爬取的起始页

	var start, end int

	fmt.Print("startPos:")

	fmt.Scan(&start)

	fmt.Print("endPos:")

	fmt.Scan(&end)

	working(start, end)

	fmt.Println("阅读:", readCount)

	fmt.Println("评论:", commentCount)

	fmt.Println("推荐:", diggCount)

}
Golang爬虫+正则表达式的更多相关文章
- Golang - 爬虫案例实践
目录 Golang - 爬虫案例实践 1. 爬虫步骤 2. 正则表达式 3. 并发爬取美图 Golang - 爬虫案例实践 1. 爬虫步骤 明确目标(确定在哪个网址搜索) 爬(爬下数据) 取(去掉没用 ...
- Golang爬虫示例包系列教程(一):pedaily.com投资界爬虫
Golang爬虫示例包 文件结构 自己用Golang原生包封装了一个爬虫库,源码见go get -u -v github.com/hunterhug/go_tool/spider ---- data ...
- 爬虫——正则表达式re模块
为什么要学习正则表达式 实际上爬虫一共就四个主要步骤: 明确目标:需清楚目标网站 爬:将所有的目标网站的内容全部爬下来 取:在爬下来的网站内容中去掉对我们没有用处的数据,只留取我们需要的数据 处理数据 ...
- Python爬虫 正则表达式
1.正则表达式概述 正则表达式是对字符串操作的一种逻辑公式,就是用事先定义好的一些特定字符.及这些特定字符的组合,组成一个"规则字符串",这个"规则字符串"用来 ...
- Python入门-编写抓取网站图片的爬虫-正则表达式
//生命太短 我用Python! //Python真是让一直用c++的村里孩子长知识了! 这个仅仅是一个测试,成功抓取了某网站1000多张图片. 下一步要做一个大新闻 大工程 #config = ut ...
- Python 爬虫-正则表达式(补)
2017-08-08 18:37:29 一.Python中正则表达式使用原生字符串的几点说明 原生字符串和普通字符串的不同 相较于普通字符串,原生字符串中的\就是反斜杠,并不表达转义.不过,字符串转成 ...
- Python 爬虫-正则表达式
2017-07-27 13:52:08 一.正则表达式的概念 (1)正则表达式是用来简洁表达一组字符串的表达式,最主要应用在字符串匹配中. 正则表达式是用来简洁表达一组字符串的表达式 正则表达式是一 ...
- Python爬虫-正则表达式基础
import re #常规匹配 content = 'Hello 1234567 World_This is a Regex Demo' #result = re.match('^Hello\s\d\ ...
- 之前写的关于chromedp的文章被别人转到CSDN,很受鼓励,再来一篇golang爬虫实例
示例说明:用chromedp操作chrome,导航到baidu,然后输入“美女”,然后再翻2页,在此过程中保存cookie和所有img标签内容,并保存第一页的baidu logo为png 注释已经比较 ...
随机推荐
- MySQL数据库之大厂面试必备技能v8.0.27
概述 **本人博客网站 **IT小神 www.itxiaoshen.com 定义 MySQL官方地址 https://www.mysql.com/ MySQL 8系列最新版本为8.0.27,5系列的最 ...
- DotNetty实现WebSocket的简单使用
工作中项目是物联网项目的,管理平台又是bs架构. 如果用 Socket 的话,Web 端还需要转发,就全部统一采用了 WebSocket . DotNet 平台上的 WebSocket 实现有很多种, ...
- Redis线程模型的前世今生
一.概述 众所周知,Redis是一个高性能的数据存储框架,在高并发的系统设计中,Redis也是一个比较关键的组件,是我们提升系统性能的一大利器.深入去理解Redis高性能的原理显得越发重要,当然Red ...
- Codeforces 464E The Classic Problem(主席树+最短路+哈希,神仙题)
题目链接 题意:给出一张 \(n\) 个点 \(m\) 条边的无向图,第 \(i\) 条边连接 \(u_i,v_i\),边权为 \(2^{w_i}\),求 \(s\) 到 \(t\) 的最短路. \( ...
- Codeforces 1464F - My Beautiful Madness(树的直径)
Codeforces 题面传送门 & 洛谷题面传送门 树上数据结构大杂烩(?) 首先考虑什么样的点能够在所有路径的 \(d\) 邻居的交集内.显然如果一个点在一条路径的 \(d\) 邻居内则必 ...
- Topcoder 12519 ScotlandYard(点对 dp+最长路)
题面传送门 题意: 有两个人 A 和 B 玩一个游戏.游戏规则大致是这样的: 有 \(n\) 个城市和三种交通工具公交.地铁和出租车. 给出三个 \(n\times n\) 的字符矩阵 \(b,m,t ...
- 洛谷 P4646 - [IOI2007] flood 洪水(拆点+bfs)
题面传送门 一道挺有意思的题(?) orz djq yyds %%%%%%%%%%%%%%%%%% 首先一个很直观的想法是将每个房间看作一个节点,在有墙的房间旁边连边权为 \(1\) 的边然后 bfs ...
- Anaconda建立新的环境,出现CondaHTTPError: HTTP 000 CONNECTION FAILED for url ...... 解决过程
2020.3.7准备scrapy,使用anaconda创建一个新的环境,执行"conda create -n scrapyEnv python=3.6",结果出现了"Co ...
- 【机器学习与R语言】1-机器学习简介
目录 1.基本概念 2.选择机器学习算法 3.使用R进行机器学习 1.基本概念 机器学习:发明算法将数据转化为智能行为 数据挖掘 VS 机器学习:前者侧重寻找有价值的信息,后者侧重执行已知的任务.后者 ...
- composer设置阿里云镜像源
composer设置阿里云镜像源 1. 首先把默认的源给禁用掉 composer config -g secure-http false 2. 再修改镜像源 这里我使用阿里的源 composer co ...