
Kafka实战:如何把Kafka消息时延秒降10倍
背景
国内某大型税务系统,业务应用分布式上云改造。
业务难题
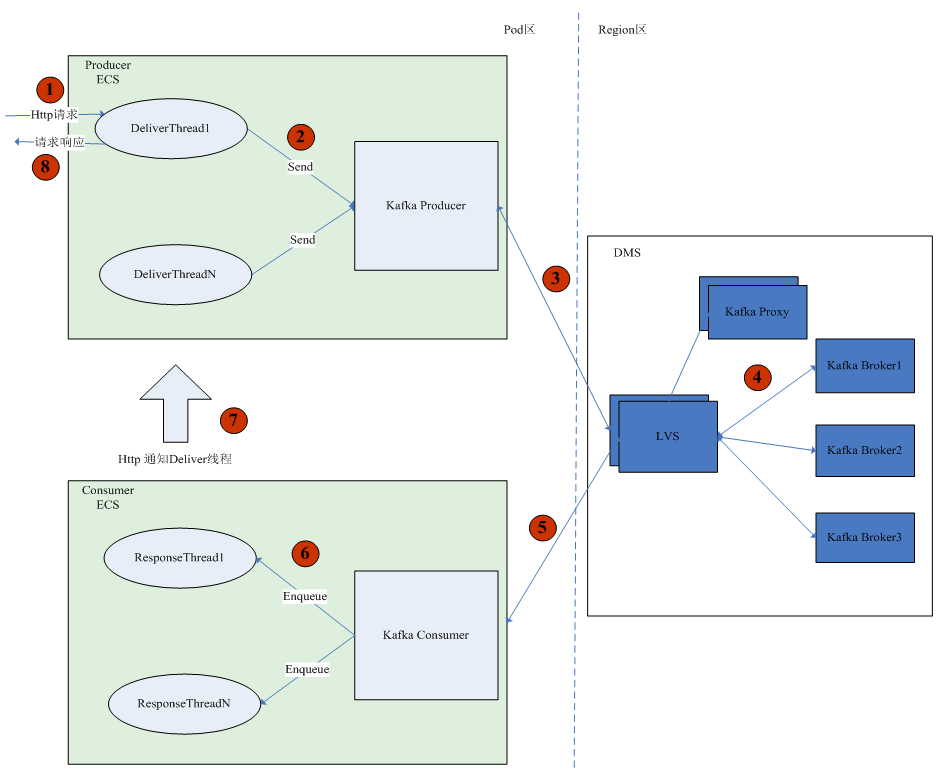
如上图所示是模拟客户的业务网页构建的一个并发访问模型。用户在页面点击从而产生一个HTTP请求,这个请求发送到业务生产进程,就会启动一个投递线程(Deliver Thread)调用Kafka的SDK接口,并发送3条消息到DMS(分布式消息服务),每条消息大小3k,需要等待3条消息都被处理完成后才会返回请求响应⑧。当消息达到DMS后,业务消费进程调用Kafka的消费接口把消息取出来,然后将每条消息放到一个响应线程(Response Thread)中进行处理,响应线程处理完后,通过HTTP请求通知投递线程,投递线程收到响应后返回回复响应。
100并发访问时延500ms,未达成用户业务要求
客户提出了明确的要求:每1个两核的ECS要能够支撑并发访问量100,每条消息端到端的时延范围是几十毫秒,即从生产者发送开始到接收到消费者响应的时间。客户实测在使用了DMS的Kafka 队列后,并发访问量为100时时延高达到500ms左右,甚至出现达到秒级的时延,远未达到客户提出的业务诉求。相比较而言,客户在Pod区使用的是自己搭建的原生Kafka,在并发访问量为100时测试到的时延大约只有10~20ms左右。那么问题来了,在并发访问量相同的条件下,DMS的Kafka 队列与Pod区自建的原生Kafka相比为什么时延会有这么大的差异呢?我们DMS的架构师 Mr. Peng对这个时延难题进行了一系列分析后完美解决了这个客户难题,下面就让我们来看看他的心路历程。
难题剖析
根据模拟的客户业务模型,Mr. Peng在华为云类生产环境上也构造了一个测试程序,同样模拟构造了100的并发访问量,通过测试发现,类生产环境上压测得到的时延平均时间在60ms左右。类生产上的时延数值跟客户在真实生产环境上测到的时延差距这么大,这是怎么回事呢?问题变得扑朔迷离起来。
Mr. Peng当机立断,决定就在华为云现网上运行构造的测试程序,来看看到底是什么原因。同时,在客户的ECS服务器上,也部署了相同的测试程序,模拟构建了100的并发量,得到如下的时延结果对比表:
|
调优前时延 |
现网时延(ms) |
类生产时延(ms) |
|
100并发 |
500ms ~ 4000ms |
40ms ~ 80 ms |
|
1并发 |
31ms |
6ms |
|
Ping测试 |
0.9ms ~ 1.2ms |
0.3ms ~ 0.4ms |
表1 华为云现网与类生产环境时延对比表
从时延对比表的结果看来,Mr. Peng发现,即使在相同的并发压力下,华为云现网的时延比类生产差很多。Mr. Peng意识到,现在有2个问题需要分析:为什么华为云现网的时延会比类生产差?DMS的Kafka队列时延比原生自建的Kafka队列时延表现差的问题怎么解决?Mr. Peng进行了如下分析:
时延分析
回归问题的本质,DMS Kafka队列的时延到底是怎么产生的?可控的端到端时延具体分为哪些?Mr. Peng给出了如下的计算公式:
总时延 = 入队时延 + 发送时延 + 写入时延 + 复制时延 + 拉取时延
让我们来依次了解一下,公式中的每一项都是指什么。
入队时延: 消息进入Kafka sdk后,先进入到要发送分区的队列,完成消息打包后再发送,这一过程所用的时间。
发送时延:消息从生产者发送到服务端的时间。
写入时延:消息写入到Kafka Leader的时间。
复制时延:消费者只可以消费到高水位以下的消息(即被多个副本都保存的消息),所以消息从写入到Kafka Leader,到所有副本都写入该消息直到上涨至高水位这段时间就是消息复制的时延。
拉取时延:消费者采用pull模式拉取数据,拉取过程所用的时间。
(1) 入队时延
现网是哪一部分的时延最大呢?通过我们的程序可以看到,入队列等待发送时延非常大,如下图:
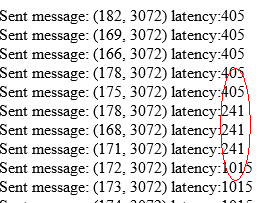
即消息都等待在生产端的队列中,来不及发送!
我们再看其他时延分析,因为无法在现网测试,我们分别在类生产测试了相同压力的,测试其他各种时延如下:
(2) 复制时延
以下是类生产环境测试的1并发下的
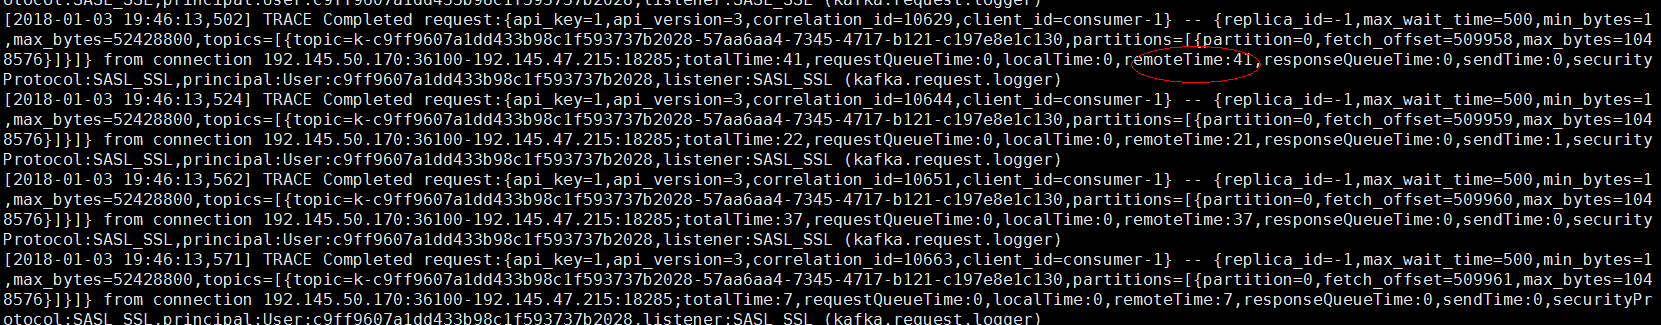
从日志上看,复制时延包括在remoteTime里面,当然这个时间也会包括生产者写入时延比较慢导致的,但是也从一定的程度反映复制时延也是提升性能时延的一个因素。
(3) 写入时延
因为用户使用的是高吞吐队列,写入都是异步落盘,我们从日志看到写入时延非常低(localTime),可以判断不是瓶颈
发送时延与拉取时延都是跟网络传输有关系,这个优化主要是通过调TCP的参数来决定的。轻轻松松把Kafka消息时延秒降10倍,就用华为云DMS
Kafka实战:如何把Kafka消息时延秒降10倍的更多相关文章
- Kafka实战宝典:Kafka的控制器controller详解
一.控制器简介 控制器组件(Controller),是 Apache Kafka 的核心组件.它的主要作用是在 Apache ZooKeeper 的帮助下管理和协调整个 Kafka 集群.集群中任意一 ...
- Flink-Kafka-Connector Flink结合Kafka实战
戳更多文章: 1-Flink入门 2-本地环境搭建&构建第一个Flink应用 3-DataSet API 4-DataSteam API 5-集群部署 6-分布式缓存 7-重启策略 8-Fli ...
- DataPipeline |《Apache Kafka实战》作者胡夕:Apache Kafka监控与调优
胡夕 <Apache Kafka实战>作者,北航计算机硕士毕业,现任某互金公司计算平台总监,曾就职于IBM.搜狗.微博等公司.国内活跃的Kafka代码贡献者. 前言 虽然目前Apache ...
- Kafka实战分析(一)- 设计、部署规划及其调优
1. Kafka概要设计 kafka在设计之初就需要考虑以下4个方面的问题: 吞吐量/延时 消息持久化 负载均衡和故障转移 伸缩性 1.1 吞吐量/延时 对于任何一个消息引擎而言,吞吐量都是至关重要的 ...
- 《Apache kafka实战》读书笔记-kafka集群监控工具
<Apache kafka实战>读书笔记-kafka集群监控工具 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 如官网所述,Kafka使用基于yammer metric ...
- 《Apache Kafka实战》读书笔记-调优Kafka集群
<Apache Kafka实战>读书笔记-调优Kafka集群 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.确定调优目标 1>.常见的非功能性要求 一.性能( ...
- 《Apache Kafka 实战》读书笔记-认识Apache Kafka
<Apache Kafka 实战>读书笔记-认识Apache Kafka 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.kafka概要设计 kafka在设计初衷就是 ...
- Kafka实战-实时日志统计流程
1.概述 在<Kafka实战-简单示例>一文中给大家介绍来Kafka的简单示例,演示了如何编写Kafka的代码去生产数据和消费数据,今天给大家介绍如何去整合一个完整的项目,本篇博客我打算为 ...
- Kafka实战(七) - 优雅地部署 Kafka 集群
既然是集群,必然有多个Kafka节点,只有单节点构成的Kafka伪集群只能用于日常测试,不可能满足线上生产需求. 真正的线上环境需要考量各种因素,结合自身的业务需求而制定.看一些考虑因素(以下顺序,可 ...
随机推荐
- 接口与抽象类的区别-Java
概念-抽象类: 类是对某一个对象的具体描述,抽象类则是对有共通之处的对象,描述共通之处的类;包含抽象方法的类一定的抽象类,抽象类并不一定包含抽象方法;抽象类中可以有数据成员,但数据成员必须是stati ...
- 【笔记JS/HTML/CSS】ubuntu环境下的sublime text2 安装 zenCoding
刚接触web编程的时候就被老师安利了sublime text2 这个文本编辑器,后来发现它真的挺好用的,无论是windows还是ubuntu,都可以很简单地下载安装(到官网,免费哦),三分钟内就搞定了 ...
- treetable adding nodes at root level
describe("loadBranch()", function() { beforeEach(function() { this.newRows = " ...
- xmpp消息回执(6)
原始地址:XMPPFrameWork IOS 开发(七)消息回执 请参考:XEP-0184协议 协议内容: 发送消息时附加回执请求 <message from='northumberland@s ...
- 暴力搜索+散列--P1008 三连击
题目描述 将1,2, ⋯,9共9个数分成3组,分别组成3个三位数,且使这3个三位数构成1:2:3的比例,试求出所有满足条件的3个三位数. 输入输出格式 输入格式: 木有输入 输出格式: 若干行,每行3 ...
- Linux下挂载新磁盘
Linux的硬盘识别: 一般使用”fdisk -l”命令可以列出系统中当前连接的硬盘 设备和分区信息.新硬盘没有分区信息,则只显示硬盘大小信息. 1.关闭服务器加上新硬盘 2.启动服务器,以r ...
- Hadoop Mapreduce 中的Partitioner
Partitioner的作用的对Mapper产生的中间结果进行分片,以便将同一分组的数据交给同一个Reduce处理,Partitioner直接影响Reduce阶段的负载均衡. MapReduce提供了 ...
- Django DTL模板语法中的循环
from django.shortcuts import render def index(request): context={ 'books':[ '5年高考3年模拟', '家猪养殖与配种', ' ...
- 在线安全清空慢查询日志slowlog
mysql> show variables like '%slow_query%';+------------------------------------+--------------- ...
- INT32 System_UserKeyFilter(NVTEVT evt, UINT32 paramNum, UINT32 *paramArray)
INT32 System_UserKeyFilter(NVTEVT evt, UINT32 paramNum, UINT32 *paramArray){ UINT32 key = evt; if ...