
如何用Python 制作词云-对1000首古诗做词云分析
公号:码农充电站pro
主页:https://codeshellme.github.io
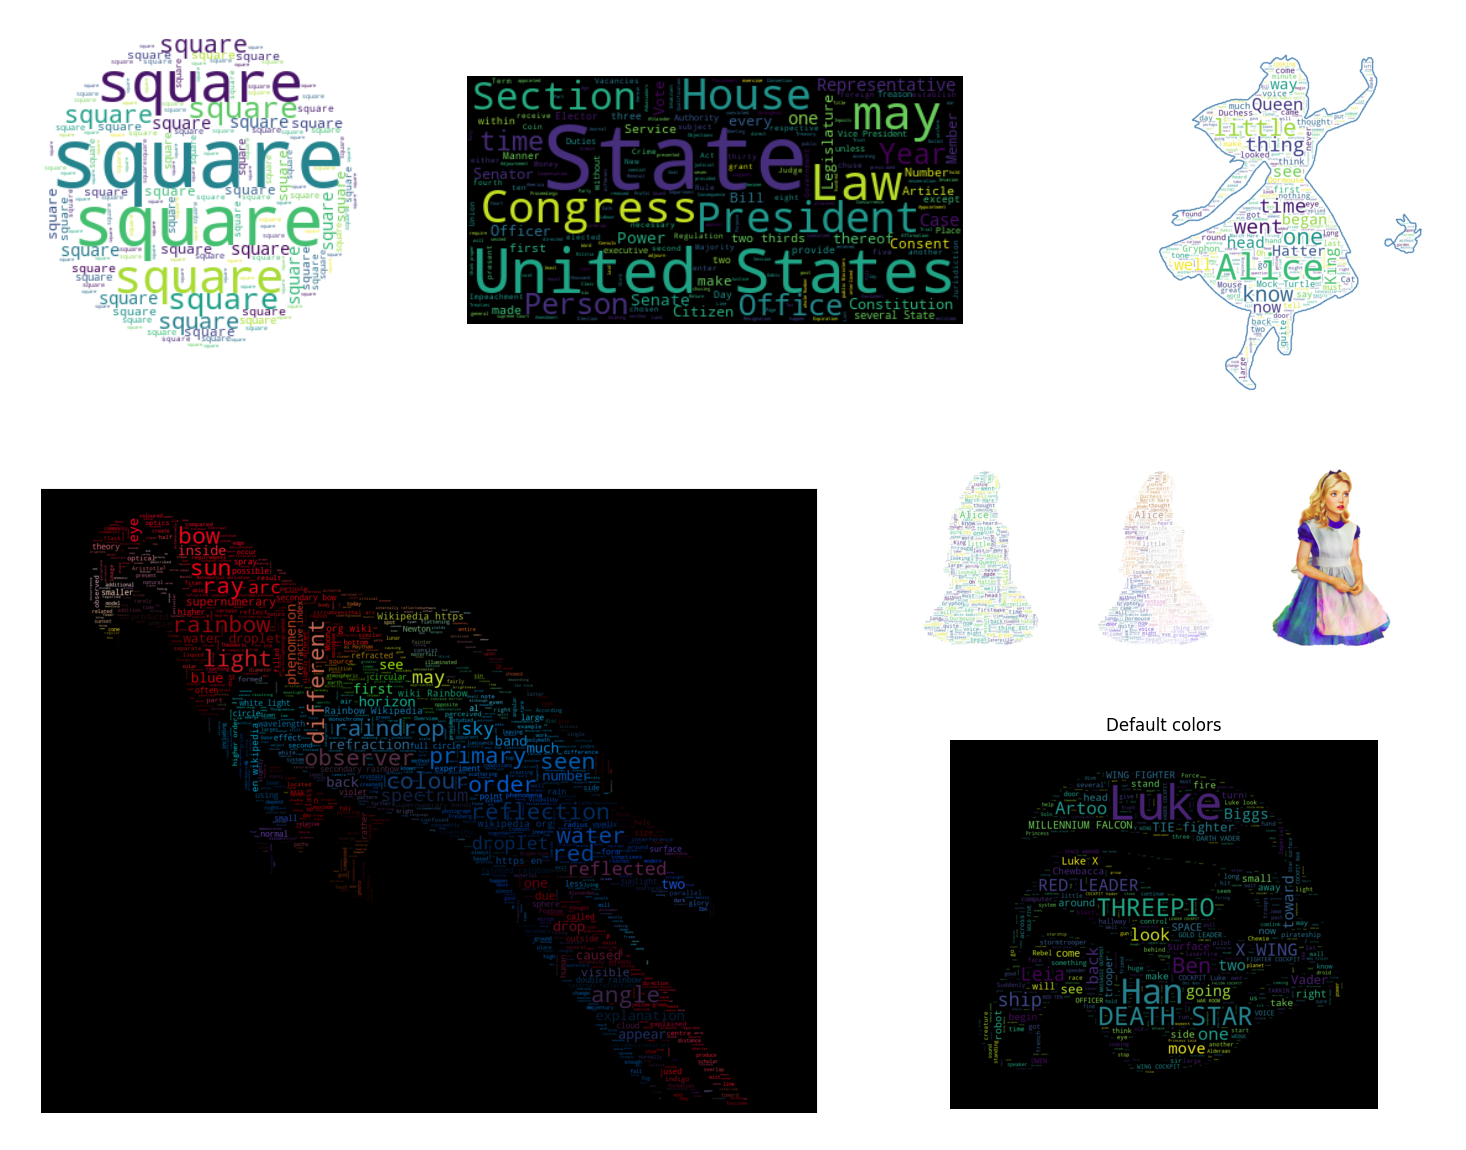
今天来介绍一下如何使用 Python 制作词云。
词云又叫文字云,它可以统计文本中频率较高的词,并将这些词可视化,让我们可以直观的了解文本中的重点词汇。
词的频率越高,词显示的大小也就越大。
1,wordcloud 模块
wordcloud 是一个词云生成器,它不仅是一个 Python 库,还是一个命令行工具。我们可以通过 wordcloud 官方文档,和示例库来学习如何使用它。
在使用 wordcloud 之前,需要先安装它:
pip install wordcloud
2,WordCloud 类
WordCloud 类用于创建词云对象,先来看下它的原型:
WordCloud(font_path=None,

  width=400, height=200,

  margin=2, ranks_only=None,

  prefer_horizontal=0.9,

  mask=None, scale=1,

  color_func=None, max_words=200,

  min_font_size=4, stopwords=None,

  random_state=None,

  background_color='black',

  max_font_size=None,

  font_step=1, mode='RGB',

  relative_scaling='auto',

  regexp=None, collocations=True,

  colormap=None, normalize_plurals=True,

  contour_width=0, contour_color='black',

  repeat=False, include_numbers=False,

  min_word_length=0,

  collocation_threshold=30)
可以看到,WordCloud 类有很多参数可以设置,这里介绍一些常用的参数:
- font_path:设置字体文件路径,字体文件以
.ttf为后缀。- 如果分析的文本是中文,则需要设置中文字体,否则会乱码。
- background_color:设置图片背景颜色,默认为 black,也可以设置为 white 等。
- mask:设置背景图片。
- max_words:设置最大的词数,默认为200。
- stopwords:设置停用词。
- max_font_size:设置字体最大值。
- width:设置画布的宽度,默认为400。
- height:设置画布的高度,默认为200。
- random_state:设置多少种随机状态,即多少种颜色。
在创建好词云对象后,可以使用 generate 方法生成词云,并使用 to_file 方法将词云图像保存在文件中。
generate 方法的原型如下:
generate(text)
参数text 是一个用空格隔开的文本字符串。如果分析的是中文,需要先用 jieba 进行分词,可以参考这里。
除了将词云图像保存在文件中,还可以使用 Matplotlib 模块显示词云图像,示例代码如下:
import matplotlib.pyplot as plt

plt.imshow(wordcloud)  # wordcloud 是词云对象

plt.axis("off")        # 用于关闭坐标轴

plt.show()
3,一个简单的示例
下面演示一个最简单的示例,来看如何使用 wordcloud。
首先创建词云对象:
from wordcloud import WordCloud

wc = WordCloud()
生成词云:
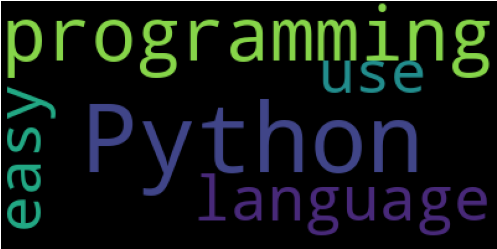
text = "Python is a programming language, it is easy to use."

wc.generate(text)
词云对象的 words_ 属性中存储了每个单词的(归一化后的)权重,权重的范围是 (0, 1]。
words_ 属性是一个字典类型,它存储的键的最大个数为 max_words,即 WordCloud 类的参数。
如下:
>>> wc.words_

{'Python': 1.0, 'programming': 1.0, 'language': 1.0, 'easy': 1.0, 'use': 1.0}

# 示例中的这些单词出现的频率都相等(均为 1),

# 所以它们的权重都是 1。
用 Matplotlib 展示词云图像:
import matplotlib.pyplot as plt

plt.imshow(wc)

plt.axis("off")

plt.show()
词云图像如下:
4,对古诗做词云分析
我在这里准备了一个案例,是对1000 首古诗做词云分析。
代码目录如下:
wordcloud/

├── SimHei.ttf

├── gushi.txt

└── gushi_wordcloud.py
其中:
我将代码也放在这里,方便查看:
#!/usr/bin/env python

# coding=utf-8

import os

import sys

import jieba

from wordcloud import WordCloud

if sys.version.startswith('2.'):

    reload(sys)

    sys.setdefaultencoding('utf-8')

# 去掉一些作者的名字

STOPWORDS = [

        u'李白', u'杜甫', u'辛弃疾', u'李清照', u'苏轼',

        u'李商隐', u'王维', u'白居易', u'李煜', u'杜牧',

        ]

def load_file(file_path):

    if sys.version.startswith('2.'):

        with open(file_path) as f:

            lines = f.readlines()

    else:

        with open(file_path, encoding='utf-8') as f:

            lines = f.readlines()

    content = ''

    for line in lines:

        line = line.encode('unicode-escape').decode('unicode-escape')

        line = line.strip().rstrip('\n')

        content += line

    words = jieba.cut(content)

    l = []

    for w in words:

        # 如果词的长度小于 2,则舍去

        if len(w) < 2: continue

        l.append(w)

    return ' '.join(l)

if __name__ == '__main__':

    file_path = './gushi.txt'

    content = load_file(file_path)

    wc = WordCloud(

            font_path="./SimHei.ttf",

            stopwords=STOPWORDS,

            width=2000, height=1200)

    wc.generate(content)

    wc.to_file("wordcloud.jpg")
其中:
STOPWORDS停用词列表,是一些作者的名字。load_file方法用于加载文本,其中用到了 jieba 分词。
最后将词云图像保存在了 wordcloud.jpg 文件中,如下:
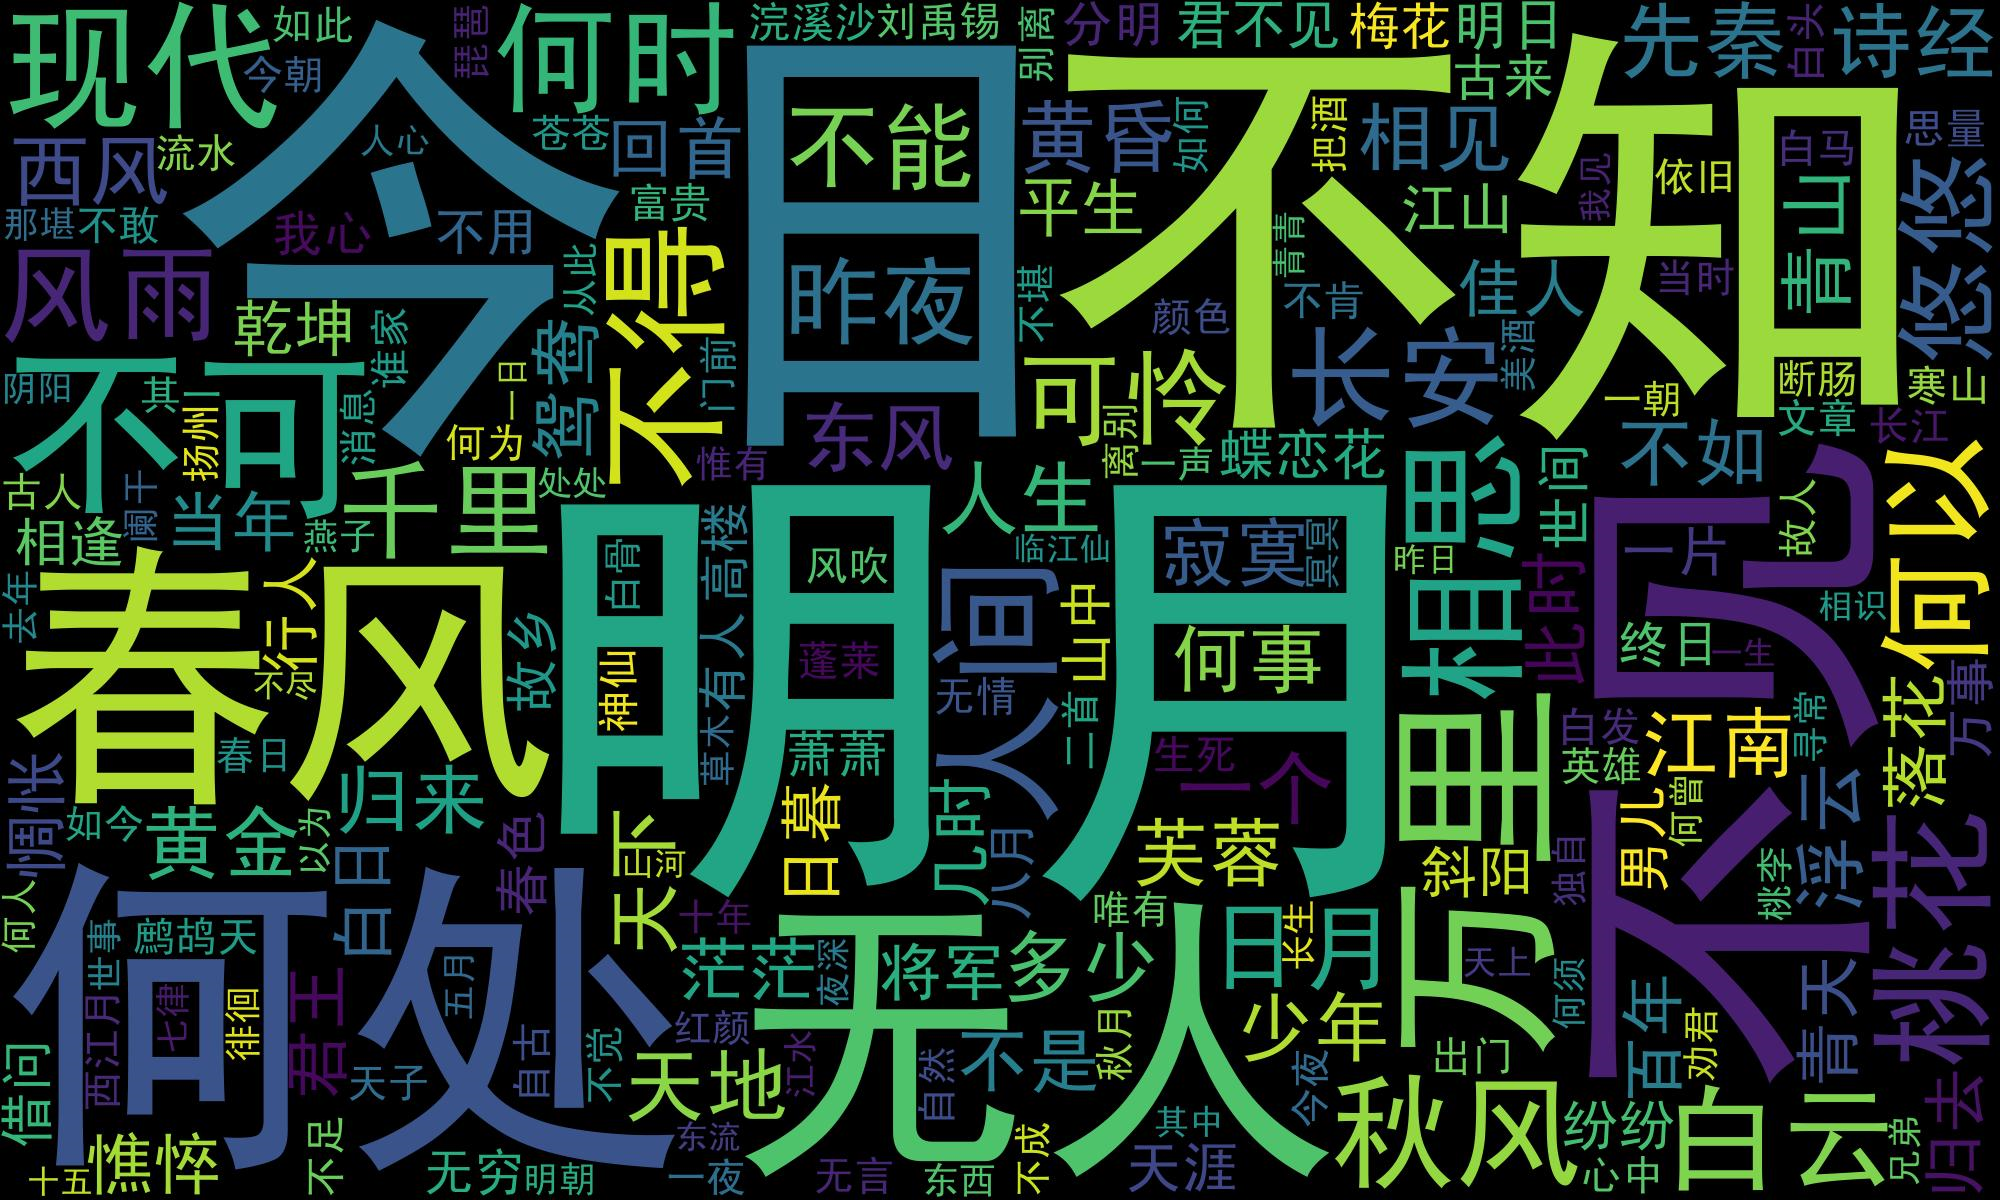
我们也可以从词云对象的words_ 属性中查看每个词的权重,这里我列出前十个:
('明月', 1.0)

('今日', 0.9130434782608695)

('不知', 0.8405797101449275)

('何处', 0.8260869565217391)

('不见', 0.8115942028985508)

('春风', 0.7536231884057971)

('无人', 0.7536231884057971)

('不可', 0.7536231884057971)

('万里', 0.7536231884057971)

('现代', 0.6666666666666666)
(本节完。)
推荐阅读:
欢迎关注作者公众号,获取更多技术干货。
如何用Python 制作词云-对1000首古诗做词云分析的更多相关文章
- 如何用Python做词云(收藏)
看过之后你有什么感觉?想不想自己做一张出来? 如果你的答案是肯定的,我们就不要拖延了,今天就来一步步从零开始做个词云分析图.当然,做为基础的词云图,肯定比不上刚才那两张信息图酷炫.不过不要紧,好的开始 ...
- 一步一步教你如何用Python做词云
前言 在大数据时代,你竟然会在网上看到的词云,例如这样的. 看到之后你是什么感觉?想不想自己做一个? 如果你的答案是正确的,那就不要拖延了,现在我们就开始,做一个词云分析图,Python是一个当下很流 ...
- python 生成18年写过的博客词云
文章链接:https://mp.weixin.qq.com/s/NmJjTEADV6zKdT--2DXq9Q 回看18年,最有成就的就是有了自己的 博客网站,坚持记录,写文章,累计写了36篇了,从一开 ...
- Python给小说做词云
闲暇时间喜欢看小说,就想着给小说做词云,展示小说的主要内容.开发语言是Python,主要用到的库有wordcloud.jieba.scipy.代码很简单,首先用jieba.cut()函数做分词,生成以 ...
- python3做词云分析
python3做词云 其实词云一般分为两种,一个是权重比,一个是频次分析 主要还是体现在自然语言方向,难度较大,但这里我们用jieba词库 主要思路, 后端算数据+前端生成图(D3-cloud-好像是 ...
- 纯前端实现词云展示+附微博热搜词云Demo代码
前言 最近工作中做了几个数据可视化大屏项目,其中也有用到了词云展示,以前做词云都是用python库来生成图片显示的,这次用了纯前端的实现(Ctrl+V真好用),同时顺手做个微博热搜的词云然后记录一下~ ...
- 做词云时报错cannot import name ‘WordCloud‘ from partially initialized module ‘wordcloud‘的解决办法
问题: 在做词云时,运行时出现该问题,wordcloud安装成功,但运行出错,错误提示是:cannot import name 'WordCloud' from partially initializ ...
- 词云wordcloud类介绍&python制作词云图&词云图乱码问题等小坑
词云图,大家一定见过,大数据时代大家经常见,我们今天就来用python的第三方库wordcloud,来制作一个大数据词云图,同时会降到这个过程中遇到的各种坑, 举个例子,下面是我从自己的微信上抓的微信 ...
- python制作词云
需要模块wordcloud,pip install wordcloud安装即可.代码: , #边距background_color='black',#指定背景颜色font_path='simhei.t ...
随机推荐
- Nacos一致性算法
1. CAP原则 又称CAP定理,指的是在一个分布式系统中,一致性(Consistency).可用性(Availability).分区容错性(Partition tolerance).CAP 原则指的 ...
- 一个工作三年左右的Java程序员和大家谈谈从业心得
转发链接地址:https://mp.weixin.qq.com/s/SSh9HcA5PgMHv7xiolQkig 貌似这一点适应的行业最广,但是我可以很肯定的说:当你从事web开发一年后,重新找工作时 ...
- Redis的一些攻击手法整理
Redis基础 1 Redis基础 REmote DIctionary Server(Redis) 是一个由Salvatore Sanfilippo写的key-value存储系统. Redis是一个开 ...
- 死磕以太坊源码分析之p2p节点发现
死磕以太坊源码分析之p2p节点发现 在阅读节点发现源码之前必须要理解kadmilia算法,可以参考:KAD算法详解. 节点发现概述 节点发现,使本地节点得知其他节点的信息,进而加入到p2p网络中. 以 ...
- 巧妙运用Camtasia制作爱豆的动感影集
对于追星族来说,收集爱豆的图片.视频是日常必做的事情,而对于进阶型的追星族来说,为爱豆自制各种精美的视频.影集等,会让自己追星之路显得更为充实. 我们可以借助Camtasia教程录制软件为爱豆制作各种 ...
- 什么是NTFS文件格式
说到磁盘格式,想必大家对于NTFS格式并不陌生.我们使用的u盘等硬盘设备很多都应用了此格式.NTFS文件格式究竟是什么?它都有哪些特点?今天,小编将利用这篇文章为大家进行介绍. 一.什么是NTFS文件 ...
- 如何使用系统清理缓存软件优化MacBook
在我们使用我们的Mac一定的时间后,总是不可避免的出现Mac内存不足的情况,所以清理垃圾软件也就成为了我们电脑里必不可少的软件.苹果软件商店中有很多各有不同的清理垃圾软件,但我们往往很难从这一大堆软件 ...
- 前端(web)知识-html
前端由三部分组成: HTML(标签)--CSS(美化,修饰)--JS(执行指令) HTML(超文本标记语言,Hypertext Markup Language):是一种用于创建网页的标记语言. 本质上 ...
- 【mq读书笔记】mq读写分离机制
mq根据brokerName查找Broker地址的过程 mq根据MessageQueue查找Broker地址的唯一依据是brokerName,同一组Broker(M-S)他们的bokerName相同但 ...
- 写给程序员的机器学习入门 (十) - 对象识别 Faster-RCNN - 识别人脸位置与是否戴口罩
每次看到大数据人脸识别抓逃犯的新闻我都会感叹技术发展的太快了,国家治安水平也越来越好了