
044 HIVE中的几种排序
1、order by:全局排序
select * from emp order by sal;
对于一个reduce才有用。
2、sort by:对于每个reduce进行排序
set mapreduce.job.reduces=3;
这里设置了reduce为3。
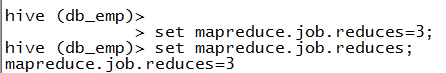
原本的结果放在控制台上,看的效果不是太清楚,所以将hive的结果到出到本文件。
insert overwrite local directory '/opt/datas/emp_sort' row format delimited fields terminated by '\t' select * from emp sort by sal;

结果:

3、distribute by :底层就是mapreduce 的分区,一般与sort by连用
先按照deptno进行分区,然后sort by每个reduce。
insert overwrite local directory '/opt/datas/emp_dis' row format delimited fields terminated by '\t' select * from emp distribute by deptno sort by sal;

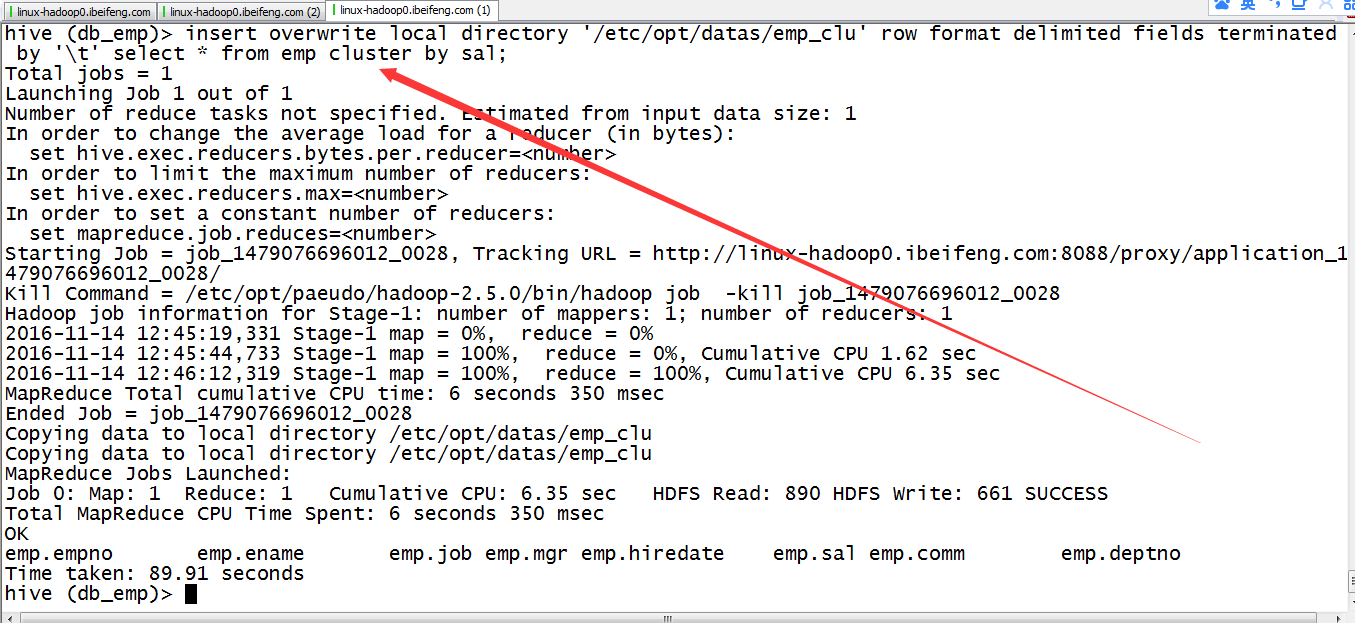
4、cluster by:等价于distribute by 与sort by的字段相同时
分区与排序都是一个字段,可以使用这个。
应该说,这个是上面的一种特殊情况,我感觉可能会用的少一些。
insert overwrite local directory '/opt/datas/emp_cls' row format delimited fields terminated by '\t' select * from emp cluster by sal;
044 HIVE中的几种排序的更多相关文章
- Hive 中的四种排序详解,再也不会混淆用法了
Hive 中的四种排序 排序操作是一个比较常见的操作,尤其是在数据分析的时候,我们往往需要对数据进行排序,hive 中和排序相关的有四个关键字,今天我们就看一下,它们都是什么作用. 数据准备 下面我们 ...
- HIVE中的几种排序
1.order by:全局排序 select * from emp order by sal; 2.sort by:对于每个reduce进行排序 set mapreduce.job.reduces=3 ...
- 061 hive中的三种join与数据倾斜
一:hive中的三种join 1.map join 应用场景:小表join大表 一:设置mapjoin的方式: )如果有一张表是小表,小表将自动执行map join. 默认是true. <pro ...
- Hive中的三种不同的数据导出方式介绍
问题导读:1.导出本地文件系统和hdfs文件系统区别是什么?2.带有local命令是指导出本地还是hdfs文件系统?3.hive中,使用的insert与传统数据库insert的区别是什么?4.导出数据 ...
- hive中的一种假NULL现象
使用hive时,我们偶尔会遇到这样的问题,当你将结果输出到屏幕时,查出的数据往往显示为null,但是当你将结果输出到文本时,却显示为空(即未填充),这是为什么呢? 在hive中有一种假NULL,它看起 ...
- java数组中的三种排序方法中的冒泡排序方法
我记得我大学学java的时候,怎么就是搞不明白这三种排序方法,也一直不会,现在我有发过来学习下这三种方法并记录下来. 首先说说冒泡排序方法:冒泡排序方法就是把数组中的每一个元素进行比较,如果第i个元素 ...
- Hive中的一种假NULL
Hive中有种假NULL,它看起来和NULL一摸一样,但是实际却不是NULL. 例如如下这个查询: hive> desc ljn004; OK a string Time taken ...
- Hive中的4种Join方式
common join 普通join,性能较差,存在Shuffle map join 适用情况:大表join小表时,做不等值join 原理:将小表数据广播到各个节点,存储在内存中,在map阶段直接jo ...
- C语言中的七种排序算法
堆排序: void HeapAdjust(int *arraydata,int rootnode,int len) { int j; int t; *rootnode+<len) { j=*ro ...
随机推荐
- tensorflow实现mnist
import tensorflow as tf from tensorflow.examples.tutorials.mnist import input_data # 在变量的构建时,通过trunc ...
- 第15月第22天 libz.dylib
1. 3.在弹出的对话框中输入"cmd"+"shift"+"g" 4 4.输入/usr/lib https://jingyan.baidu. ...
- 简单透彻理解JSONP原理及使用
首先提一下JSON这个概念,JSON是一种轻量级的数据传输格式,被广泛应用于当前Web应用中.JSON格式数据的编码和解析基本在所有主流语言中都被实现,所以现在大部分前后端分离的架构都以JSON格式进 ...
- 【转】Python数据类型之“序列概述与基本序列类型(Basic Sequences)”
[转]Python数据类型之“序列概述与基本序列类型(Basic Sequences)” 序列是指有序的队列,重点在"有序". 一.Python中序列的分类 Python中的序列主 ...
- Pytorch入门之VAE
关于自编码器的原理见另一篇博客 : 编码器AE & VAE 这里谈谈对于变分自编码器(Variational auto-encoder)即VAE的实现. 1. 稀疏编码 首先介绍一下“稀疏编码 ...
- PCA主成分分析+白化
参考链接:http://deeplearning.stanford.edu/wiki/index.php/%E4%B8%BB%E6%88%90%E5%88%86%E5%88%86%E6%9E%90 h ...
- uoj#188. 【UR #13】Sanrd(Min_25筛)
题面 传送门 题解 这是一道语文题 不难看出,题目所求即为\(l\)到\(r\)中每个数的次大质因子 我们考虑\(Min\_25\)筛的过程,设 \[S(n,j)=\sum_{i=1}^nsec_p( ...
- 018_nginx_proxy死循环问题
今天线上遇到一个请求一次,触发多次的请求,而且直接把nginx机器压垮了.经排查,经过如下: 一. server{ server www.jyall.com; location /latestrele ...
- Expm 2_2 查找中项问题
对于长度为n的整型数组A,随机生成其数组元素值,然后实现一个线性时间的算法,在该数组中查找其中项. package org.xiu68.exp.exp3; import java.util.Array ...
- GitHub上README.md的简单介绍
1.编辑README文件 大标题(一级标题):在文本下面加等于号,那么上方的文字就变成了大标题,等于号的个数无限制,但一定要大于0 大标题 ==== 中标题(二级标题):在文本下面加下划线,那么上方的 ...