
Java课程设计之——爬虫篇
主要使用的技术
- Httplcient
- Jsoup
- 多线程
- dao模式
网络爬虫简介
网络爬虫(又称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者),是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。另外一些不常使用的名字还有蚂蚁、自动索引、模拟程序或者蠕虫。——摘自百度百科
网络爬虫分类
1. 通用网络爬虫
通用网络爬虫又称全网爬虫(Scalable Web Crawler),爬行对象从一些种子 URL 扩充到整个 Web,主要为门户站点搜索引擎和大型 Web 服务提供商采集数据。 由于商业原因,它们的技术细节很少公布出来。 这类网络爬虫的爬行范围和数量巨大,对于爬行速度和存储空间要求较高,对于爬行页面的顺序要求相对较低,同时由于待刷新的页面太多,通常采用并行工作方式,但需要较长时间才能刷新一次页面。 虽然存在一定缺陷,通用网络爬虫适用于为搜索引擎搜索广泛的主题,有较强的应用价值。
通用网络爬虫的结构大致可以分为页面爬行模块 、页面分析模块、链接过滤模块、页面数据库、URL 队列、初始 URL 集合几个部分。为提高工作效率,通用网络爬虫会采取一定的爬行策略。 常用的爬行策略有:深度优先策略、广度优先策略。
2. 聚焦网络爬虫
聚焦网络爬虫(Focused Crawler),又称主题网络爬虫(Topical Crawler),是指选择性地爬行那些与预先定义好的主题相关页面的网络爬虫。 和通用网络爬虫相比,聚焦爬虫只需要爬行与主题相关的页面,极大地节省了硬件和网络资源,保存的页面也由于数量少而更新快,还可以很好地满足一些特定人群对特定领域信息的需求。
聚焦网络爬虫和通用网络爬虫相比,增加了链接评价模块以及内容评价模块。聚焦爬虫爬行策略实现的关键是评价页面内容和链接的重要性,不同的方法计算出的重要性不同,由此导致链接的访问顺序也不同。
3. 增量式网络爬虫
增量式网络爬虫(Incremental Web Crawler)是 指 对 已 下 载 网 页 采 取 增 量式更新和只爬行新产生的或者已经发生变化网页的爬虫,它能够在一定程度上保证所爬行的页面是尽可能新的页面。 和周期性爬行和刷新页面的网络爬虫相比,增量式爬虫只会在需要的时候爬行新产生或发生更新的页面 ,并不重新下载没有发生变化的页面,可有效减少数据下载量,及时更新已爬行的网页,减小时间和空间上的耗费,但是增加了爬行算法的复杂度和实现难度。增量式网络爬虫的体系结构[包含爬行模块、排序模块、更新模块、本地页面集、待爬行 URL 集以及本地页面URL集。增量式爬虫有两个目标:保持本地页面集中存储的页面为最新页面和提高本地页面集中页面的质量。
4. Deep Web 爬虫
Web 页面按存在方式可以分为表层网页(Surface Web)和深层网页(Deep Web,也称 Invisible Web Pages 或 Hidden Web)。 表层网页是指传统搜索引擎可以索引的页面,以超链接可以到达的静态网页为主构成的 Web 页面。Deep Web 是那些大部分内容不能通过静态链接获取的、隐藏在搜索表单后的,只有用户提交一些关键词才能获得的 Web 页面。例如那些用户注册后内容才可见的网页就属于 Deep Web。 2000 年 Bright Planet 指出:Deep Web 中可访问信息容量是 Surface Web 的几百倍,是互联网上最大、发展最快的新型信息资源。Deep Web 爬虫体系结构包含六个基本功能模块 (爬行控制器、解析器、表单分析器、表单处理器、响应分析器、LVS 控制器)和两个爬虫内部数据结构(URL 列表、LVS 表)。 其中 LVS(Label Value Set)表示标签/数值集合,用来表示填充表单的数据源。
爬虫设计思路
这次是要设计基于学院的搜索引擎,所以一开始的话应该采用1或2。
通用网络爬虫设计思路

如图,通用爬虫就是使用深度或者广度搜索进行爬取,但是这种爬虫有一种缺点,就是深度不是很好控制,深度小了怕有遗漏,深度大了又怕过度浪费资源。而且还要对爬取到的链接进行解析,判断一下是不是自己想要的内容,判断是否是重复的URL,这一系列的操作导致的不仅仅是空间资源的浪费,在时间上也会耗费严重。一开始我是采用这种方法对学院官网进行爬虫的,每次爬取都需要几分钟的时间,大约三分钟吧。这还是没有去重的时间,所以后来我放弃了这种思路,决定采用先前学长的思路。
聚焦网络爬虫设计思路
实际上这也不完全是聚焦网络爬虫,因为我没有对爬取到的结果进行分析,这部分工作交给Elasticsearch去做了。
首先打开学院网站可以发现,每篇文章的url都有共通的特点:
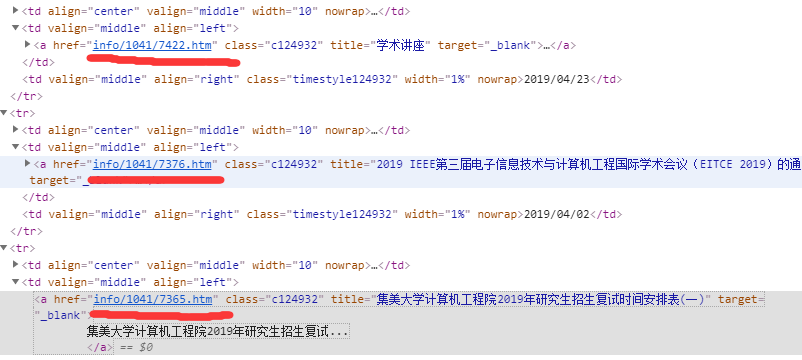
这部分我们可以使用一个正则表达式来匹配这个链接,但是这仅仅只是展示在首页的最新消息。观察可以发现每篇文章都有分类,而标题的菜单栏又有class样式

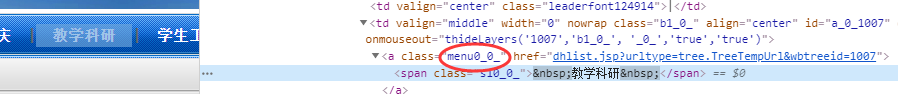
后来发现主页还有些这种url采用的不是这种class样式,我就直接用正则匹配了,多出来600多条数据
这种菜单url点进去后可以发现文章用的也是相同的class样式
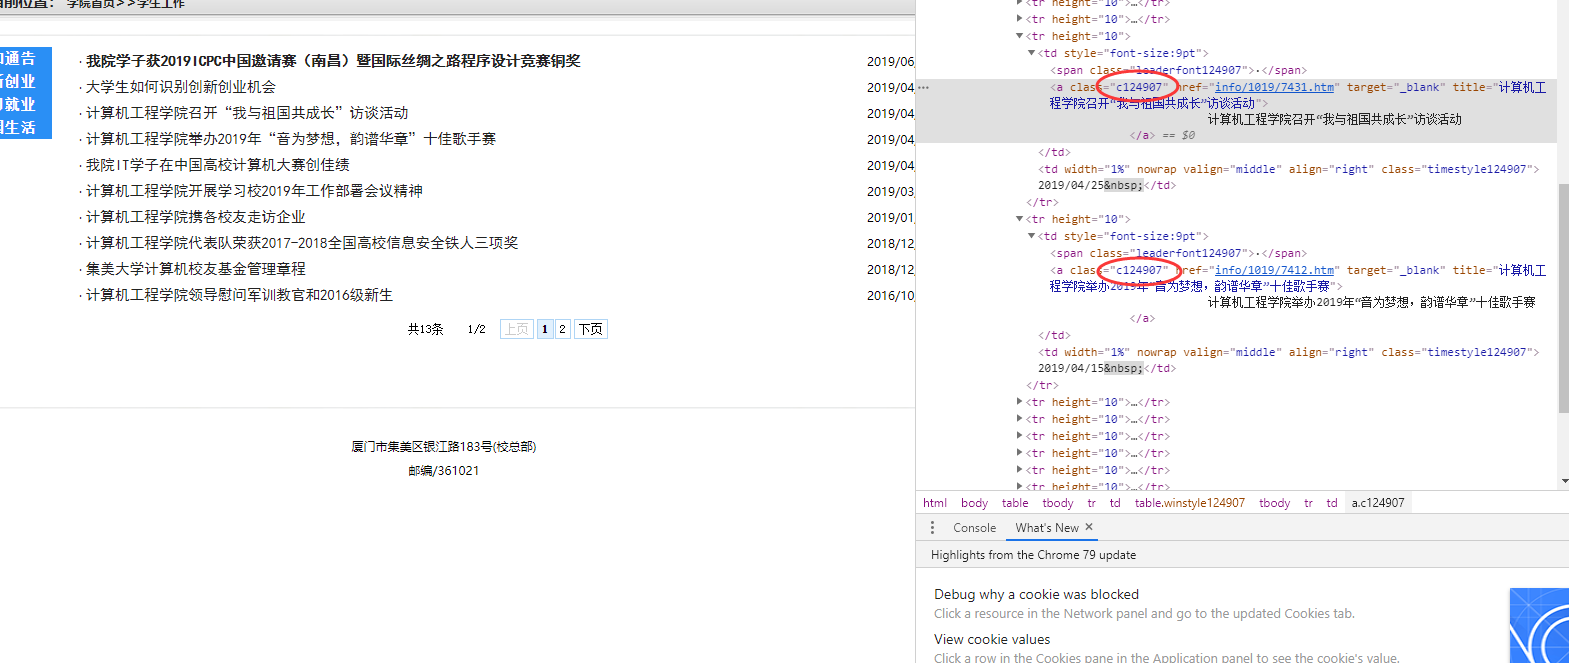
但是还有分页的文章是没办法直接在这个页面中直接获取的,学长是通过对url解析,得到总页数,然后放一个for进行迭代爬取。不过我发现了一个更好的方法,因为url中有个参数a2c是设置返回条数,也就是显示在页面上的条数的,只要给他一个很大的值就能全部显示了

代码实现(只展示关键代码)
因为考虑到爬虫可能不仅仅用于爬取URL,所以我用DAO模式设计了一个ResultWriterDao接口用于保存所需要的数据,然后实现爬虫功能的主要就两个类:
SingleCrawler.java: 对单个网页进行css解析,把页面的doc文档传入ResultWriterDao实现的类进行所需数据的保存,由于爬虫有多个线程,而ResultWriterDao只有一个,所以要对ResultWriterDao的写入方法加上synchronized。
UrlCollector.java: 利用SingleCrawler不断地迭代爬取。先获取菜单url,然后继续新建SingleCrawler线程进行文章url爬取,最后对文章的内容进行获取,存入ResultWriterDao。
ResultWriterDao.java
public interface ResultWriterDao{

	/**

	 *

	 * 用于数据保存的dao接口,在类的内部定义存储方式,使用write方法写入

	 * @param url 传入的网页的url

	 * @param doc 传入的网页的document对象,可用于保存title,正文,等等

	 */

	public void write(String url, Document doc);

	/**

	 * 得到保存的数据

	 * @return getLinks方法返回数据List

	 */

	@SuppressWarnings("rawtypes")

	public List getLinks();

}
SingleCrawler.java
for (Element link : links) {

	String newHref = link.attr("href");

	String httpPattern = "^http";

	Pattern p = Pattern.compile(httpPattern);

	Matcher m = p.matcher(newHref);

	if(m.find()){

		continue;

	}

	String newUrl = null;

	/**

	 *  判断href是相对路径还是决定路径,以及是否是传参

	 */

	if(newHref.length()>=1 &&  newHref.charAt(0)=='?') {

		newUrl = this.url.substring(0, this.url.indexOf('?')) + newHref;

	}

	else if(newHref.length()>=1 &&  newHref.charAt(0)=='/') {

		Matcher matcher = httpRegexPattern.matcher(this.url);

		if(matcher.find()) {

			String rootUrl = matcher.group(0);

			newUrl = rootUrl + newHref.substring(1);

		}

		else {

			continue;

		}

	}

	else if(newHref.length()>=1 &&  newHref.charAt(0)!='/'){

		Matcher matcher = httpRegexPattern.matcher(this.url);

		if(matcher.find()) {

			String rootUrl = matcher.group(0);

			newUrl = rootUrl + newHref;

		}

		else {

			continue;

		}

	}

	else {

    	continue;

	}

	this.linksWriter.write(newUrl, doc);

}
UrlCollector.java
爬取菜单URL
String url = "http://cec.jmu.edu.cn/";

String cssSelector = "a[href~=\\.jsp\\?urltype=tree\\.TreeTempUrl&wbtreeid=[0-9]+]";

List<String> menu = null;

List<String> list = null;

PoolingHttpClientConnectionManager cm = new PoolingHttpClientConnectionManager();

CloseableHttpClient httpClient = HttpClients.custom().setConnectionManager(cm).build();

LinksListWriter tempListWriter = new LinksListWriter();

/**

 * 1. 第一层是Menu,先把Menu的href爬取下来

 */

SingleCrawler menuCrawler = new SingleCrawler(url, cssSelector, httpClient, tempListWriter);

menuCrawler.start();

try {

	menuCrawler.join();

} catch (InterruptedException e) {

	e.printStackTrace();

}

menu = new ArrayList<String>(tempListWriter.getLinks());
爬取文章URL
这里开始使用到了多线程技术,爬取更快
SingleCrawler[] listCrawler = new SingleCrawler[menu.size()];

for (int i = 0; i < listCrawler.length; i++) {

	String menuUrl = menu.get(i);

	if(menuUrl.contains("?")) {

		istCrawler[i] = new SingleCrawler(menu.get(i)+"&a3c=1000000&a2c=10000000", "a[href~=^info/[0-9]+/[0-9]+\\.htm]", httpClient, tempListWriter);

		listCrawler[i].start();

	}

	else {

		listCrawler[i] = null;

	}

}
爬取文章内容
SingleCrawler[] documentCrawler = new SingleCrawler[list.size()];

for (int i = 0; i < documentCrawler.length; i++) {

	documentCrawler[i] = new SingleCrawler(list.get(i), "", httpClient, resultWriter);

	documentCrawler[i].start();

}
新旧对比
我将后端存储方式全部换成了ArrayList,在相同网络情况下进行JUnit测试,对比我的爬虫和学长相比看有没有提升:

可以看到运行时间相近,但是爬取得到的数据多了一倍,至此,爬虫设计完毕
Java课程设计之——爬虫篇的更多相关文章
- java课程设计之--Elasticsearch篇
一.团队课程设计博客链接 https://www.cnblogs.com/Rasang/p/12169899.html 二.个人负责模块或任务说明 2.1Elasticsearch简介 Elastic ...
- Java课程设计(2019版)
参考资料 Java课程设计参考资料(2018-12-26更新) Java课程设计常见问题(程序部署.数据库.JSP) 项目开发参考-阿里巴巴Java开发手册(正式版) 更多参考资料请查看QQ群文件中的 ...
- Java课程设计——博客作业教学数据分析系统(201521123084 林正晟)
#课程设计--博客作业教学数据分析系统(201521123084 林正晟) 1.团队课程设计博客链接 博客作业教学数据分析系统 2.个人负责模块或任务说明 学生登陆界面的前端实现和与数据库的连接 学生 ...
- Java课程设计——博客作业教学数据分析系统(201521123082 黄华林)
Java课程设计--博客作业教学数据分析系统(201521123082 黄华林) 一.团队课程设计博客链接 博客作业教学数据分析系统(From:网络五条狗) 二.个人负责模块或任务说明 1.网络爬虫 ...
- java课程设计团队博客《基于学院的搜索引擎》
JAVA课程设计 基于学院网站的搜索引擎 对学院网站用爬虫进行抓取.建索(需要中文分词).排序(可选).搜索.数据摘要高亮.分页显示.Web界面. 一.团队介绍 学号 班级 姓名 简介 2016211 ...
- Java课程设计-算术运算测试(D级) 齐鲁工业大学 计科20-1 王瀚垠 202003010033
Java课程设计-算术运算测试(D级) 齐鲁工业大学 计科20-1 王瀚垠 202003010033 目录 1.项目简介 2.项目采用技术 3.功能需求分析 4.项目亮点 5.项目功能架构图和UML类 ...
- java(课程设计之记事本界面部分代码公布)
代码:涉及记事本的一些界面......!! /* *java课程设计之记事本(coder @Gxjun) * 编写一个记事本程序 * 要求: * 用图形用户界面实现. * 能实现编辑.保存.另存为.查 ...
- java课程设计(计算器)
JAVA课程 设 计 报 告 1206401-18 瞿杰 一.设计时间 2013年6月 24日-----6月28日 二.设计地点 湖南城市学院实验楼计算机506机房 三.设计目的 1.巩固学习VB ...
- java课程设计--We Talk(201521123061)
java课程设计--We Talk(201521123061) 团队博客链接:http://www.cnblogs.com/slickghost/ 数据库 一.通过Dao模式建立与数据库的连接 1.数 ...
随机推荐
- Fluent算例精选|03利用VOF和蒸发-冷凝模型
通过学习本算例您将获得? 1.学会基本的VOF模型设置流程 2.学会利用蒸发-冷凝模型来模拟传热沸腾 目录 1摘要4 2传热沸腾模型介绍4 3前处理4 4求解设置5 4.1启动Fluent5 4.2网 ...
- Burpsuite被动扫描流量转发插件:Passive Scan Client
编译成品:链接: https://pan.baidu.com/s/1E0vsPGgPgB9bXCW-8Yl1gw 提取码: 49eq Passive Scan Client Burpsuite被动扫描 ...
- 【面试QA】Attention
目录 Attention机制的原理 Attention机制的类别 双向注意力 Self-Attention 与 Soft-Attention 的区别 Transformer Multi-Head At ...
- 【Excel使用技巧】vlookup函数
背景 前不久开发了一个运营小工具,运营人员上传一个id的列表,即可导出对应id的额外数据.需求本身不复杂,很快就开发完了,但上线后,运营反馈了一个问题,导出后的数据跟导出之前的数据顺序不一致. 经过沟 ...
- 【狂神说】JAVA Mybatis 笔记+源码
简介 自学的[狂神JAVA]MyBatis GitHub源码: https://github.com/Donkequan/Mybatis-Study 分享自写源码和笔记 配置用的 jdk13.0.2 ...
- shell脚本介绍以及常用命令
Shell脚本 Shell Script,Shell脚本与Windows/Dos下的批处理相似,也就是用各类命令预先放入到一个文件中,方便一次性执行的一个程序文件,主要是方便管理员进行设置或者管理用的 ...
- 装numpy 环境:python3.4+ windows7 +64位系统
机器学习实战python 因为图像处理的原因,初步学习机器学习,选用语言python,参考书籍<机器学习实战> 环境:python3.4+ windows7 +64位系统 首先,今天解决的 ...
- python之道15
请实现一个装饰器,限制该函数被调用的频率,如10秒一次(借助于time模块,time.time())(面试题,有点难度,可先做其他) 答案 # 思路 运行不能用 import time def wra ...
- 热点 | 近期Github热点项目库总结
整理 | Walker 介绍:你有没有想过你会成为一个艺术家,但无奈你不知道如何画画?得益于计算机视觉技术,你可以在ML社区轻松实现这个梦想.更棒的是,Github上ML社区的代码都是开源的! 这就是 ...
- 干货|Python基础入门 课程笔记(三)
目录 列表 元组 字典 三元表达式 一.列表 前面学习的字符串可以用来存储一串信息,那么想一想,如果现在有很多人,总不能每个人都起一个变量名把?那岂不得疯~ 咱们可以使用列表. (1)列表得格式和输出 ...